
剑桥大学冈维尔与凯斯学院餐厅中纪念费希尔的彩色玻璃窗(2006 年摄),图案是实验设计中的 7×7 拉丁方;窗由 Maria McClafferty 设计,1989 年安装。摄影:User:Schutz,来源:Wikimedia Commons,许可:CC BY-SA 2.5。

20 世纪 20 年代初,英国罗瑟姆斯特德试验站的下午茶桌旁,藻类学家缪丽尔·布里斯托尔坚称能尝出一杯奶茶是先倒奶还是先倒茶。统计学家罗纳德·费希尔后来把这类测试写进 1935 年的《实验设计》:8 杯茶、70 种分法,由此讲清零假设、随机化与精确检验。至于她当年究竟答对几杯,史料说法不一。
罗瑟姆斯特德的一次下午茶
费希尔 1919 年至 1933 年在伦敦以北哈彭登的罗瑟姆斯特德试验站(今 Rothamsted Research)任统计学家。按他女儿 Joan Fisher Box 在 1978 年传记中的记述,某天下午茶时,费希尔从茶水桶里接了一杯茶递给身旁的藻类学家 B. 缪丽尔·布里斯托尔博士。她谢绝了,说自己更喜欢先倒奶的那种。费希尔笑着说“胡说,肯定没区别”,她坚持说当然有。身后的威廉·罗奇提议“来测测她”,随即帮忙摆杯子,并欣喜地宣布她答对了足够多的杯子,证明了自己的说法。
这段记述留有明显空白。Box 只说事情发生在费希尔到站后不久,Richardson 据此认为应早于 1923 年 6 月 6 日布里斯托尔与罗奇结婚;具体日期、用了几杯茶、逐杯结果都没有记录。费希尔在书中既没点名,也没报告结果。流传更广的另一个版本来自 David Salsburg 2001 年的科普书《女士品茶》:它依据 H. Fairfield Smith 几十年后的口述,把场景放在 20 年代末的剑桥,并说那位女士每一杯都答对了。Kendall 在 1963 年的讣告里则写道,费希尔曾告诉他自己“从未做过”这个实验。
Richardson 2021 年在《Significance》上比对这些说法,认为 Box 的版本在地点、时间和经过上都更可信;按 Box 的说法,张罗测试的是罗奇,费希尔更像旁观者,这与 Kendall 的转述并不矛盾。他还提到,George Box 转述罗奇的话是她“几乎每杯都选对了”。如果当时用的正是书中“4 杯对 4 杯”的设计,她不可能只错一杯:把一杯先奶的认成先茶,必然还有一杯先茶的被认成先奶,而这种结果按费希尔自己的算法并不显著。由于当年的设计本身无据可查,这只能算推测。经得起核对的,是费希尔在书里留下的设计论证。
8 杯茶与 70 种分法
书中的设计是:调 8 杯奶茶,4 杯先倒奶、4 杯先倒茶,按随机顺序呈上。受试者事先知道总共 8 杯、每种 4 杯,任务是把它们分成两组各 4 杯。费希尔的第一步,是在动手之前列出所有可能结果,并事先决定每种结果如何解释。
从 8 杯中挑出 4 杯,依次挑选有 8×7×6×5 = 1680 种有序选法;同一组 4 杯有 4×3×2×1 = 24 种排列,所以不计顺序共有 1680 ÷ 24 = 70 种分法。毫无辨别力的人随便分,全部分对的机会是 1/70,约 1.4%。更一般地,用 k 表示她挑出的 4 杯“先奶”里真正先奶的杯数,在零假设下 k 服从超几何分布:
P(k) = C(4, k) × C(4, 4 − k) ÷ C(8, 4)
| 挑对的先奶杯数 k | 分法数 | 概率 | 至少这么好的概率 |
|---|---|---|---|
| 4(全对) | 1 | 1/70 ≈ 1.4% | 1/70 ≈ 1.4% |
| 3(两类各错 1 杯) | 16 | 16/70 ≈ 22.9% | 17/70 ≈ 24.3% |
| 2 | 36 | 36/70 ≈ 51.4% | 53/70 ≈ 75.7% |
| 1 | 16 | 16/70 ≈ 22.9% | 69/70 ≈ 98.6% |
| 0(全错) | 1 | 1/70 ≈ 1.4% | 70/70 = 100% |
表里最后一列是关键。若她两类各错一杯,这一结果本身出现的概率是 16/70,已超过 20%;费希尔进一步强调,判断显著性时还要把比观察结果更好的情形算进去,即 16/70 + 1/70 = 17/70,约 24.3%。他的理由很直观:假如“错一杯”只有 1 种分法,“全对”却有 16 种,那么“错一杯”虽然罕见,也不能算显著,因为单凭运气拿到更好的成绩反而更常见。这就是今天 p 值“等于或更极端”的含义。按当时惯用的 5% 标准,8 杯设计下只有全对才算显著。
费希尔接着说明,实验的规模和结构决定了它能检测到多弱的辨别力。只用 6 杯(每种 3 杯)时,全对的概率是 1/20,即 5%,要忽略概率达到 1/20 的结果,就没有任何结果能过关,实验等于白做。扩大到 12 杯(每种 6 杯),全对的概率是 1/924,两类各错 1 杯有 36 种分法,合计 37/924,约 4.0%,错了两杯仍可算显著。把 8 杯实验重复 10 次,只要至少 2 次全对,同样低于 5%(按二项分布计算约 0.85%)。改成每杯掷硬币决定先倒什么,全对的概率降到 1/256,错一杯也只有 8 种情形,同样 8 杯更敏感;但费希尔仍倾向固定 4 对 4,因为掷硬币可能让 8 杯全是同一种,既让受试者困惑,也剥夺了她相互比较的机会。反过来,5 杯对 3 杯的不等分设计全对概率是 1/56,敏感度反而下降。
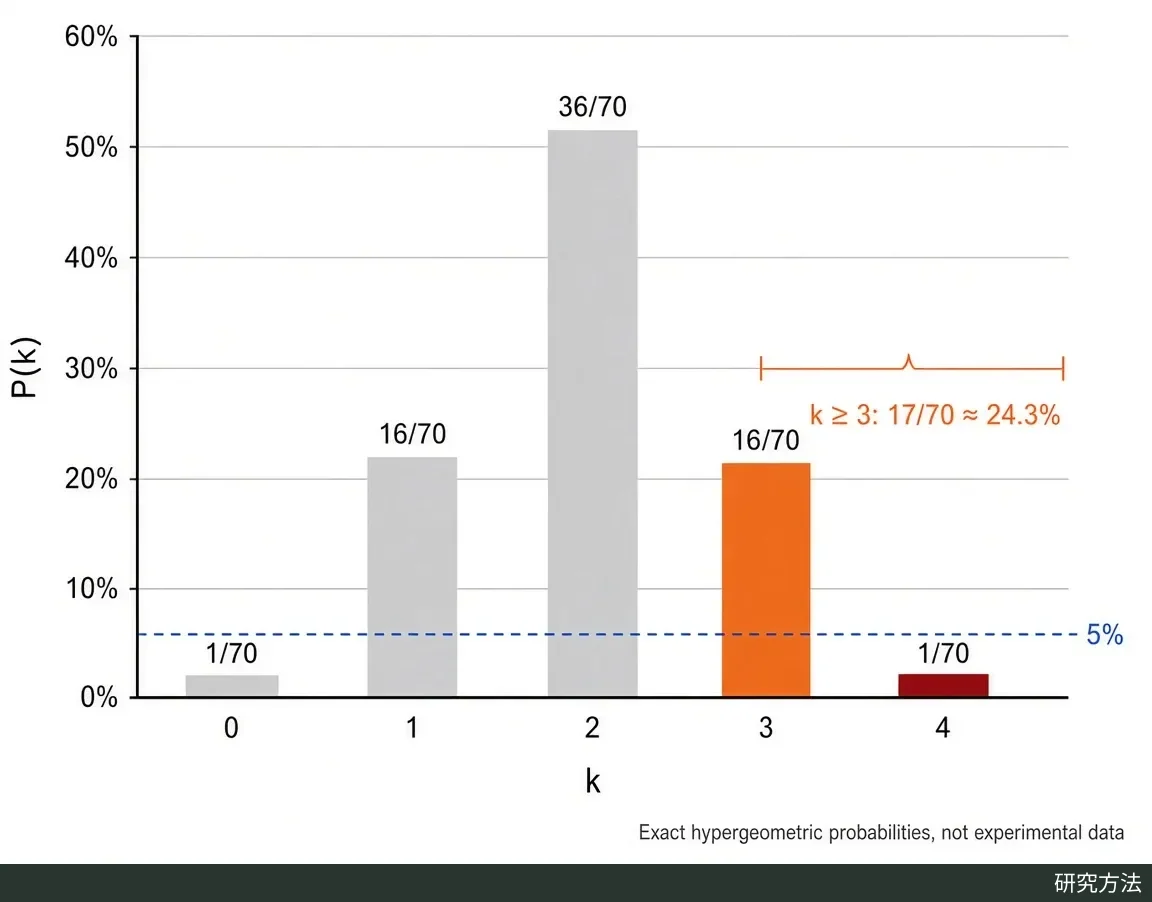
8 杯(4 杯对 4 杯)设计下,零假设为真时挑对先奶杯数 k 的概率分布,橙红色为 k ≥ 3 的尾部,虚线为 5% 参考线。数值按超几何分布精确计算,非实验数据;柱高为示意,读数以标注分数为准。AI 生成示意图。
零假设与随机化
费希尔把被检验的那个假设命名为“零假设”(null hypothesis),在这里就是“她的判断完全不受加料顺序影响”。他写道,零假设“从未被证明或确立,只可能在实验过程中被推翻”;“每个实验存在的意义,可以说只在于给事实一个推翻零假设的机会”。
为什么不直接检验“她能分辨”?费希尔的回答是:这个命题不精确,“能分辨”到什么程度没有说清,就算不出各种结果的概率分布。“她永远不会出错”倒是精确的,但一次失误就能推翻它,有限次实验却永远证明不了它。零假设必须精确、没有歧义,因为显著性检验就是在它给出的分布上计算的。他还明确表示,所谓“第二类错误”在这种简单显著性检验中没有意义,因为能用的期望全部来自零假设为真。
另一个要点是随机化。费希尔举例说,如果先倒奶的 4 杯恰好都加了糖,她只要按甜不甜分组,全部分对的频率就不再是 1/70,而是 35/70,检验彻底失效。要求“所有杯子除先后外完全一样”也行不通:杯壁厚薄、奶量多少、茶汤浓淡、入口温度总会有差别,干扰因素也列举不完。他的办法是:设想这些干扰在每一杯上都已经固定,然后严格随机地指定哪 4 杯先倒奶。无论干扰多大,任何一组 4 杯被指定为“先奶组”的概率都恰好是 1/70,她在零假设下分对的概率也就严格等于 1/70。换句话说,随机化保证检验有效;统一茶叶、统一牛奶这类精细控制不影响有效性,只影响敏感度,也就是真有辨别力时能不能显现出来。
从茶杯到 2×2 表:精确检验及其边界
把品茶结果写成一张 2×2 表:行是实际做法(先奶、先茶),列是她的判断,四个边际合计都事先定为 4。边际固定后,整张表只由左上角一格决定,这一格在零假设下的分布正是上面的超几何分布。这套做法今天通称“费希尔精确检验”。所谓“精确”,是指直接枚举零假设下所有可能表格的概率,而不借助大样本下的卡方近似。
费希尔在 1935 年发表于《皇家统计学会杂志》的论文《归纳推理的逻辑》中,用一组真实数据演示了同样的计算。朗格(Lange)对罪犯双胞胎的研究里,13 对被判为同卵的双胞胎中,罪犯的孪生兄弟有 10 例也被定罪;17 对异卵双胞胎中只有 2 例:
| 孪生兄弟也被定罪 | 未被定罪 | 合计 | |
|---|---|---|---|
| 同卵 | 10 | 3 | 13 |
| 异卵 | 2 | 15 | 17 |
| 合计 | 12 | 18 | 30 |
以边际为条件,费希尔算出至少这样不成比例的结果出现的频率“恰好是 6,653,325 次中的 3,095 次,约 2,150 次一次”(约 0.00047),并写道这一检验“直接,且对小样本精确”。值得留意的是他给出的前提:“假定数据准确、同质且未经挑选”。显著性只回答“机遇能不能解释这种差异”,回答不了样本是否经过挑选,也回答不了差异来自遗传还是环境。
精确检验也有边界。其一是离散:8 杯设计里,“至少这么好”的概率只能取 1/70、17/70、53/70、69/70 和 1 这五个值,以 5% 为门槛时,零假设为真却被判显著的实际概率只有约 1.4%,检验偏保守。其二是以边际为条件:品茶实验两组边际都由设计固定,而许多现实研究只固定一组,甚至两组都不固定。Richardson 提到,Barnard 1947 年据此把 2×2 表分成三种模型;后两种情形是否仍应以边际为条件,统计学界看法不一。其三,费希尔自己说得最透:即便接受把 1/70 的事件视为显著,也等于承认“没有任何孤立的实验,无论本身多么显著,足以从实验上证明一个自然现象”;说一个现象可被实验证明,是指“我们知道如何开展一个很少不给出显著结果的实验”。
回到那张茶桌:布里斯托尔究竟答对几杯,大概已无法核实。但费希尔借这个场景把一次实验要做的事排好了顺序:先写出精确的零假设,再用随机化让机遇成为唯一的对照,并在实验之前算清每种结果在零假设下有多常见。