
把“是否复现”拆成后验概率:一个统一的贝叶斯复现性框架
研究者在生物安全柜内用多道移液器向 96 孔板分装试剂。图:Siduduziwe Nxumalo,来源:Wikimedia Commons,许可:CC BY-SA 4.0。

2026 年 10 月 9 日,帕多瓦大学与丹娜—法伯癌症研究所的三位研究者在 arXiv 发布预印本《The Quantification of Replicability》。论文用一个贝叶斯分层模型同时回答四类“是否复现”的问题,把结论报告为效应落入“实际相关区间”的后验概率,而不是“成功/失败”的二元判决。该文目前尚未经过同行评议。
复现指标的碎片化
“复现”听上去是个是非题,实际算法却五花八门。美国国家科学院 2019 年把可复现性(replicability)定义为“针对同一科学问题、各自收集数据的研究得到一致结果”,但“一致”怎么算并无共识。Heyard 等人 2025 年在《皇家学会开放科学》发表的范围综述,从 49 个大型复现项目和 97 篇方法学论文中整理出 50 种复现指标,其中 37 种基于明确的公式或统计模型。今年 4 月发表于《自然》的社会与行为科学复现研究(Tyner 等)对 164 篇论文中的 274 项主张做了复现,151 项(55.1%)在原方向上显著;该研究同时报告了 13 种二元判定标准,据 Alongi 等人引述,各标准下的成功率在 28.6% 到 74.8% 之间。同一批数据,换一个标准,结论就能差出一倍多。
Alongi 等人把现有做法的问题归纳为三点:多数指标检验的是一个点假设(例如效应恰好为零),而不是“效应小到可以忽略”的区间;连续的证据常被压成“成功/失败”;比较停留在观测估计值的层面。最后一点的影响最直接:一项功效不足的研究会被直接判为“未复现”,而两个估计值相近,也说不清它们是抓住了同一个真实效应,还是重复了同一种误差。
论文开头的玩具例子很直观。设两个“课题”各有两项样本量均为 25 的研究,门槛 ε 取 0.1。课题 1 中一项研究很精确,效应超过门槛的后验概率为 1.0,另一项噪声大,概率只有 0.50;课题 2 的两项研究都嘈杂但彼此相近,概率分别为 0.88 和 0.83。只看单项研究,会说课题 1 没复现、课题 2 复现了;只看合并后的共同效应,两个课题超过门槛的概率几乎相同(0.81 与 0.80);只看研究间异质性,两者也差不多(后验均值 0.60 与 0.49)。三种视角各丢一块信息:课题 1 的分歧更像是一项测量不精确的研究造成的,而不是效应本身不稳定,这决定了下一步该补做研究,还是该承认效应因情境而异。
一个分层模型与四类复现问题
新框架的核心是一个分层回归:每项研究有自己的截距、效应和残差尺度,三者都从各自的“超总体”分布中抽出,分布取自由度为 3 的 Student-t,以容纳较厚的尾部。效应分布的中心 β 被称为“生成效应”,代表所有研究共同指向的那个效应;τ_β 刻画研究之间的异质性。τ_β 越接近 0,越像同一总体内的严格复现;越大,越像换了人群或条件的“扩展研究”。作者把二者看作一条连续谱,而不是非此即彼的两类。
第二个要素是“实际相关区域”:研究者事先给出门槛 ε,效应绝对值不超过 ε 视为与零实际等价,超过则视为有实际意义。ε 的设定思路与等效性检验中的“最小关注效应量”或医学上的“最小临床重要差异”相同。所有指标都是 MCMC 后验抽样中满足某个事件的比例,换一个 ε 只需重算,不必重新拟合模型。
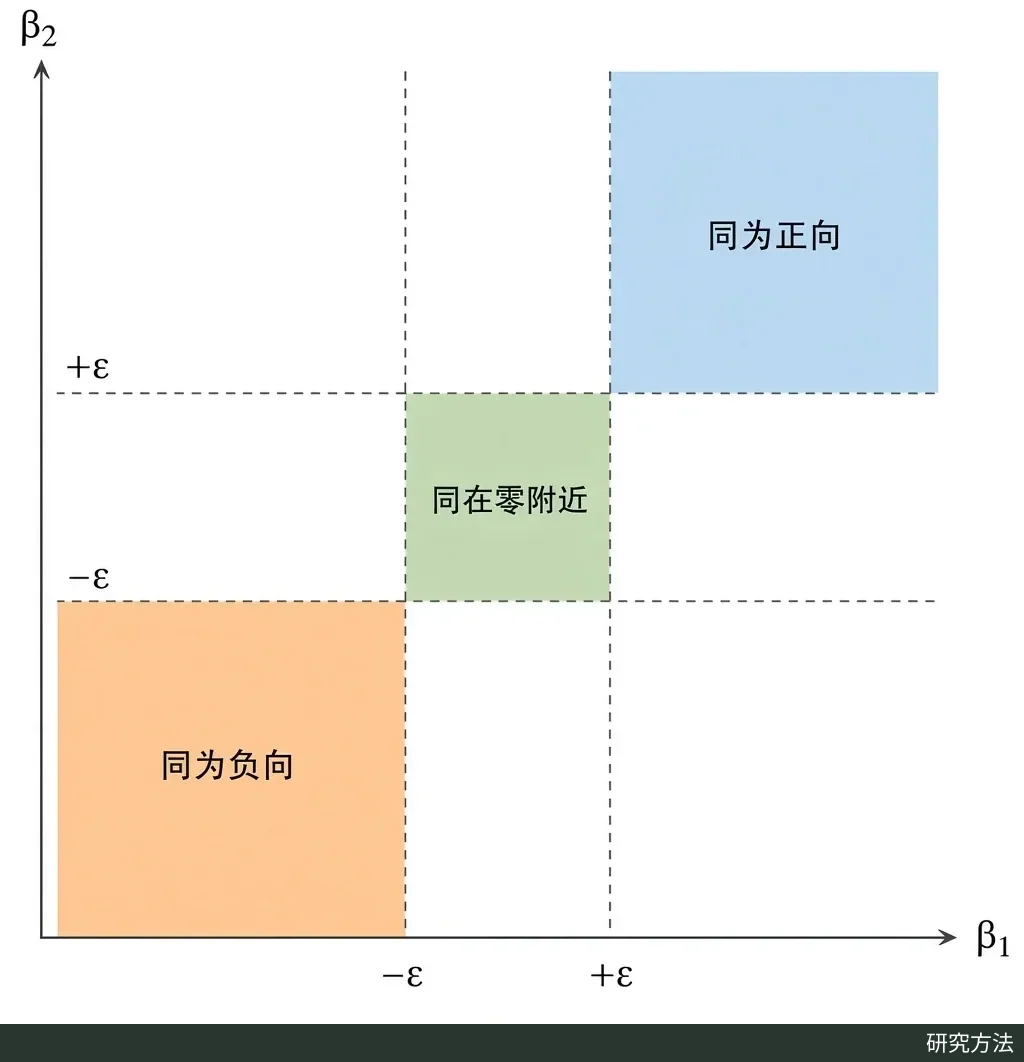
两项研究的效应同时落在右上(同为正向)、左下(同为负向)或中央(同在零附近)三块区域之一即视为一致,三块的后验概率之和就是总体一致概率。据 Alongi 等(2026)图 3 逻辑重绘,AI 生成示意图。
同一个拟合好的模型被用来回答四类问题:
- 研究之间是否一致(横向复现):至少 k 项研究的效应同时高于 ε、同时低于 −ε 或同时落在零附近的概率;也可以以某项研究为参照,计算“它发现的效应在其他研究中再次出现”的条件概率。
- 各研究与生成效应是否一致(纵向复现):研究效应与生成效应同处一个区域的概率。生成效应接近零时,配套的条件概率能区分“各研究效应都很小”和“几项大效应方向相反、相互抵消”这两种截然不同的情况。
- 已有证据能否预测新研究:留出一项研究,用其余研究预测它的效应并与实际估计比较;或用全部研究预测一项尚未开展的研究出现实际相关效应的概率,供规划新研究参考。
- 生成效应本身是否有实际意义:生成效应绝对值超过 ε 的后验概率。
结构上最接近的已有方法是 Pawel 和 Held 2020 年提出的复现研究概率预测。作者列出三处差别:Pawel 和 Held 使用已发表的汇总统计量,新框架使用每项研究的个体数据,因而截距和残差尺度也能分层建模;前者把异质性固定为预设值再做敏感性分析,后者给异质性设置先验;前者在预测时把生成效应积分掉、在估计值层面判断兼容性,后者保留生成效应作为推断对象,在参数空间里比较。作者强调,新意不在分层模型本身,而在于用同一个模型、同一族指标回答原本要靠不同工具分别处理、结论还可能互相矛盾的问题。
GTEx 案例与模拟证据
实证部分使用基因型—组织表达项目(GTEx)的数据,考察变异 rs4731702 对皮下脂肪中 KLF14 基因表达的影响。KLF14 附近的变异与 2 型糖尿病和高密度脂蛋白胆固醇相关,而这一调控效应过去几乎只在欧洲祖源人群中刻画过。作者把 628 名同时有全基因组测序(v8)和脂肪组织 RNA 测序(v10)的捐赠者按自报祖源分为三组,当作三项“研究”:非裔美国人 78 人、欧裔美国人 531 人、其他 19 人(12 名亚裔与 7 名西班牙裔/拉丁裔合并)。门槛取基线表达的 10%,即 ε=0.86,约相当于每多一个等位基因原始计数变化 21%。先验用经验贝叶斯从 227 对与目标相似的“变异—转录因子”组合中估计,目标组合本身不在其中。作者也说明,组间差异只代表在这个标记位点上测得的效应,可能源于不同人群的连锁不平衡差异,不等于调控机制不同。
结果显示,生成效应具有实际意义的后验概率只有 0.27。欧裔组效应的后验均值为 0.93(95% 可信区间 0.53 至 1.31),高于门槛;非裔组 0.50(−0.57 至 1.25)和其他组 0.63(−0.44 至 1.49)落在门槛以内,但区间很宽。三组效应同处一个区域的概率为 0.43;放宽到“三组中至少两组一致”后升到 0.99,但作者提醒,这一指标的先验值本就约为 0.96,数据几乎没有带来新信息。以最大的欧裔组为参照,当它显示实际相关效应时,至少另一组予以印证的概率约为 0.50。在生成效应落在零附近的抽样中,至少两组也落在零附近的条件概率为 0.84,说明“生成效应偏小”来自各组效应普遍偏小,而不是正负大效应相互抵消。用三组预测一项新研究,其效应具有实际意义的概率为 0.38。
敏感性分析显示,部分指标对异质性先验相当敏感。把 τ_β 先验的中位数从经验先验的第 10 百分位调到第 90 百分位,生成效应具有实际意义的概率从 0.44 降到 0.22,以欧裔组为参照的印证概率从 0.79 降到 0.41。作者还给出“独立极限”下的对照:把各异质性尺度固定在先验的第 99.9 百分位,相当于各组互不借力。此时非裔组效应的后验均值变为 −0.29,以它为参照的印证概率从分层模型下的 0.90 跌到 0.22。也就是说,分层模型给出的一部分“一致”,来自把小样本组拉向共同效应的收缩。
模拟沿用三组的样本量和基因型频率,每次只改变效应、截距或残差尺度中一项的异质性(分别取先验的第 10、50、90 百分位),每种设定模拟 30 个数据集。效应异质性增大时,各项指标按预期变化;截距和残差尺度的异质性变化时,关于效应的复现指标基本不变。需要说明的是,这些证据由一个案例和一组围绕该案例设定的模拟构成,作用是展示指标怎么读、如何随异质性变化;论文没有在大型复现项目的数据上把新指标与既有指标并排比较。
适用边界
首先,这一框架需要每项研究的个体数据。多数复现评估只能拿到已发表的效应量和标准误,此时无法直接套用;在多中心试验、多实验室复现或 GTEx 这类大型队列中才最顺手。作者认为,多实验室的注册报告(研究问题与分析方案在收集数据前先经同行评审)是它天然的前瞻性应用场景。
其次,指标中混有收缩效应。研究规模悬殊时(如本例的 531 人对 19 人),小研究的后验在很大程度上由大研究和 τ_β 的先验决定,作者建议同时报告独立极限下的指标,以分清哪些一致来自数据、哪些来自模型借力。研究很少时,异质性先验也难以确定:本例借助基因组中大量同类调控关系做经验贝叶斯,许多领域没有这样现成的“同类池”,而且这里的同类池与分析使用的是同一批捐赠者。
再次,门槛 ε 最好独立于数据设定。本例找不到与测量尺度可比的外部锚点,只能把 ε 与估计出的基线表达挂钩;为此,作者在代码仓库中提供了不依赖门槛的汇总,如研究间效应差值的后验分布。最后,模型假设各研究可交换地来自同一超总体,研究数量多时可能出现聚类;发表偏倚也没有纳入,用于已发表文献时需要在生成模型中加入选择机制。论文示例只涉及单个回归系数,多研究、多参数的完整扩展留待后续工作。分析代码与一份合成数据集公开在 GitHub 上,论文未提及打包发布的软件。