
把十几项研究的结果合成一个数,是元分析最常见的做法;但合并之前得先回答一个问题:这些研究估计的是同一个效应,还是一族彼此相关却不尽相同的效应?前者对应固定效应模型,后者对应随机效应模型。本文借 13 项卡介苗试验的数据,讲清两种模型的思路、异质性指标 I² 与森林图的读法,以及常见误用。
固定效应与随机效应:两种合并假设
单项研究的样本有限,不同研究的结论又常常互有出入。元分析的做法是先从每项研究提取同一尺度的效应估计(如对数风险比、均值差)及其标准误,再按精度加权平均。Cochrane 手册把最常用的做法称为逆方差法:每项研究的权重等于其方差(标准误的平方)的倒数,越精确的研究分量越重。不过,加权平均只是一步计算,这个平均数代表什么,要看我们怎样看待研究之间的差异——固定效应模型与随机效应模型正是在这里分道扬镳。
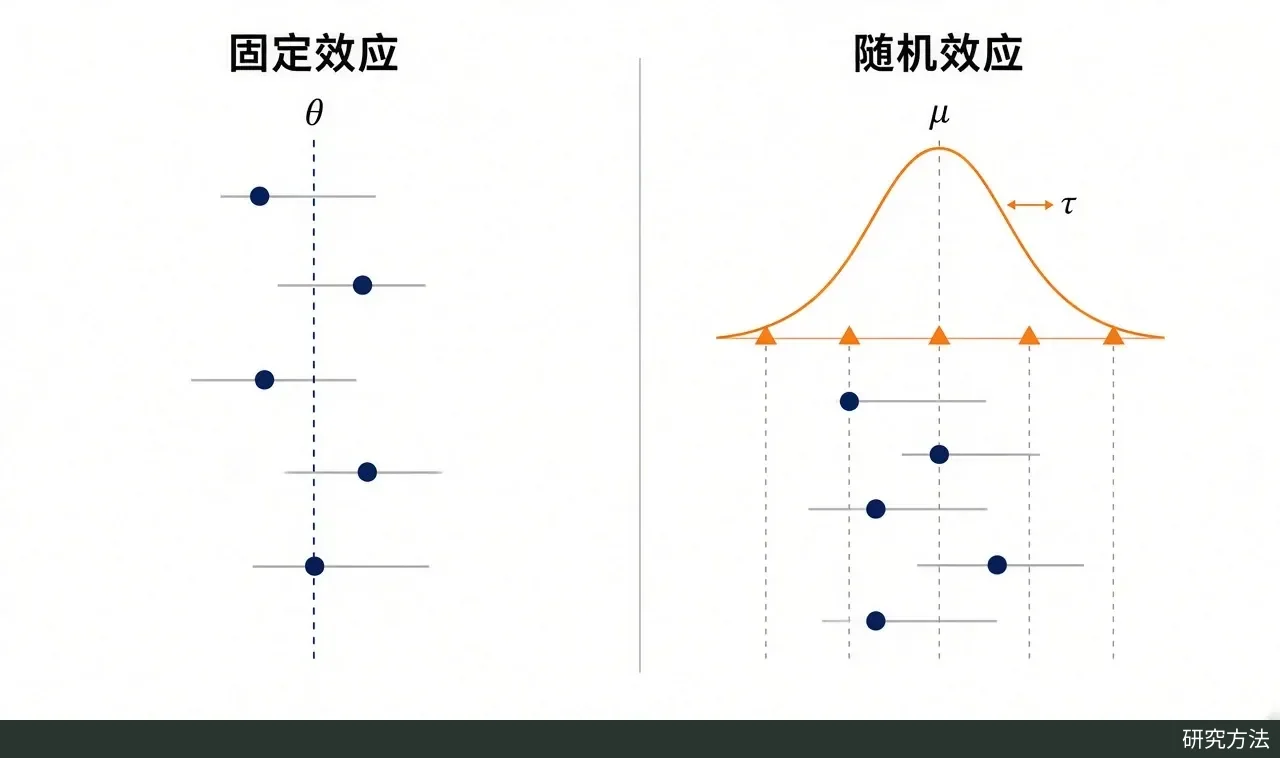
固定效应模型(也称共同效应模型)假设所有研究估计的是同一个真实效应 θ,各研究结果之所以不同,完全是抽样误差所致。打个比方:十个人用精度不同的温度计测同一锅汤,读数有高有低,但汤只有一个温度,把读数按温度计的精度加权平均,就是对它的最好估计。此时第 i 项研究的权重 wᵢ = 1/vᵢ(vᵢ 为研究内方差),大样本研究的权重会非常突出。Cochrane 手册也提到,另有学者主张在存在异质性时,仍可把固定效应结果解释为各研究效应的一种加权平均;但无论采用哪种解释,它都忽略了研究间的差异,必须配合异质性评估一起报告。
随机效应模型则假设各研究的真实效应 θᵢ 本身就不相同,它们来自一个以 μ 为中心、方差为 τ²(研究间方差)的分布,通常取正态分布。还用汤来比:这回是十家餐馆按同一份菜谱各煮一锅,每锅的真实温度本来就有差别,我们想知道的是这份菜谱煮出来的平均温度,以及各锅之间相差多少。于是每项研究的观测方差变成 vᵢ + τ²,权重变为 1/(vᵢ + τ²)。τ² 越大,各研究的权重越接近,小研究的相对分量随之上升。DerSimonian 与 Laird 1986 年提出了估计 τ² 的简单非迭代方法;Cochrane 手册指出,后来的其他估计方法统计性质更好,RevMan 自 2024 年起也提供了限制性最大似然(REML)估计。
Borenstein 等 2010 年的入门文章强调,两种模型的公式相似、有时结果也接近,但代表的是根本不同的假设,也决定了结果该怎样解释:固定效应给出“那一个共同效应”的估计,随机效应给出“效应分布的均值”。没有异质性时二者结果相同;只要存在异质性,随机效应的置信区间就更宽。需要注意,随机效应的置信区间只描述均值 μ 的不确定性,并不描述效应在研究之间散布得多宽。要表达后者,Cochrane 手册建议报告预测区间,约为 μ ± t(k−1)·√(τ² + SE(μ)²),其中 k 为研究数,t(k−1) 为自由度 k−1 的 t 分布 97.5% 分位数;手册建议在研究数较多(例如五项及以上)且漏斗图无明显不对称时使用。
异质性的度量:Q、I² 与森林图
判断研究间是否存在超出抽样误差的差异,传统做法是 Cochran 的 Q 检验:Q = Σ wᵢ(yᵢ − θ̂)²,其中 yᵢ 为各研究的效应估计,θ̂ 为固定效应合并估计;在“无异质性”的原假设下,Q 近似服从自由度为 k−1 的卡方分布。它的毛病是对研究数很敏感:研究少、样本小时检验功效低,不显著并不等于没有异质性;研究很多时,又可能把临床上无关紧要的小差异判为显著。
为此,Higgins 与 Thompson 2002 年提出用 I² 描述异质性对元分析的影响:I² = (Q − df)/Q × 100%,结果为负时记为 0,df = k−1。它表示效应估计的总变异中,由研究间真实差异而非抽样误差造成的比例,不依赖研究数和效应尺度。次年 Higgins 等在 BMJ 撰文向临床读者介绍这一指标,Cochrane 系统综述也开始报告 I²。Cochrane 手册给出的随机对照试验元分析粗略参考是:0%–40% 可能不重要,30%–60% 可能为中度异质性,50%–90% 可能为较大异质性,75%–100% 为相当大的异质性。这几个区间刻意相互重叠,手册同时强调要结合效应的大小与方向、异质性证据的强弱一起判断;研究很少时,I² 本身的不确定性就很大。
要记住,I² 是一个比例,而不是差异的绝对量。Borenstein 等 2017 年专门撰文指出:告诉你 I² 是 50%,你无从知道各研究的效应是在 40 到 60 之间,还是在 10 到 90 之间。原因在于 I² 的分母里包含研究内的抽样误差:研究间差异 τ² 不变,各研究越大、越精确,I² 就越高。想让读者知道效应实际会落在什么范围,应直接报告 τ 或预测区间。
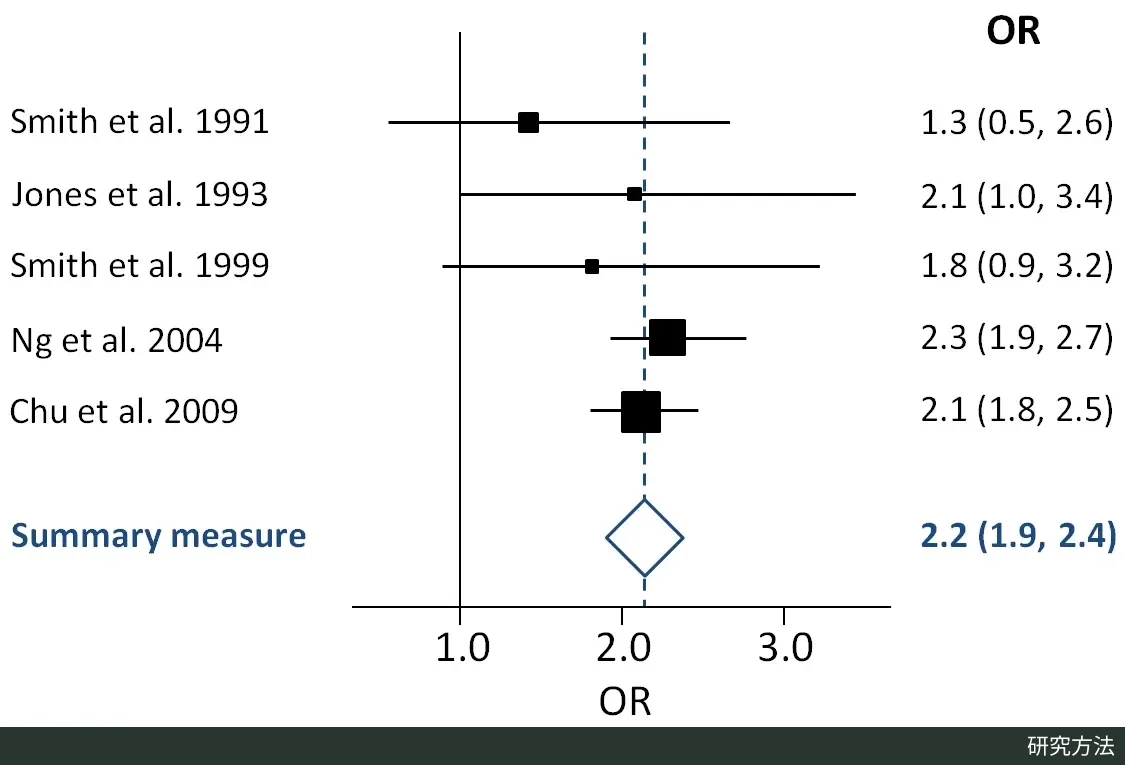
森林图是元分析结果最常见的呈现方式。按 Cochrane 手册的说明,每项研究占一行:方块位于点估计处,横线表示其置信区间(通常为 95%),方块面积代表该研究在合并中的权重;底部的菱形是合并结果,中心为合并估计,左右两端为其置信区间。读图可以分三步:先看各条横线是否大致重叠,重叠差通常意味着存在统计异质性;再看它们与“无效线”(风险比、比值比等比值指标为 1,均值差等差值指标为 0)的相对位置;最后比较方块大小,弄清是哪几项研究主导了合并结果。Cochrane 综述的森林图还会在下方标注异质性检验结果和 I²。
实例:13 项卡介苗试验
卡介苗(BCG)预防结核病的 13 项对照研究是元分析教学中的经典数据,原始汇总来自 Colditz 等 1994 年发表于 JAMA 的元分析,R 数据包 metadat 将其收录为 dat.bcg:每项研究给出接种组与未接种组的结核病例数和未患病人数,发表年份从 1948 年到 1980 年。以对数风险比为效应量,两种模型的主要结果见下表。其中固定效应结果和两种模型下的研究权重由本文依据该数据表按逆方差法复算(随机效应权重使用 τ² = 0.313),随机效应的合并估计与预测区间取自 metadat 文档中 metafor 软件的 REML 输出。
| 指标 | 固定效应(逆方差) | 随机效应(REML) |
|---|---|---|
| 合并风险比(95% 置信区间) | 0.65(0.60–0.70) | 0.49(0.34–0.70) |
| 最大研究 TPT Madras(1980)的权重 | 约 41% | 约 10% |
| 最小研究 Comstock & Webster(1969)的权重 | 约 0.3% | 约 3.8% |
| 95% 预测区间(风险比) | — | 0.15–1.55 |
这组数据的异质性非常明显:Q = 152.2(自由度 12,p < 0.0001),按 Q 计算的 I² 约为 92%(metafor 依据 REML 估计的 τ² 报告为 92.22%),τ² 估计为 0.313。画成森林图,就是各研究的横线明显错开:Ferguson & Simes(1949)、Hart & Sutherland(1977)等研究的风险比点估计在 0.2 左右,TPT Madras(1980)则约为 1.01,几乎没有观察到保护效应。
两种模型的结果差出这么多,原因在权重。固定效应模型里,TPT Madras 与 Stein & Aronson(1953)两项大研究合计约占 65% 的权重,合并结果因此被拉向 1。随机效应模型加入 τ² 后,各研究的权重被拉平,合并风险比降到 0.49,置信区间也明显变宽。但更值得报告的是预测区间:0.15–1.55 跨过了 1,意味着在与这些研究相似的新场景中,卡介苗的真实效果可能从大幅降低风险一直到看不出保护作用。只报告“平均风险比 0.49”,就把这种差别藏起来了。
如此高的异质性提示应该追问差异从何而来,而不是换个模型就收工。metadat 文档中的示例以研究地点的绝对纬度和发表年份为调节变量做元回归,剩余 I² 降到约 72%,两个变量合计解释了约 65% 的研究间方差;但文档同时提醒,这两个变量高度相关(相关系数约 −0.66,越晚的研究越靠近赤道),结果难以拆开解释。
使用前提与常见误用
使用前提可以归纳为三条。第一,研究在参与者、干预、对照和结局上要足够相似,合并才有意义。Cochrane 手册用“苹果和橘子”作比:如果关心的是“水果”这个更宽的问题,把二者合并也许合理;如果苹果和橘子各有独立的意义,硬合并就会得出误导性的结果。第二,每项研究要能提供同一尺度的效应估计及其标准误,并且通常要求各估计彼此独立。第三,随机效应模型一般假设真实效应服从正态分布,这一假设很难验证;研究很少或事件很少时,τ² 估计得很差,手册指出此时固定效应方法对平均效应的估计反而更稳健,代价是忽略异质性。
常见误用包括:
- 按异质性检验结果选模型。“Q 检验显著就用随机效应,不显著就用固定效应”很常见,但 Cochrane 手册明确写道,固定效应与随机效应之间的选择绝不应基于异质性的统计检验,而应依据对各研究是否在估计同一效应的判断事先确定。
- 把 I² 当作差异的绝对大小,机械套用阈值。 I² 只是比例;研究间差异不变时,研究越精确,I² 越高。应同时报告 τ² 或预测区间。
- 以为随机效应模型“解决”了异质性。 手册强调,随机效应模型并不会让异质性不再成为问题,它主要用于无法解释的异质性;条件允许时仍应借助事先设定的亚组分析或元回归探讨来源。
- 只报告随机效应的合并估计和置信区间。 研究很多时,即便异质性很大,均值的置信区间也可能很窄;不给出预测区间,读者容易误以为各研究的效应很一致。
- 忽视小研究效应。 如果小研究的结果系统性地不同于大研究(例如受发表偏倚影响),随机效应模型给小研究更多权重,会放大这种偏倚;此时两种模型都有问题,宜做敏感性分析。
- 异质性一高就剔除“离群”研究。 按结果删研究可能引入偏倚。手册建议先核查数据是否录错(例如把标准误误录成标准差),再做包含与不包含该研究的敏感性分析。