
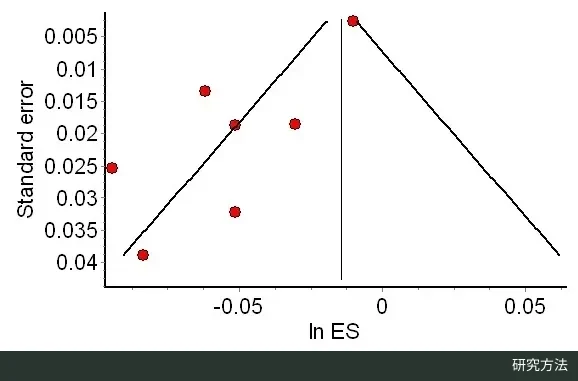
漏斗图把各项研究的效应量与精度画在一起:没有发表偏倚时,点应围绕合并效应左右对称地散开;若不显著的小样本研究缺席,图形就会偏向一侧。不对称也可能来自小研究效应等其他原因。图:Sardmeta1,用 MetaXL 绘制,来源 Wikimedia Commons(File:Funnel plot depicting asymmetry Sept 2015.jpg),许可 CC BY-SA 3.0。
2026 年 9 月 30 日,R 包 PublicationBiasBenchmark 0.3.0 发布到 CRAN,为这套发表偏倚校正方法的公开模拟基准新增 RTMA、MAN、MMPH 三种方法。基准网站汇总的 1665 个模拟条件显示,MMPH 的 RMSE 平均名次排第三;但包括新方法在内,没有一种方法的平均 95% 区间覆盖率超过 80%。
0.3.0 版的新增内容
PublicationBiasBenchmark 由阿姆斯特丹大学心理学方法系的 František Bartoš 维护,合作者为 Samuel Pawel、Björn S. Siepe 和 Petr Čala。CRAN 归档目录显示,它的 0.1.0 版于 2025 年 11 月 5 日首次上架,此后经历 0.1.x 系列、0.2.0(加入 MAIVE)和 0.2.1 几次更新;0.3.0 版的 CRAN 发布日期是 2026 年 9 月 30 日。项目说明写明,新增或修改方法、数据生成机制时提升次版本号,所以这次从 0.2 升到 0.3,意味着基准里的方法清单变了。
按 NEWS 记录,0.3.0 的变化有四项:
- RTMA(右截断元分析):出自 Mathur(2024),用于校正 p-hacking 与发表偏倚的联合影响。包内通过 phacking 包的
phacking_meta()调用 Stan 估计,数据里至少要有一项“非肯定性”研究,即不显著或方向为负的结果。 - MAN(只合并非肯定性研究的元分析):出自 Mathur 与 VanderWeele(2020),用作敏感性分析,给出选择模型下发表偏倚达到最大时的最坏情形点估计。
- MMPH(p-hacking 混合模型):出自 Moss 与 De Bin(2023),通过 publipha 包的
phma()估计。 fit_limit参数:run_method()可以设定单次拟合的分钟上限,超时即返回标准化的失败结果。拟合放在复用的后台 R 进程里运行,因此卡在编译采样代码中的 RoBMA、RTMA、MMPH 也能被中止。
活体合成基准的比较方式
这个包是论文《Living Synthetic Benchmarks》的原型实现。论文 2025 年 10 月 22 日首发于 arXiv,2026 年 10 月 13 日更新为第 2 版。作者指出的问题是:新方法通常由提出者自己设计数据生成机制(DGM)做模拟检验,既有展示新方法优势的动机,各研究之间的 DGM、对照方法和性能指标也互不相同,结论难以横向比较。他们提出“活体合成基准”:把方法开发与模拟设计拆开,公开预先模拟好的数据和各方法的计算结果;新方法只需在同一批数据上运行并提交结果,新的 DGM 或指标加入后,再为已有方法补算。
在发表偏倚这个原型里,DGM 取自 Hong 与 Reed(2021)汇集的四组既有模拟研究:Stanley 等(2017)、Alinaghi 与 Reed(2018)、Bom 与 Rachinger(2019)和 Carter 等(2019)。模拟数据、逐次结果和性能指标以 CSV 文件存放在 OSF 仓库。指标除 RMSE、偏差和置信区间覆盖率外,还加入同时衡量区间宽度与覆盖的区间评分,以及把一类错误率和功效合起来看的正、负似然比,并附蒙特卡洛标准误。由于各组 DGM 的效应量尺度不同,网站按每个条件内的名次求平均来比较方法;对未收敛的拟合给出两种口径:只统计收敛的重复,或按“未收敛即替换”计入替代结果。
新方法的基准表现
2026 年 10 月 17 日查阅时,基准网站的总体结果页已纳入三种新方法,覆盖四组 DGM 共 1665 个模拟条件、24 个方法设置。只统计收敛重复时,RMSE 平均名次前三是 AK1 选择模型(7.428)、RoBMA 的 PSMA 设置(7.895)和新加入的 MMPH(8.014);按未收敛替换口径,MMPH 退到第四(9.138),排在 WAAPWLS 之后。RTMA(网站列出的是 relaxed 设置)和 MAN 分列第 22、23 位。
区间与检验方面的数字更值得留意。平均 95% 覆盖率最高的是 RoBMA(0.800),常规随机效应模型只有 0.457。RTMA 只算收敛重复时覆盖率为 0.758,排第四;按替换口径降到 0.575,说明它的表现很依赖未收敛重复的处理方式。一类错误率最低的仍是 RoBMA(0.102),MMPH 为 0.379,随机效应模型为 0.622,都远高于名义水平 5%。MAN 的 RMSE 名次和覆盖率(0.257)都靠后,但它的定位本来是最坏情形下的敏感性估计,并不以贴近真值为目标,更适合放在主分析旁边作对照。
适用边界与使用提醒
这些名次的适用范围有几条限制。第一,DGM 继承自四组旧研究,论文承认,针对相依效应量和元回归的新方法还缺少相应的 DGM,多层元分析或含调节变量的场景不能直接套用这里的排名。第二,网站提醒,总体名次高不等于在某个具体应用里最好,选方法应回到与自己数据特征相近的条件,查看分条件结果。第三,RTMA、MMPH、RoBMA 都依赖 Stan 采样,计算慢且设有收敛阈值(例如 RTMA 默认要求效应量的 R-hat 低于 1.01、有效样本量高于 500),大规模复现要预留算力,fit_limit 正是为此加入的。
第四是中立性。论文第一作者 Bartoš 也是 RoBMA 的作者,论文在利益声明中写明了这一点,并说明所有 DGM 都由其他研究者开发。论文目前仍是 arXiv 预印本,网站排名随提交的结果自动更新。对使用者来说,比较稳妥的用法是把它当作一张公开的“体检表”:先排除在相近条件下明显失效的方法,再并列报告几种表现稳定的方法,而不是只挑总排名第一的那一个。