
多重比较校正:Bonferroni 与 Benjamini–Hochberg 错误发现率
数十张检验结果卡片中有几张偶然亮起红色,示意同时做很多次检验时,即便没有真实效应,也可能冒出“显著”结果。AI 生成示意图。
同时做 20 次独立检验、每次都以 0.05 为门槛,即使所有原假设都成立,至少出现一个“显著”结果的概率也约为 64%。多重比较校正为此而设:Bonferroni 法控制“至少错一次”的概率,Benjamini–Hochberg(BH)程序控制“发现中错误所占的期望比例”。本文讲解两者的思路、前提与常见误用,并用 BH 原论文中的溶栓试验演示二者的差异。
多重检验的问题与两种错误率
单次假设检验的显著性水平 α 只约束这一次检验:原假设为真时,误判为显著的概率不超过 α。Perneger 1998 年在《英国医学杂志》(BMJ)上给出的算例是:对 20 个互不相关的变量各做一次检验,如果 20 个原假设全部成立,至少一次 P<0.05 的概率不再是 0.05,而是 0.64(即 1−0.95²⁰)。检验规模越大,问题越尖锐。Noble 2009 年在《自然·生物技术》的入门文章中,用一个转录因子结合模体扫描人类 21 号染色体上约 6800 万个长度为 20 的片段:得分 17.0 对应的 p 值为 5.5×10⁻⁷,看上去不到百万分之一,可在打乱碱基顺序、本不该有真实信号的对照序列中,同样高的得分仍出现了 35 次。
要校正,先得说清楚控制哪一种错误。Benjamini 与 Hochberg(1995)把 m 个检验的结果分成四格:在 m₀ 个真原假设中被判为显著的有 V 个(错误发现),在其余假设中被判为显著的有 S 个,总发现数 R = V + S。V 和 S 都观测不到,能看到的只有 R。由此有两种常用的错误率:
- 族错误率(FWER):P(V ≥ 1),即一族检验中至少出现一个错误发现的概率;
- 错误发现率(FDR):E(V/R),即错误发现在全部发现中所占比例的期望,约定 R = 0 时该比例记为 0。
所有原假设都为真时,两者相等;只要有一部分原假设不成立,FDR 就不大于 FWER。因此只控制 FDR 的方法可以更宽松,功效也可能更高,而且不成立的原假设越多,这种潜在的功效优势越大。
Bonferroni 与 BH 的核心思路
Bonferroni 校正最直接:做 m 次检验时,把每次的门槛从 α 降到 α/m;等价地,把每个 p 值乘以 m(上限为 1)后再与 α 比较。无论检验之间是否相关,它都能把 FWER 控制在 α 以内,代价是 m 越大门槛越苛刻。在 Noble 的染色体扫描中,取 α = 0.01 时门槛变成 0.01/(6800 万) ≈ 1.5×10⁻¹⁰,而最小的观测 p 值为 2.3×10⁻¹⁰,结果一个位点也不显著。Holm(1979)的逐步法同样在任意相依结构下控制 FWER,且拒绝的假设不会比 Bonferroni 少;R 语言 p.adjust 的官方文档因此直言,没有理由使用未经修改的 Bonferroni 校正,因为它被 Holm 法全面占优。
BH 程序换了目标:不追求“一个都不错”,而是把错误发现的期望比例控制在预设的 q(例如 0.05)以内。步骤如下:
- 把 m 个 p 值从小到大排序:p₍₁₎ ≤ p₍₂₎ ≤ … ≤ p₍ₘ₎;
- 找出满足 p₍ᵢ₎ ≤ (i/m)·q 的最大 i,记为 k;
- 拒绝排名前 k 的全部原假设。
Bonferroni 用一条水平线 α/m 去卡所有 p 值;BH 的门槛则是一条随排名 i 线性上升的斜线,第 1 名的门槛与 Bonferroni 相同,排名越靠后门槛越宽。第 3 步也值得留意:只要第 k 名过线,排在它前面的假设即使个别 p 值高于自己那一档的门槛,也一并拒绝。原论文证明,在检验统计量相互独立时,该程序的 FDR 不超过 (m₀/m)·q ≤ q。在 R 中,p.adjust(p, method = "BH") 返回 BH 调整后的 p 值,将其与 q 比较,得到的拒绝集合与上述步骤一致。
实例:溶栓试验中的 15 项比较
BH 原论文第 3.2 节用一项真实试验演示了该程序。Neuhaus 等人 1992 年发表的随机多中心试验,在 421 名急性心肌梗死患者中比较了前置负荷(front-loaded)给药的 rt-PA(重组组织型纤溶酶原激活剂)与标准方案的 APSAC(anisoylated plasminogen streptokinase activator)。Benjamini 与 Hochberg 指出,原文逐项报告 p 值,除区分主要与次要终点外没有处理多重性问题。他们取其中“治疗开始后的心脏及其他事件”这一族 15 项比较重新分析,从小到大排序的 p 值为:0.0001、0.0004、0.0019、0.0095、0.0201、0.0278、0.0298、0.0344、0.0459、0.3240、0.4262、0.5719、0.6528、0.7590、1.000。其中 0.0095 对应住院死亡率,原试验关于死亡率显著降低的表述正是基于这个 p 值。
取 α = q = 0.05,三种做法的结果如下:
- 不校正:前 9 个 p 值都小于 0.05,全部算作“显著”。
- Bonferroni:门槛为 0.05/15 ≈ 0.0033,只拒绝前 3 个,分别对应过敏反应减少和两项出血指标,死亡率不在其中;原作者指出改用 Hochberg 法结果相同。按同一组数据计算,Holm 法的第 4 档门槛为 0.05/12 ≈ 0.0042,同样止步于 3 个。
- BH:从最大的 p 值开始依次与 0.05·i/15 比较,第一个过线的是第 4 名:0.0095 ≤ 0.05 × 4/15 ≈ 0.0133。于是前 4 个假设被拒绝,死亡率也在其中。
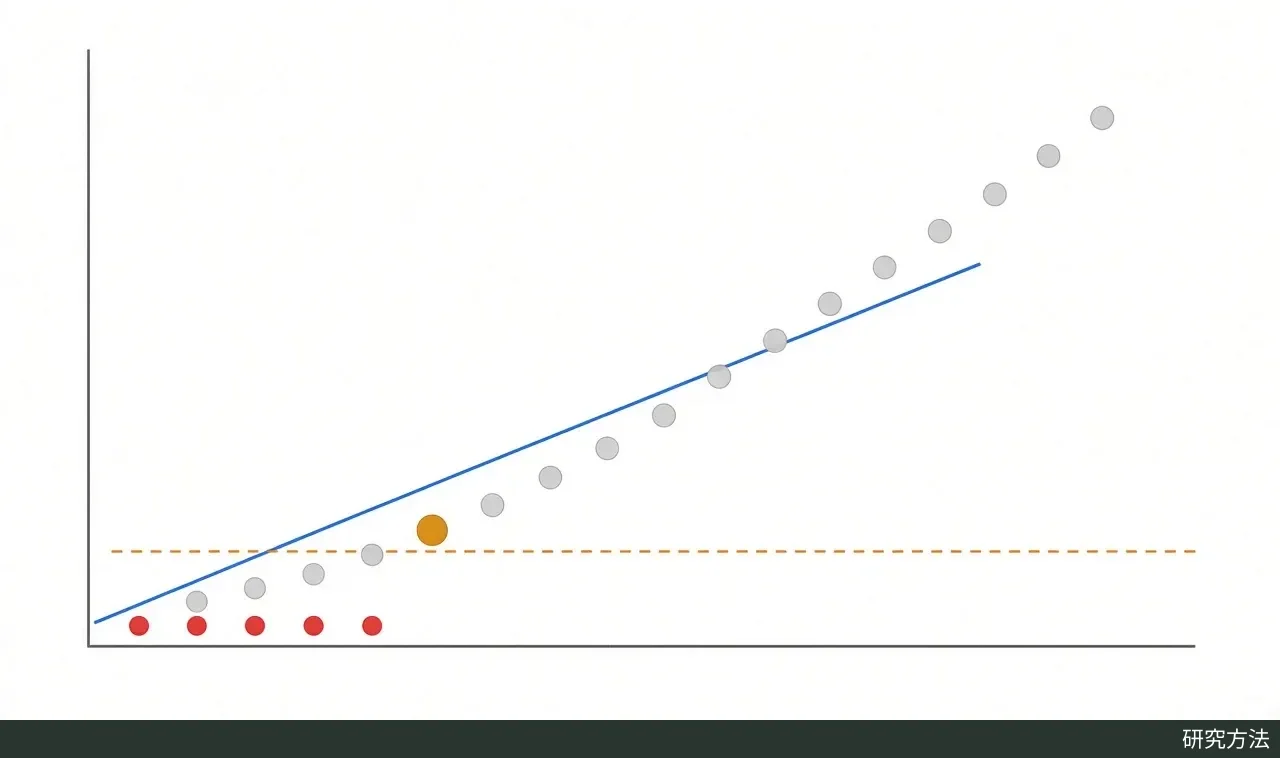
Bonferroni 用一条贴近底部的水平门槛(橙色虚线)卡住所有 p 值,BH 的门槛则是随排名上升的斜线(蓝色实线)。本图只示意两条门槛线的形状差异,点的数量和位置不对应正文的 15 个 p 值,实际结果以上方列表为准(数据见 Benjamini & Hochberg, 1995, 第 3.2 节)。AI 生成示意图。
这个例子展示的是两种错误率的取舍,并不构成对该疗法的新的临床判断。Benjamini 与 Hochberg 认为,这类多终点问题最终服务于一个整体决定,即是否推荐新疗法替代标准疗法,少量错误发现不会改变结论的总体有效性,因此控制 FDR 比控制“任何一个错误”的概率更合适。反过来,如果后续只会针对某一个结果做决定,Noble 的建议是仍以 Bonferroni 类方法为宜。
使用前提与常见误用
使用前先确认三件事:
- 检验族事先界定。 BH 原论文的设定假定这 m 个假设事先已知。若看完结果再决定把哪些检验算进来,m 和门槛都会随之变化。R 的
p.adjust允许把比较次数 n 设得大于手头 p 值的个数,用来计入未列出的检验,但文档提醒只在清楚其含义时才这样做。 - 检验之间的相依结构。 Bonferroni 与 Holm 对任意相依结构都成立。BH 的原始证明要求检验统计量相互独立;Benjamini 与 Yekutieli(2001)证明,在“正回归相依”(PRDS)条件下它仍然有效,这涵盖多个处理与同一对照比较、正相关的多元正态统计量等常见情形。对其他相依形式,可改用 BY 修正,即把 q 换成 q/(1 + 1/2 + … + 1/m),代价是明显更保守;R 文档指出,对很小的 p 值它甚至比 Bonferroni 更严。
- 错误率与研究目标相符。 Noble 的建议是:如果计划对一批候选做后续实验、能容忍其中固定比例失败,适合控制 FDR;如果只跟进单个结果,Bonferroni 类方法更合适。
常见误用包括:
- 把 FDR 当成单个发现为假的概率。 FDR 是对全部发现求的期望比例,具体一次研究中的 V/R 观测不到。某个结果本身为假的概率是另一个量,即局部 FDR,Noble 指出它通常很难准确估计。
- 把“FDR 控制在 5%”理解为“这份清单里恰好 5% 是假的”。 被控制的是期望值,某一次研究的实际比例可能更高也可能更低。
- 仍用原始 Bonferroni。 如果目标是控制 FWER,Holm 法在相同前提下同样有效,且拒绝的假设不会更少。
- 看完结果再挑校正方法或重划检验族,哪种拒绝得多就报告哪种,这会让预设的错误率失去意义。
- 机械地对一切检验做校正。 Perneger(1998)认为,Bonferroni 针对的是“所有原假设同时成立”这一研究者很少关心的总体原假设,会让一个结果的解释取决于同时做了多少别的检验,还会增大第二类错误;他主张多数情况下如实说明做了哪些检验、为何要做。这是一篇代表流行病学界一种立场的观点文章,文中也提到不少统计学家和期刊编辑要求做校正,是否校正仍应取决于研究问题。