
德尔菲法(Delphi method)是一种结构化的专家咨询方法:研究者用多轮匿名问卷收集专家判断,每轮把全组意见的统计摘要反馈给专家,让他们参考后重新作答,最后用中位数等统计量汇总。它适用于缺乏可靠数据、只能依靠专业判断的问题,但意见收敛本身并不等于答案正确。
解决的问题与四个核心要素
很多决策问题没有足够的历史数据可以建模,例如预测某项技术何时成熟,或为临床指南挑选关键指标,只能依靠专家判断。Rowe 与 Wright(1999)强调,德尔菲法并不打算与统计或模型方法竞争,而是用在缺少历史、经济或技术数据、纯模型方法不可行的场合,目的是尽量有效地利用人的判断。把专家请到一起开会是最直接的办法,但面对面讨论容易受地位、口才和社会压力左右。Dalkey 与 Helmer(1963)描述的做法是分别询问每位专家,避免他们彼此直接对质,同时由组织者在轮次之间传递数据和理由。
Rowe 与 Wright 把德尔菲法的必要特征概括为四点:匿名、迭代、受控反馈和统计汇总。匿名让专家可以改变看法而不必担心在他人面前丢面子;迭代指同一组专家回答多轮问卷;受控反馈指组织者在每轮之后把全组结果整理成统计摘要(通常是中位数加上下四分位数),有时附上落在预设范围之外者的理由;统计汇总指最终结果取末轮估计的平均数或中位数,相当于对每位成员等权。经典流程的第一轮多为开放式问题,组织者把回答归并成结构化条目,此后各轮再请专家打分或给出数值估计。Hsu 与 Sandford(2007)综述的文献认为,多数情况下三轮已足以收集所需信息并形成共识。
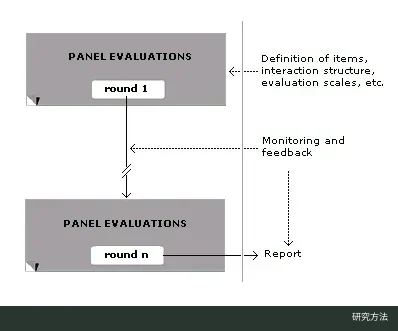
德尔菲法的轮次结构:研究者先设定条目、交互方式和评分量表,专家组从第 1 轮到第 n 轮反复评估,轮次之间由研究者监控并反馈结果,最后形成报告。图:Czkssa,来源 Wikimedia Commons(File:DELPHIST.png),许可 CC BY-SA 3.0。
实例:RAND 的轰炸需求估计
德尔菲法源自兰德公司(RAND)为美国空军开展的“德尔菲计划”。Dalkey 与 Helmer 1963 年发表在 Management Science 上的论文报告了约十年前的一次实验,内容此前因保密未能公开。实验请专家站在苏联战略规划者的角度,选出美国最优的工业目标体系,并估计把军需产出削减到规定程度需要多少枚原子弹。专家组共 7 人:4 名经济学家、1 名物理易损性专家、1 名系统分析员和 1 名电子工程师。他们大约每周回答一份问卷,共 5 轮,第 1 轮和第 3 轮之后还分别接受了个别访谈。轮次之间,组织者提供某位专家索要的数据(如钢厂产量统计),或转述其他专家提出的相关因素。
估计值明显收敛。第一轮最小 50 枚、中位数 200 枚、最大 5000 枚,最大与最小之比约为 100 比 1;第五轮的原始回答为 159 至 494 枚,中位数 255 枚,比值降到约 3 比 1。作者认为“每座工厂需要几枚炸弹”这一分项适合取共识,于是把每人自己的该项数字替换为七人的中位数并重新计算,得到的“修正终答”为 167 至 360 枚,中位数 276 枚,比值约 2 比 1。读这个例子要留意三点:常被引用的“167 至 360”是研究者事后修正的结果,不是专家第五轮的原始回答;作者也承认,组织者挑选反馈信息难免带来一定“引导”;这项任务没有可供比对的真实答案,实验展示的是意见如何收敛,不能证明收敛后的数字更准确。
使用前提
结果是否可信,首先取决于专家是谁。Hsu 与 Sandford 认为挑选受访者是整个流程中最重要的一步,但文献中并没有公认的遴选标准,仅仅“了解议题”并不够。他们综述的文献显示,面板规模一般在 50 人以下,研究周期建议至少 45 天,每轮给专家约两周作答。由于同一批人要反复作答,流失会逐轮累积,低应答率是常见风险。
其次,问题要真正需要判断。数据充足、可以建模时,德尔菲法不能替代统计模型。Rowe 与 Wright 回顾的实验研究中,德尔菲组与“统计组”(彼此不交流的个人估计直接平均)相比,12 项研究占优、2 项落后、2 项持平;与面对面讨论组相比为 5 项占优、1 项落后、2 项持平;但没有一致证据表明它优于名义小组法等其他结构化群体方法。他们同时提醒,许多实验室研究没有控制专家水平、反馈形式等关键条件,与德尔菲法的原始设想差别较大,这些结论不宜直接推广。最后,共识标准和停止规则应当事先确定:CREDES 报告指南(Jünger 等,2017)要求说明为何选用德尔菲法,对流程的任何改动给出理由,并在研究性质允许时预先设定共识标准。
常见误用
第一种误用是把“达成共识”当成“找到了正确答案”。德尔菲法输出的是专家意见的汇总,收敛可能来自信息交流,也可能来自从众压力。Hsu 与 Sandford 引用的实验显示,专家收到被故意扭曲的反馈后会相应改变评分;Cyphert 与 Gant(1971)据此认为,这种方法既能收集意见,也能塑造意见。
第二种误用是事后才定义共识。Diamond 等(2014)随机抽取 2000–2009 年发表的 100 项德尔菲研究,发现 98 项声称评估了共识,但只有 72 项给出定义,其中 64 项是事先定义;最常见的定义是百分比一致(25 项),在给出比例阈值的研究中,阈值中位数为 75%,范围 50% 至 97%。86 项研究宣称达成共识,其中只有 42 项事先规定了带阈值的标准;只有 23 项依据是否达成共识决定停止,70 项在预定轮数后结束。门槛定在 51% 还是 90%,可以让同一组数据得出相反的“共识”结论。
第三种误用是只在名义上使用德尔菲法。取消匿名、不反馈全组结果、只做一轮问卷,或只把组织者认可的意见反馈给专家,都会削弱方法的设计初衷。Jünger 等对 1997–2015 年 30 项姑息治疗领域德尔菲研究的系统综述发现,各研究在设计严谨度和报告透明度上差异很大,连“轮”和“改良德尔菲”等术语的用法都不统一。报告中写清专家遴选方式、每轮问卷与应答率、反馈形式、共识标准以及未达成共识的条目,读者才能判断结论的分量。