
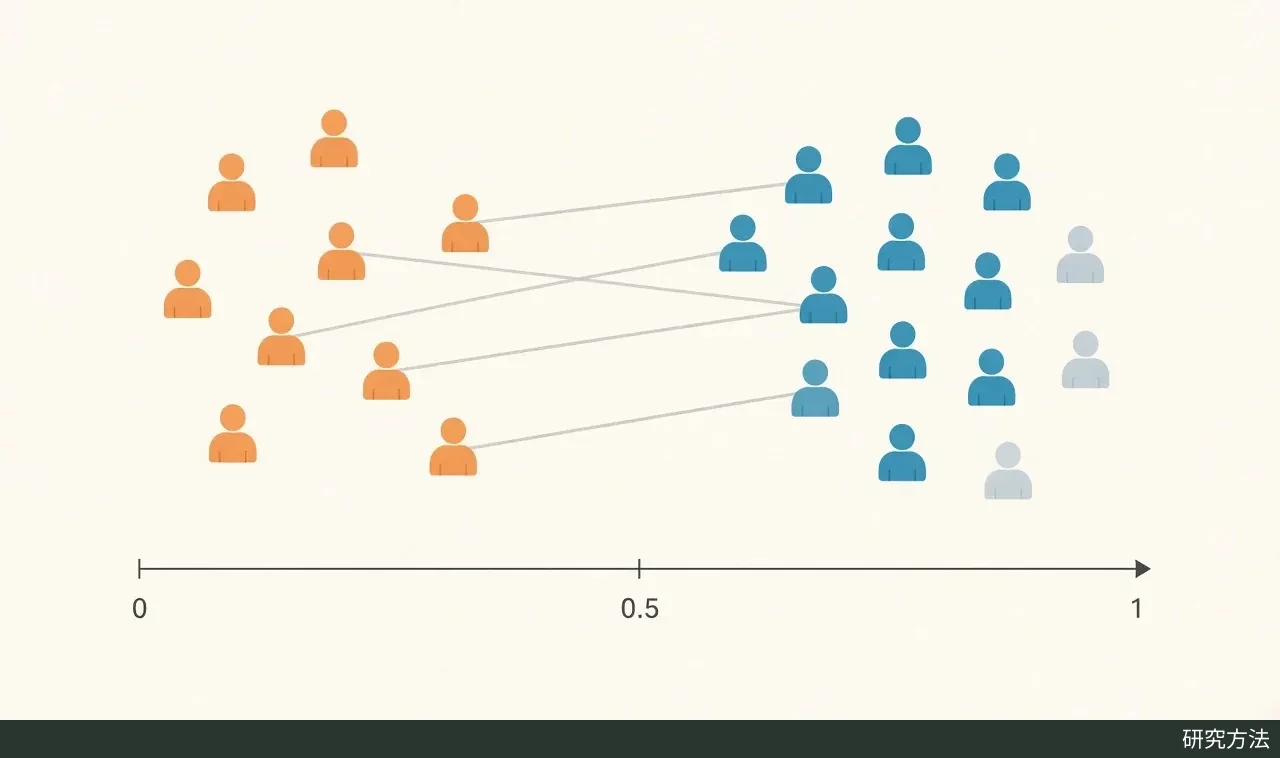
倾向评分匹配概念示意:橙色人形代表处理组,蓝色人形代表对照组,细线表示配对,淡灰色为未被选中的对照,底部为 0 到 1 的倾向评分刻度。AI 生成示意图。
倾向评分匹配(propensity score matching,PSM)是从观察数据估计处理效应的常用方法:先估计每个人在给定基线特征下接受处理的概率,再为处理组成员挑选概率相近的对照,使两组在已测变量上像随机分组一样可比。它无法平衡未测变量,结论是否可信取决于前提假设、平衡诊断和匹配方式。
要解决的问题与核心思路
在随机对照试验里,谁进入处理组由随机机制决定,两组的基线特征平均而言相同,结局差异可以归因于处理。观察数据没有这道保障:是否接受处理常常与个人特征有关。比如自愿报名就业培训的人,年龄、学历、过往收入可能本就和不报名的人不同;直接比较两组之后的收入,得到的是培训效果与这些先天差异的混合,也就是混杂(confounding)。Stuart(2010)的综述把匹配方法的目标概括为:用观察数据尽可能复制随机试验,得到协变量分布相近的处理组与对照组。
Rosenbaum 与 Rubin 在 1983 年发表于 Biometrika 的论文中定义了倾向评分:给定观测到的基线协变量 X,个体接受处理的条件概率 e(X) = Pr(Z = 1 | X)。它的关键性质是“平衡评分”:在倾向评分相同的一群人中,处理组与对照组的已测协变量分布相同。打个比方:两名求职者,一人报名培训、一人没有,但按年龄、学历和过往收入计算,两人报名的概率都是 0.6;就这些已测特征而言,谁去报名就像抛了一枚偏心硬币。于是研究者不必在十几个变量上逐一配对,只需在倾向评分这一个数字上配对。
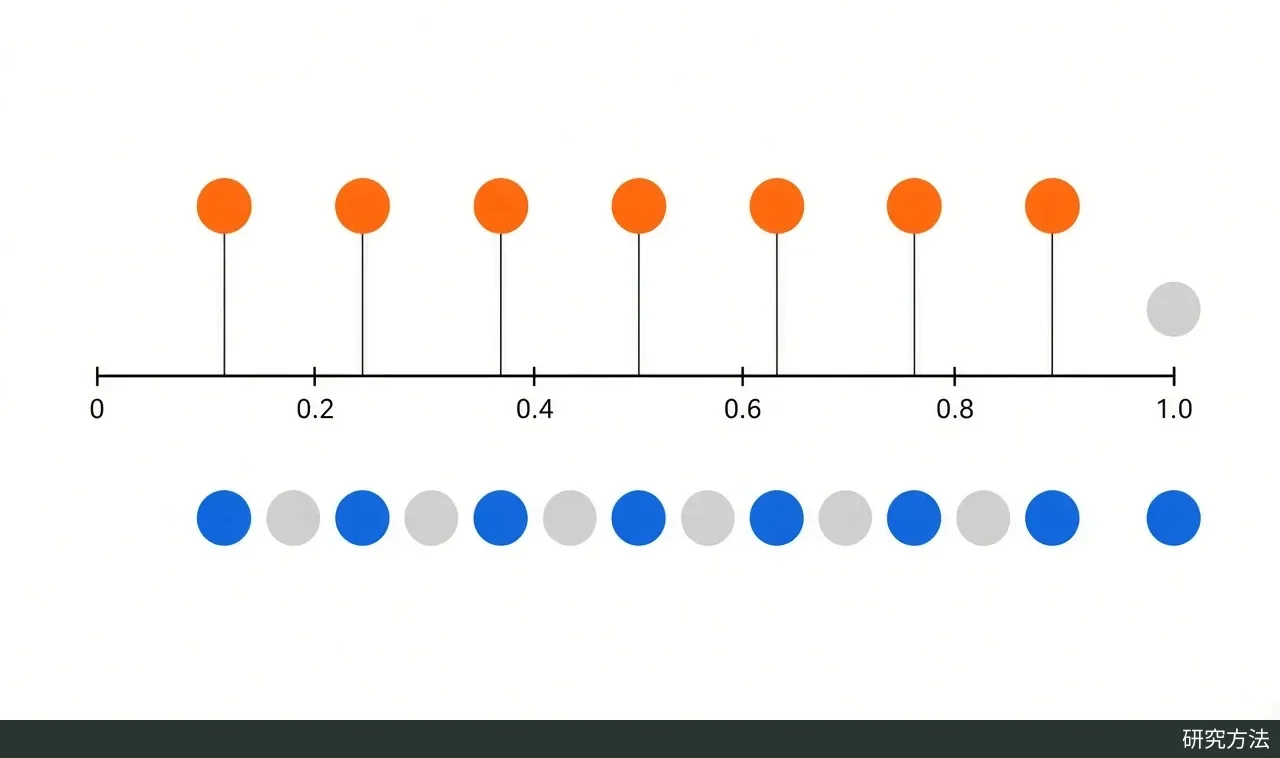
最近邻卡尺匹配示意(模拟情形,点位仅作示意):横轴为倾向评分,上排橙点为处理组,下排为对照组;竖线标出与评分相近对照的配对位置。右端灰色处理组点表示超出卡尺、未能匹配,下排灰点为未被选中的对照。AI 生成示意图。
实践中通常先用 logistic 回归估计倾向评分,再为每个处理组成员找评分最接近的对照(最近邻匹配)。还可以加“卡尺”:评分差超过阈值就不配对,配不上的处理组成员被排除。Austin(2011)指出,在倾向评分的 logit 上匹配有理论依据,并建议卡尺宽度取 logit 标准差的 0.2 倍,因为在其模拟情境中这一取值使效应估计的均方误差最小或接近最小。匹配可以有放回或无放回;有放回时同一对照可能出现在多个配对中,方差估计须考虑这一点。最常见的匹配形式适合估计处理组平均处理效应(ATT),即“对实际接受处理的那类人,处理平均带来多大变化”。倾向评分还可用于分层、逆概率加权和协变量调整,本文只讨论匹配。
使用前提与平衡诊断
倾向评分能去除偏差,依赖 Rosenbaum 与 Rubin 所说的“强可忽略性”,它包含两个条件:第一,给定已测协变量,处理分配与潜在结局独立,也就是没有未测混杂;第二,0 < Pr(Z = 1 | X) < 1,每个人接受和不接受处理的概率都不为零,两组在倾向评分上要有重叠。第一个条件无法用数据检验,Austin(2011)称其为倾向评分分析赖以成立的关键假设;Rosenbaum 与 Rubin 另提出敏感性分析,用来评估结论对未测混杂有多敏感。
协变量的选择同样属于前提。MatchIt 文档强调,要估计总效应,所有协变量都必须在处理之前测量,或者不受处理影响;应纳入的是同时影响“是否接受处理”和结局的混杂变量。Austin(2011)认为,在许多情境下,大多数个体基线特征都同时影响处理与结局,因此纳入全部已测基线特征通常是安全的。
匹配后必须检查平衡。常用指标是标准化差异:两组均值(或比例)之差除以合并标准差。它不受样本量影响,也能在单位不同的变量之间比较;文献中常把小于 0.1 视为差异可忽略,但这只是惯例,并无公认阈值。除均值外,还应比较方差、高阶矩和交互项,并辅以箱线图、分位数图等图形。若仍有系统性差异,就回头修改倾向评分模型,例如加入交互项或非线性项,再重新匹配和检查。这个循环只用到协变量、不碰结局,Austin 据此指出倾向评分方法可以把研究设计与结局分析分开。
实例:lalonde 就业培训数据
MatchIt 是 R 语言中常用的匹配软件包,其入门教程(Noah Greifer 撰写,页面标注日期为 2026 年 9 月 26 日)用 lalonde 数据演示了完整流程。数据由美国国家支持工作示范项目(NSW)的处理组和 PSID 调查的比较样本组成,共 614 人,其中处理组 185 人、对照 429 人,LaLonde(1986)和 Dehejia 与 Wahba(1999)都分析过这组数据。研究问题是参加项目对 1978 年收入的影响(ATT),协变量包括年龄、受教育年限、种族、婚姻状况、是否没有高中文凭,以及 1974 年和 1975 年收入。
匹配前两组差异悬殊:处理组黑人比例为 84.3%,对照组为 20.3%,标准化差异 1.76;已婚比例分别为 18.9% 和 51.3%;1974 年平均收入分别约为 2096 美元和 5619 美元。教程先做 1:1 无放回最近邻匹配(用 logistic 回归估计倾向评分),保留 185 对、舍弃 244 名对照。1974 年收入的标准化差异降到 -0.05,但黑人比例仍是 84.3% 对 47.0%,标准化差异 1.03,教程判定平衡“仍然相当差”,这种设定不足以消除该数据中的混杂。
教程随后改用完全匹配(full matching),并以 probit 模型估计倾向评分:全部处理组和对照组成员都进入匹配层,但对照组的有效样本量只有约 51。此时各协变量的标准化差异除“没有高中文凭”为 0.11 外都在 0.1 以内,黑人比例的标准化差异降到 0.01。随后在匹配样本上拟合含交互项的加权回归,用 g 计算估计效应,并按匹配层计算聚类稳健标准误;教程的示例报告写出 ATT 为 2114 美元(标准误 646)。这个例子说明,第一次匹配不达标很常见:应由平衡诊断决定是否更换方法,最终报告还要写明尝试过哪些设定。
常见误用与方法争议
- 把匹配当成随机化:倾向评分只平衡已测协变量,未测变量不一定平衡(Austin, 2011)。没测到的求职动机、健康意识等,匹配后依旧可能悬殊。
- 用显著性检验判断平衡:匹配后样本几乎总比原样本小,“不显著”可能只是检验功效下降;样本很大时,微不足道的差异也会显著。平衡是特定样本的性质,应看标准化差异等描述性指标(Austin, 2011)。
- 用 c 统计量评价倾向评分模型:c 统计量衡量模型区分处理者与未处理者的能力,Austin(2011)引用的研究表明,它不能说明模型设定是否恰当。
- 把处理后的变量放进模型:受处理影响的变量不满足“处理前测量”的要求,纳入后估计的就不再是处理的总效应(MatchIt 教程)。
- 卡尺丢了样本却不说明:卡尺或共同支持限制会排除部分处理组成员,估计对象随之变成“剩余匹配样本中的平均效应”,既不是 ATE 也不是 ATT(MatchIt 教程)。应报告匹配、未匹配和被舍弃的样本数。
- 忽视配对结构:同一配对的个体倾向评分相近、结局也更相似,并不独立。Austin 主张按配对数据估计方差,MatchIt 教程建议多数分析使用以配对为聚类的稳健标准误。
另有一种批评针对方法本身。King 与 Nielsen(2019,Political Analysis)认为,倾向评分匹配近似的是完全随机试验,而其他匹配方法可以近似效率更高的完全区组随机试验;当数据已经比较平衡时,继续按倾向评分剪除样本近似于随机匹配,反而可能增加不平衡、低效、模型依赖和偏差。他们建议做匹配时改用其他方法,同时承认倾向评分在其他用途上仍有价值。