
1985–86 学年起,田纳西州 79 所公立小学把同一年级的学生和教师在校内抽签分进三种班:13–17 人的小班、22–25 人的常规班,以及配全职助教的常规班。这项名为 STAR 的实验持续到 1989 年三年级结束,先后纳入约 11,600 名学生。本文拆解它的随机化、对照、样本量与测量,执行中的走样,以及结论的适用范围。
研究问题与三组对照
班额和成绩的关系,用现成的观察数据很难说清。小班可能更多出现在经费、生源或管理与众不同的学校,看到的成绩差异分不清来自班额本身还是这些背景。Krueger(1999)回顾文献时指出,教育“生产函数”的估计会随模型设定、数据汇总层级和控制变量而摇摆:用跨州数据的研究多发现学校资源有正效应,用州内数据的研究则更常得到不显著甚至符号相反的结果。田纳西州议会希望在全面投钱缩班之前先拿到可靠证据,于是授权并资助了这项四年期研究,总成本约 1200 万美元;研究由田纳西州立大学、孟菲斯州立大学、田纳西大学和范德堡大学的研究者联合设计和实施(Mosteller 1995;Krueger 1999)。
实验设三种班型:小班 13–17 人;常规班 22–25 人;常规班外加一名全职助教,人数同样是 22–25 人。常规班是“照常上课”的对照——1985–86 学年全州幼儿园的生师比为 22.3,常规班学生的处境大致相当于全州平均水平。助教班用来拆开两个容易混在一起的因素:如果问题只是老师一个人顾不过来,多配一个成年人也许就够;如果助教班没有起色而小班有,起作用的更可能是班级人数本身。
对照组的设定还受伦理约束:常规班学生不应失去平时本来能得到的资源,因此一至三年级的常规班平均有 25%–33% 的时间可以用上兼职助教,这缩小了两种常规班之间的实际差别(Krueger 1999)。此外,研究团队请 17 个学区的 22 所非实验学校(51 个常规班、约 1,100 名学生)参加同样的测验,作为校外比较组,用来检查实验学校是否因为“被研究”而整体表现异常(Word 等 1990)。
校内随机化与样本规模
全州所有开设幼儿园到三年级的学校都受到邀请(Boyd-Zaharias 1999)。约 180 所学校(分属全州 141 个学区中的约 50 个)表示愿意参加,但只有约 100 所的幼儿园人数达到门槛。门槛来自设计本身:每所学校该年级至少要有 57 名学生,才能同时开出至少一个小班、一个常规班和一个助教班。学校还要承诺参加四年、接受师生随机分配,任课教师须持有对应年级的资格证书。最终入选的是 42 个学区的 79 所学校,其中内城 17 所、郊区 16 所、农村 38 所、城市 8 所,覆盖各类地区是议会立法的要求(Word 等 1990)。
关键的设计选择是“校内随机”:每所学校自成一个区组,三种班型都在同一所学校里开设,共享同一位校长、同样的课程、经费和生源。打个比方,比较三种跑鞋时,让同一支队里的队员抽签决定穿哪双,而不是让甲队穿 A、乙队穿 B,这样队与队之间的训练差别就不会混进鞋的比较。代价是随机化只在校内成立,分析时必须控制学校。Krueger(1999)的检查正好说明了这一点:不分学校直接比较三组时,免费或减价午餐比例、种族构成和年龄有些差异达到统计显著;把学校作为固定效应控制后,这些背景变量与班型分配都没有显著关联。
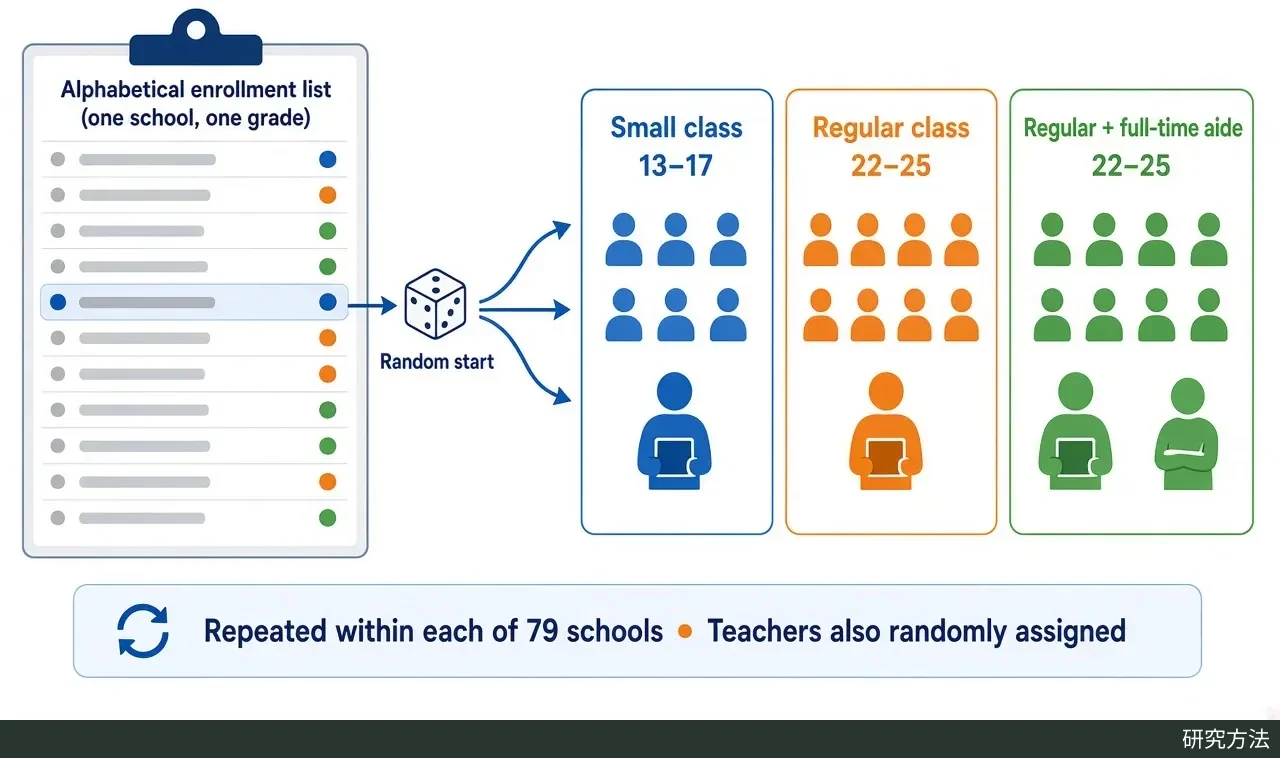
STAR 校内随机分配示意。作者用代码绘制,依据 Word 等(1990)与 Krueger(1999)。
分配程序写得很具体:每所学校准备按字母排序的入学名单,由中心按各校人数预先编好“每隔 k 名分到某类班”的规则,各校用随机起点套用,并接受审计。教师也随机分配到各班型;Krueger 用教师的教龄、种族和学历分别对四个年级做了 12 次检验,班型的 p 值都大于 0.05。他还从 18 所学校调出幼儿园开学前的原始分班表,对 1,581 名学生逐一录入核对,只有 0.3% 的学生没有进入被分到的班型。
样本规模方面,1985–86 学年的幼儿园共有 128 个小班(约 1,900 名学生)、101 个常规班(约 2,300 名)和 99 个助教班(约 2,200 名),合计约 6,500 名学生(Word 等 1990)。当时田纳西州并不强制上幼儿园,之后一、二、三年级又分别新进约 2,200、1,600 和 1,200 名学生,入组时同样随机分配,但因各班空位不均,新生在三种班型间的分配并不平衡;四年累计约 11,600 人(Krueger 1999;Chetty 等 2011 给出的是 11,571 人)。不过,处理是按班级施加的,同班学生的成绩彼此相关,“六千多名学生”的信息量远不如字面上大。Krueger 计算标准误时加入了班级层面的随机成分,所得稳健标准误比普通最小二乘的结果大约三分之二。
测量与执行偏差
结果测量依靠每年 3 月底或 4 月初的统一测验:斯坦福成就测验覆盖幼儿园到三年级的阅读、词汇识别和数学,田纳西“基本技能优先”测验覆盖一至三年级的阅读和数学(Krueger 1999)。研究团队把设计定位为 Campbell 与 Stanley 分类中的第 6 号设计,即只有后测的随机实验(Word 等 1990)。没有入学前的基线测验,意味着无法直接比较各组的起点成绩,只能用性别、种族、年龄、午餐补助等背景变量检查平衡。
真正的考验来自执行。第一,一年级开始时,常规班和助教班的学生被重新随机分配,目的是安抚对分班结果不满的家长;小班学生则留在小班,常常还是原来的同学。幼儿园阶段的比较不受影响,但如果“同学是否不变”本身影响成绩,之后几年的比较就掺进了别的因素。第二,二、三年级本应保持班型不变,每年仍有 9%–11% 的学生换了班型,原因多是行为问题,有时是家长投诉。第三,学生年内转入转出,实际班额超出了设计范围:小班 11–20 人,常规班 15–30 人(Krueger 1999)。
第四是流失。从幼儿园入组的学生只有一半四年都留在样本里;这一批中,小班学生留下的概率比常规班高 3–4 个百分点,一年级入组的那批则相反。留级的学生会离开样本,而四年间小班学生的留级率为 19.8%,常规班为 27.4%(Word 等 1990,转引自 Krueger 1999)。这类不对称的危险在于:设想常规班里家境较好的孩子陆续转去私立学校,留下来的常规班平均成绩就被拉低,小班优势会被高估。另一个隐患在数据层面:STAR 数据库只记录了学生每年实际所在的班型,没有保存最初的随机分配,Krueger 只好回到原始分班表去抽查。
Krueger 用两种办法检验这些偏差的影响。针对换班,他按学生首次入组时的班型分析,而不是按实际所在班型;结果只略小于按实际班型的估计,并且始终显著。针对流失,他用学生最近一次的测验百分位填补其离开后的年份,这种粗略做法接近临床研究中的“末次观测值结转”,估计结果与只用在册学生的结果定性上相近。综合下来,小班学生的斯坦福测验平均百分位比常规班高约 5–7 个点,按标准差计的效应量在幼儿园、一、二、三年级分别为 0.20、0.28、0.22 和 0.19;按论文摘要的概括,进入小班的第一年约提高 4 个百分位,此后每年再扩大约 1 个百分位。助教班只比常规班高 1–2 个百分位,仅在一个年级显著(Krueger 1999)。
长期追踪与外推边界
三年级结束后,所有学生回到常规班,但追踪没有停止。1989 年启动的“持续效益研究”(Lasting Benefits Study)发现,原小班学生回到常规班后仍然领先于同年级同学(Mosteller 1995)。Krueger 与 Whitmore(2001)追踪到 1998 届高三学生:初始分到小班的学生有 43.7% 参加了 ACT 或 SAT 大学入学考试,常规班为 40.0%,3.7 个百分点的差距在 0.05 水平上显著;黑人学生的参考率从 31.7% 升至 40.2%,小班组的黑白差距比常规班组小 54%。他们也提醒,在已参考学生中比较分数会受到选择影响,因为小班组有更多边缘学生走进了考场。Chetty 等(2011)把实验数据与成年后的行政记录相连,发现小班学生上大学的概率显著更高,但 27 岁时的收入差异不显著,作者明确说这一估计并不精确。
结论能推广到哪里,要从设计里逐项找边界。学校层面,79 所学校来自自愿报名、规模达标、愿意承诺四年的学校,不是全州学校的随机样本,一个年级凑不满 57 人的小学根本进不了实验。处理强度上,比较的是 13–17 人对 22–25 人,Krueger 做成本收益估算时也按“从 22 人降到 15 人”计算;从 30 人降到 25 人、或降到 10 人以下会怎样,STAR 没有直接回答。人群和时代上,这是 1980 年代后期田纳西州幼儿园到三年级的学生,Krueger 的样本中 99% 是白人或黑人,其他族裔几乎没有代表。规模化上,实验只是在已有学校里多开几个班,由已有的持证教师任教;如果全州同时缩班、需要大量新教师和教室,师资与场地能否跟上,实验本身没有检验。至于第三阶段的 Project Challenge——给 17 个最贫困学区的低年级开设小班后,这些学区在全州 139 个学区中的阅读和数学排名从远低于平均升至高于平均(Mosteller 1995)——它没有随机对照,只能算支持性的观察证据。