
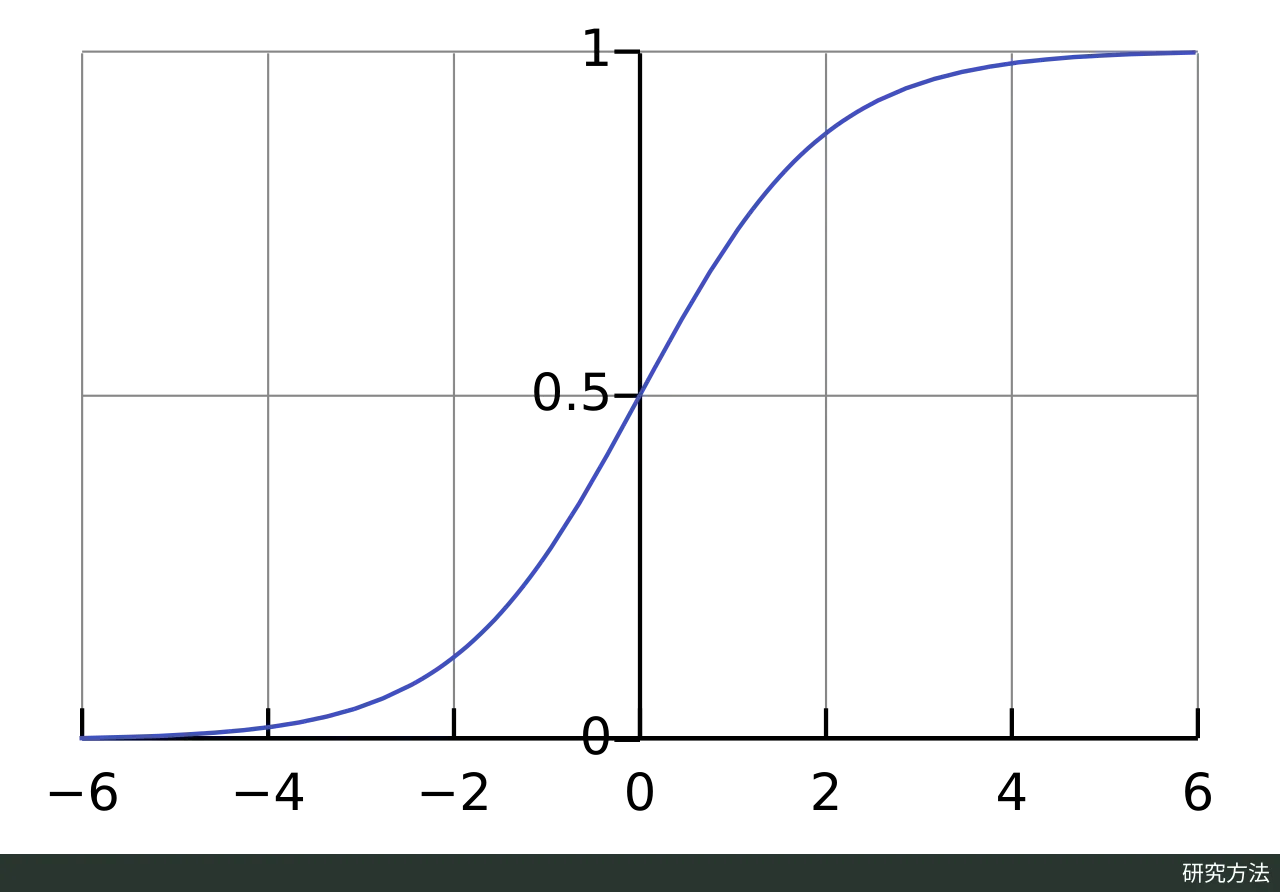
标准 logistic 函数 π = eˣ/(1+eˣ) 的曲线:自变量可取任意实数,函数值始终落在 0 和 1 之间。作者:Qef;来源:Wikimedia Commons;许可:公有领域。

logistic 回归是分析二分类结果的常用模型:它把事件发生的对数优势写成预测变量的线性组合,系数取指数即为优势比。优势比并不等于风险比,结局越常见、效应越大,两者差得越远。本条目依据广义线性模型教材和方法学文献,说明模型设定、系数解释、诊断与过拟合风险、不宜使用的情形,并附一个可手算复核的算例。
二分类结果的模型设定
结果只有“发生/未发生”两种取值时,若直接用普通线性回归拟合 0/1 变量,预测值可能小于 0 或大于 1。广义线性模型(GLM)把模型拆成三部分:随机成分规定结果 Y 服从单次试验的二项分布,发生概率为 π;系统成分是预测变量的线性组合;链接函数把 π 和线性组合连接起来。logistic 回归使用 logit 链接:
logit(π) = log[π / (1 − π)] = β₀ + β₁x₁ + … + βₖxₖ
反解得 π = exp(η) / [1 + exp(η)],其中 η = β₀ + β₁x₁ + … + βₖxₖ。
式中 π/(1−π) 称为优势(odds),即发生概率与不发生概率之比。对数优势可以取任意实数,反解出的 π 却始终在 0 和 1 之间,随 η 变化呈 S 形曲线。模型没有单独的正态误差项,也不要求结果服从正态分布,但要求各观测相互独立,并假定对数优势与预测变量呈线性关系。参数通常用极大似然估计;嵌套模型之间的比较可看偏差(deviance)之差,即似然比检验。
优势比与风险比
设暴露组和非暴露组的事件风险分别为 P₁ 和 P₀。风险比(relative risk,RR)是 P₁/P₀;优势比(odds ratio,OR)是 [P₁/(1−P₁)] ÷ [P₀/(1−P₀)]。两者的关系为 OR = RR × (1−P₀)/(1−P₁),整理后得 RR = OR ÷ (1 − P₀ + P₀×OR)。
Davies 等人 1998 年在 BMJ 上量化了两者的差距:把优势比当作风险比来读,总会夸大效应,OR>1 时 OR 大于 RR,OR<1 时 OR 小于 RR;夸大程度随初始风险和效应量一起增大;只要初始风险乘以 OR 小于 100%,OR 对 RR 的高估就不超过一倍。他们也指出,大的偏差只在初始风险高、效应又大时出现,此时无论用哪个指标,结论都是“效应很大”,定性判断通常不变;但做成本效果等定量分析时,仍应算出风险比本身。
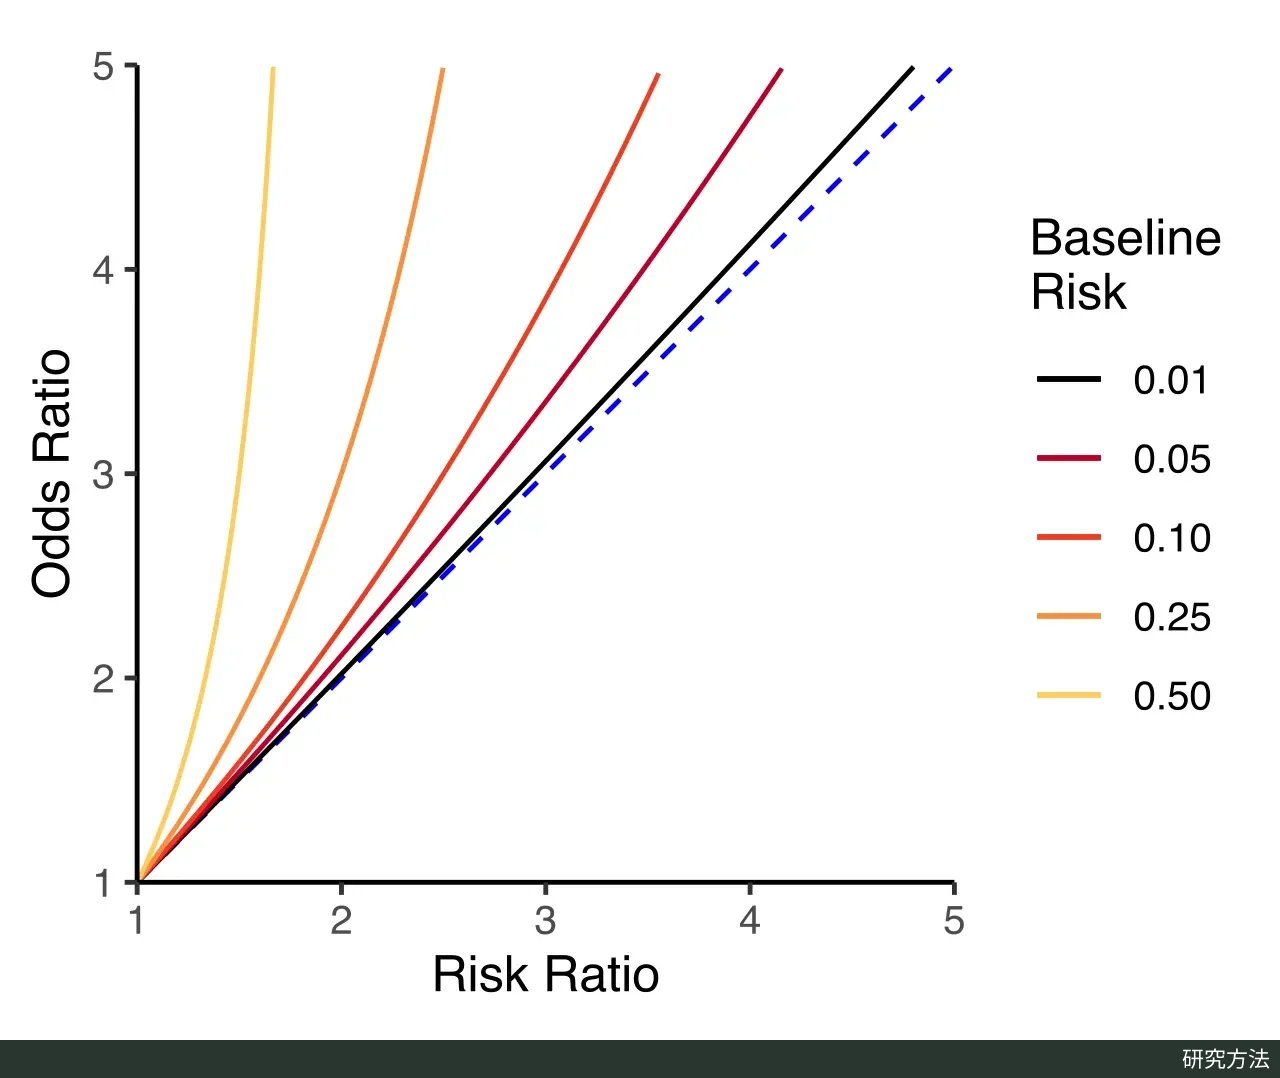
风险比(横轴)与优势比(纵轴)的关系:五条曲线分别对应 1%、5%、10%、25%、50% 的基线风险,蓝色虚线表示 OR = RR。基线风险越高,同一风险比对应的优势比越大,与 Davies 等(1998)的换算关系一致。作者:D Wells;来源:Wikimedia Commons;许可:CC BY-SA 4.0。

真实数据中的差距可能不小。Zou 2004 年分析 DCCT 试验中 172 名糖尿病患者的微量白蛋白尿数据时,修正 Poisson 回归估计的风险比为 2.95;若把 logistic 回归给出的优势比 4.87 当作风险比,会高估 65%。优势比也有风险比替代不了的地方:病例对照研究无法直接估计风险比,而优势比在队列研究和病例对照研究中是同一个量,这也是 logistic 回归在流行病学中常被选用的理由。
系数解释与可复算算例
βⱼ 表示其他预测变量保持不变时,xⱼ 每增加 1 个单位,对数优势的变化量;exp(βⱼ) 是优势的乘数,也就是该变量校正后的优势比。截距的指数 exp(β₀) 是所有预测变量都取 0 时的优势,变量多时这个“基线”未必对应真实存在的人群。βⱼ>0 表示事件的优势和概率都随 xⱼ 增大而上升,βⱼ<0 则相反。连续变量的单位会改变优势比的数值:年龄按 10 岁为单位时,优势比是按 1 岁为单位时的 10 次方。
优势比在整条曲线上是恒定的乘数,概率的变化量却随基线而变。对 π 求导得 dπ/dx = β·π(1−π),在 π = 0.5 时最大,等于 β/4。例如某连续变量 β = 0.2,每增加 1 个单位,优势乘以 e^0.2 ≈ 1.22;基线概率在 50% 附近时,概率约上升 5 个百分点,基线概率为 10% 时只上升约 1.8 个百分点。因此报告结果时,宜同时给出优势比和典型取值下的预测概率或概率差。
可复算算例:假设一项队列研究中,暴露组 100 人有 40 人发生结局,非暴露组 100 人有 20 人发生。
| 组别 | 发生 | 未发生 | 风险 | 优势 |
|---|---|---|---|---|
| 暴露 | 40 | 60 | 0.40 | 40/60 ≈ 0.667 |
| 非暴露 | 20 | 80 | 0.20 | 20/80 = 0.25 |
- 风险比 RR = 0.40 ÷ 0.20 = 2.00;优势比 OR = 0.667 ÷ 0.25 = (40×80)/(60×20) ≈ 2.67。
- 以暴露(是 = 1,否 = 0)为唯一预测变量拟合 logistic 回归,极大似然估计与列联表结果一致:β₀ = ln 0.25 ≈ −1.386,β₁ = ln(8/3) ≈ 0.981。代回模型,非暴露组 π = 0.25/1.25 = 0.20,暴露组 η = −0.405,π = 0.667/1.667 = 0.40,正好还原两组的观测风险。
- 对数优势比的标准误 SE = √(1/40 + 1/60 + 1/20 + 1/80) = √0.1042 ≈ 0.323,Wald 统计量 z = 0.981 ÷ 0.323 ≈ 3.04。95% 置信区间先在对数尺度上计算:0.981 ± 1.96 × 0.323,得 (0.348, 1.613);取指数后,OR 的 95% 置信区间为 1.42 至 5.02。
- 用换算式核对:RR = 2.67 ÷ (1 − 0.20 + 0.20 × 2.67) = 2.67 ÷ 1.333 = 2.00。初始风险乘以 OR 约为 0.53,小于 1;OR 比 RR 高出约 33%,在“高估不超过一倍”的范围内。
- 若把两组风险改为 4% 和 2%(罕见结局),RR 仍为 2.00,OR = (4/96) ÷ (2/98) ≈ 2.04,两者几乎重合。
诊断、过拟合与适用边界
整体拟合方面,模型含连续预测变量时,每种协变量组合往往只有一个观测,Pearson X² 和偏差 G² 不再近似服从卡方分布,不宜直接用来检验拟合优度。常见替代做法有两种:与加入其他变量、二次项或交互项的更大模型比较偏差之差;或做 Hosmer–Lemeshow 检验,即按预测概率把观测分成 g 组,比较各组观测与期望的事件数,近似服从自由度为 g−2 的卡方分布。宾州州立大学 STAT 504 讲义提醒,这个检验偏保守,对非线性等失拟的检验效能低,结果依赖分组方式,组数太少(如不超过 5 组)时几乎总是不拒绝原假设,所以“不显著”不能当作模型正确的证据。逐个观测的诊断可看 Pearson 残差、偏差残差和 DFBETA 等影响统计量。
过拟合是指模型在开发数据上的预测过于极端:高风险者的预测概率太接近 1,低风险者太接近 0,换到同一人群的新样本就失准。流行的经验法则是每个候选参数至少对应 10 个事件(10 EPV,事件数取两类结局中较少的一类),Peduzzi 等人 1996 年的模拟研究是其主要依据之一。van Smeden 等人 2016 年比较多项模拟研究后认为,这条规则的证据很弱:小样本问题还取决于总样本量等因素,极大似然系数在小样本中会系统性地偏离 0、高估关联强度。Riley 等人 2020 年在 BMJ 提出按候选参数个数、结局比例和预期 Cox–Snell R² 计算开发样本量,目标之一是所需收缩因子达到 0.9,即收缩不超过 10%,并提供了 R 和 Stata 的 pmsampsize 程序包。按他们的例子,20 个候选参数、预期 R² 至少 0.1 的 logistic 模型需要 1698 人;若结局比例为 0.3,相当于每个参数约 25.5 个事件,远高于 10。
样本小、变量多时还容易出现“分离”:某个变量或变量组合把事件和非事件完全分开,极大似然估计没有有限解,软件可能不收敛,或报出极大的系数和标准误,不同软件的结果也可能相差很大。van Smeden 等人的模拟显示,Firth 校正(在似然函数上加惩罚项)在分离数据中仍能给出有限的系数,并能改善小样本系数的准确性。
以下情形不宜硬套普通 logistic 回归:
- 研究要报告风险比,而结局并不罕见:队列研究和试验可用对数链接的二项回归直接估计风险比;它对初始值敏感、可能不收敛,可改用 Zou 提出的修正 Poisson 回归(Poisson 回归加稳健“三明治”方差)。Zou 还指出,把校正后的优势比直接套公式换成风险比,未必得到一致估计。
- 观测不独立:同一对象的重复测量、整群抽样或整群随机化违反独立性假设,需要边际模型或随机效应(多层)模型。
- 结果不止两类:有序或无序的多分类结果可用有序或多项 logistic 模型,而不是先人为合并成两类。
- 关心“何时”发生,且有删失:随访时间不一、有人中途失访时,只看是否发生会丢掉时间信息,这类问题属于生存分析。
- 出现分离或事件很少:改用 Firth 校正等惩罚估计,同时减少候选变量。