
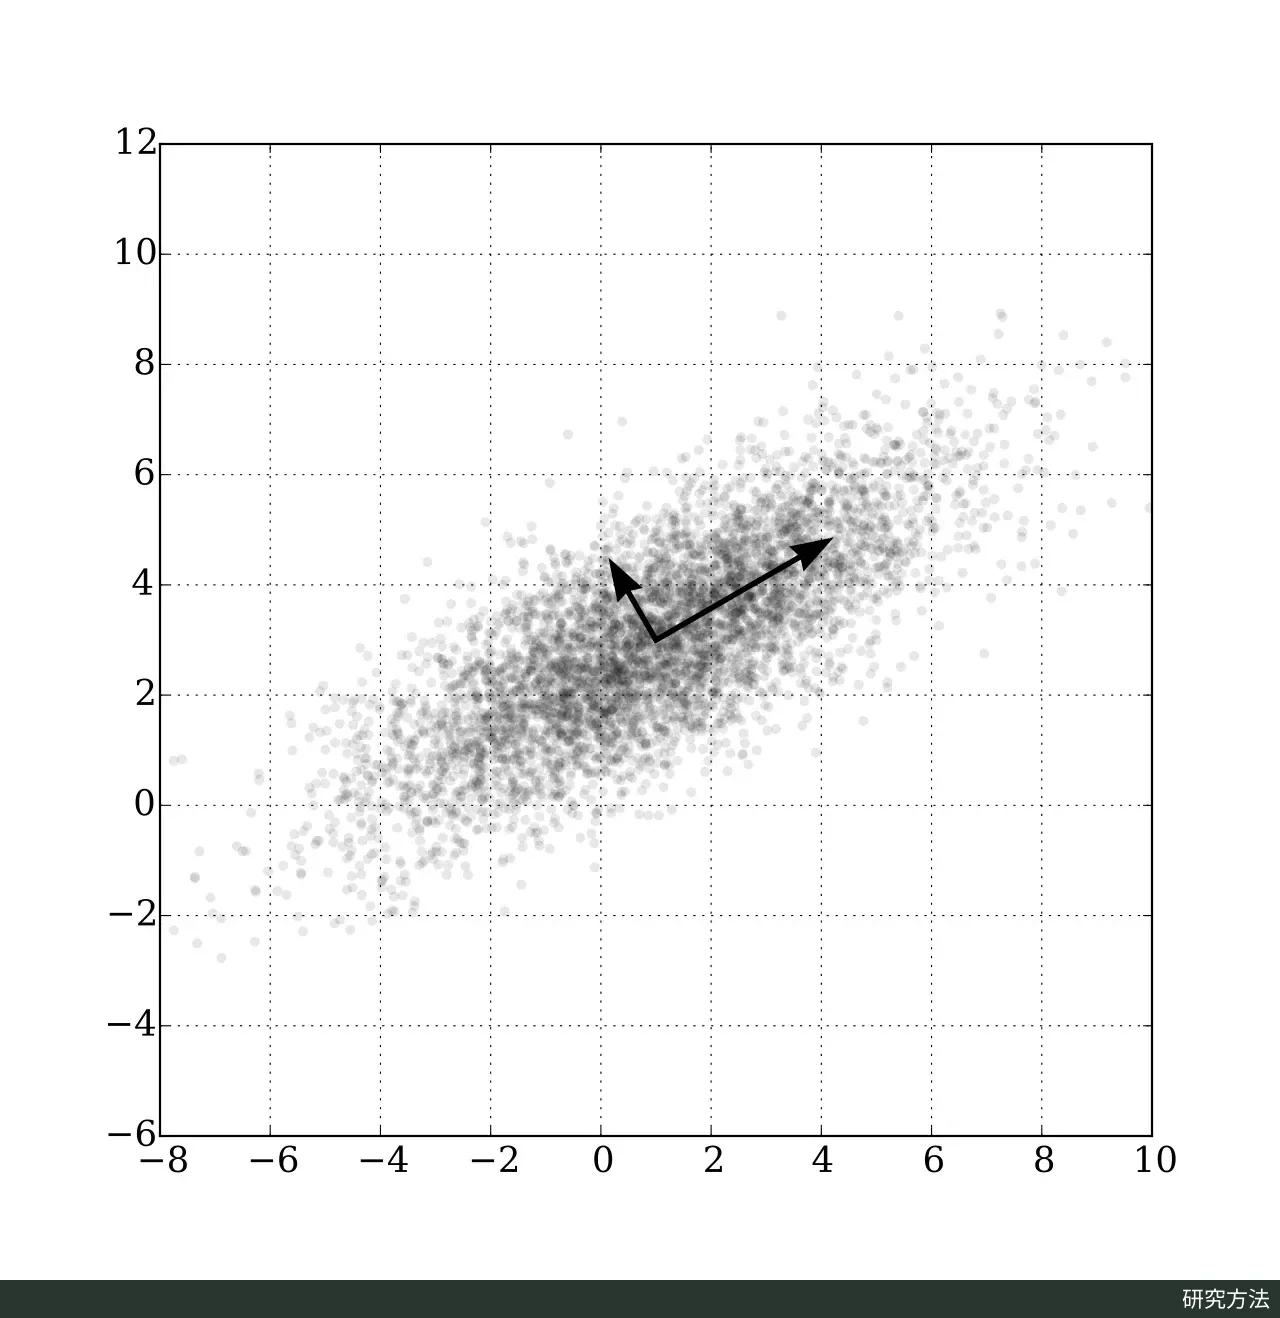
二维正态分布样本的散点图,两支箭头分别指向方差最大的方向(第一主成分)和与之正交的方向(第二主成分)。作者:Nicoguaro;来源:Wikimedia Commons;许可:CC BY 4.0。

主成分分析(PCA)把一组彼此相关的数值变量改写成互不相关的线性组合,并按方差从大到小排序,用前几个主成分概括数据的大部分变异。它由 Pearson 于 1901 年提出、Hotelling 于 1933 年命名。本条目介绍其原理、载荷与得分的读法、主成分个数的选择、与因子分析的区别和常见误用,并附可复算的 R 算例与碎石图。
从相关变量到正交主成分
设有 p 个数值变量 X₁,…,Xₚ。PCA 先找一个线性组合 PC1 = a₁₁X₁ + … + a₁ₚXₚ,在系数向量长度为 1 的约束下让它的方差最大;第二主成分在与第一主成分不相关的前提下方差最大,依此类推,最多得到 p 个主成分。Jolliffe 与 Cadima(2016)的综述把这概括为“构造逐次最大化方差、彼此不相关的新变量”,求解归结为协方差矩阵或相关矩阵的特征值—特征向量问题:特征向量给出组合系数,对应的特征值就是该主成分的方差。几何上,这相当于把坐标轴旋转到数据云拉得最长的方向(见题图);Pearson 1901 年论文的题目正是“空间中点系的最佳拟合直线与平面”。
动手之前要先决定用协方差矩阵还是相关矩阵。PCA 对量纲敏感,方差大的变量会主导第一主成分。变量单位不同或方差相差悬殊时,通常先把每个变量标准化,相当于对相关矩阵做 PCA。R 的 prcomp 文档就以 USArrests 数据为例:各变量方差相差几个数量级,直接 prcomp(USArrests) 是“不恰当的”,应设 scale. = TRUE。
计算上,prcomp 对中心化(及标准化)后的数据矩阵做奇异值分解,而不是对协方差矩阵求特征分解,数值精度更好;方差以 N−1 为除数。还要注意,特征向量的正负号是任意的,不同软件、甚至同一软件的不同构建都可能整列反号,解读时只看同一主成分内各系数的相对符号。
载荷、得分与主成分个数
“载荷”在文献和软件里有两种用法。一种指特征向量本身(R 中的 rotation,每列平方和为 1);另一种是特征向量乘以对应主成分的标准差,在标准化 PCA 中它等于原变量与主成分的相关系数,平方后就是该主成分解释这个变量方差的比例,UCLA OARC 的讲义用的是后一种。读别人的报告时,先确认载荷指哪一种。得分则是每个观测在主成分上的坐标,等于标准化数据乘以特征向量矩阵;各主成分得分互不相关,方差等于对应特征值,可以用于作图、聚类或作为后续模型的输入。
以 USArrests 为例:它记录 1973 年美国 50 个州每 10 万居民的谋杀、袭击、强奸逮捕数和城市人口比例。标准化后四个特征值为 2.480、0.990、0.357、0.173,合计为 4(变量个数),分别解释 62.0%、24.7%、8.9%、4.3% 的方差,前两个累计 86.8%。PC1 上三项犯罪变量的系数相近(−0.536、−0.583、−0.543),城市人口比例较小(−0.278),可以读作“总体犯罪水平”;PC2 由城市人口比例主导(系数绝对值 0.873),可以读作“城市化程度”。换算成相关系数,城市人口比例与 PC2 的相关约为 0.87,前两个主成分合计解释了它约 95% 的方差。这些名字是分析者的解读,不是数据本身给出的结论。
保留几个主成分没有唯一答案,常用的规则有四类:
- 累计方差比例:保留到累计解释方差达到事先设定的比例(如 80%)为止;比例本身是约定,不是定理。
- Kaiser 准则:对相关矩阵保留特征值大于 1 的成分(Kaiser,1960),含义是一个主成分至少要比单个标准化变量解释得多。
- 碎石图:Cattell(1966)建议按序号画出特征值,在曲线由陡降转为平缓的拐点处截断;拐点的判断带有主观性。
- 平行分析:Horn(1965)用同样规模的随机数据计算特征值,只保留实际特征值高于随机特征值的成分,以扣除抽样误差造成的虚高。
在 USArrests 上,这几条规则并不一致:Kaiser 准则只保留 PC1,因为 PC2 的特征值 0.990 差一点到 1;碎石图在第 3 个成分处转平,按拐点之前截断是 2 个;累计 86.8% 的比例也支持保留两个。规则只是参考,最终要看主成分用来做什么。
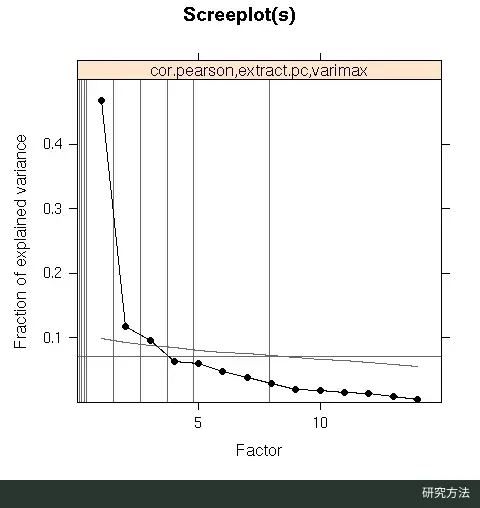
Boston Housing 数据因子分析的碎石图:黑线为各成分解释的方差比例,灰色水平线分别对应 Kaiser 准则和 Horn 平行分析,竖线标出累计方差比例。作者:Sigbert;来源:Wikimedia Commons;许可:CC BY-SA 3.0。

USArrests 数据的 R 算例
下面的代码只用到 R 自带的 stats 和 graphics 包,USArrests 随 R 一起发行,可以直接复算。输出的标准差、旋转矩阵和方差比例与 ISLR tidymodels 实验页给出的结果一致,只是某些列的符号可能整体相反。
# USArrests ships with base R: 50 US states, 1973
data(USArrests)

# Standardise variables (correlation-matrix PCA); prcomp uses SVD
pca <- prcomp(USArrests, center = TRUE, scale. = TRUE)

summary(pca)              # standard deviations and proportion of variance
eig <- pca$sdev^2         # eigenvalues
round(eig, 3)             # 2.480 0.990 0.357 0.173
round(pca$rotation, 3)    # eigenvectors; column signs are arbitrary

# Variable-component correlations (eigenvector * component sd)
round(cor(USArrests, pca$x), 3)

# Scores of the first states on PC1 and PC2
head(round(pca$x[, 1:2], 2))

# Scree plot with the Kaiser reference line
plot(eig, type = "b", pch = 19, xaxt = "n",
     xlab = "Principal component", ylab = "Eigenvalue",
     main = "Scree plot: USArrests (standardised)")
axis(1, at = seq_along(eig))
abline(h = 1, lty = 2, col = "grey40")

# Optional: parallel analysis (requires the psych package)
# psych::fa.parallel(USArrests, fa = "pc")
运行后,summary 给出的累计方差比例依次为 0.620、0.868、0.957、1.000。碎石图上,特征值从第 1 个到第 2 个成分骤降,第 2 到第 3 个继续明显下降,之后趋平;虚线 y = 1 从第 2 个点上方紧贴着掠过,直观显示出 Kaiser 准则与拐点判断的分歧。Python 用户可以用 statsmodels 的 get_rdataset("USArrests") 下载同一数据(需联网),标准化后交给 sklearn.decomposition.PCA;StandardScaler 以 N 而非 N−1 为除数,特征值会相差 N/(N−1) 倍,方差比例和载荷方向不受影响。
与因子分析的区别和常见误用
PCA 和因子分析都用到变量的线性组合,在 SPSS 里甚至共用同一个菜单,但模型不同。PCA 是对观测变量的变换,没有误差项,目标是用少数成分保留尽量多的总方差,相当于假定不存在独特方差。共同因子分析则是生成模型:观测变量等于载荷乘以潜在因子再加上各自独立的误差,因子只负责解释变量之间的共同方差。scikit-learn 文档把两者放进同一框架:误差协方差为 σ²I 时得到概率 PCA,为对角阵 diag(ψ₁,…,ψₚ) 时就是因子分析,后者允许每个变量有不同大小的噪声。
实务上,目的是压缩变量、构造综合指标或给后续模型降维时用 PCA;相信题目之间的相关由某个潜在构念(如焦虑、智力)驱动,并希望把测量误差分离出去时用因子分析,后者常配合 varimax 等旋转以便解释。多数情况下两者结果相近,但并不总是如此,Jolliffe 的教材第 7 章专门讨论了二者的区别。
最常见的误用是把相关当因果。主成分只是相关结构的另一种写法:USArrests 的 PC1 把三项犯罪率概括在一起,说明它们在各州之间同升同降,既不说明城市化导致犯罪,也不证明存在一个叫“犯罪倾向”的实体。给主成分起名是解释;把主成分得分放进回归,得到的系数也只是原变量组合的关联。主成分方向由手头数据决定,而不是事先设定(Jolliffe 与 Cadima,2016),换一批样本可能改变,因果判断仍要靠研究设计。
第二类误用是对类别变量硬套。PCA 建立在方差和线性相关之上,适用于数值变量。把性别、地区编成 1、2、3 直接放进去,等于假设类别之间有顺序且等距,算出来的“方差”没有实际意义。以类别变量为主的数据可以改用多重对应分析(MCA),FactoMineR 的示例就用 MCA 分析了 300 名茶饮消费者的类别型问卷回答;Jolliffe 与 Cadima(2016)也介绍了针对不同数据类型的 PCA 变体。此外,在预测建模中,PCA 只能在训练集上拟合,再套用到验证集,否则会造成数据泄漏。