
Universal Ai 大学心理学实验室(示意,非本项目重复实验现场)。摄影:ManoBV16,来源:Wikimedia Commons,许可:CC0 1.0。
2015 年 8 月 28 日,开放科学合作组织在《科学》发表“心理学可重复性项目”的结果:270 位作者对 2008 年三本心理学期刊上的 100 项研究做了直接重复。原研究 97% 报告显著结果,重复研究只有 36% 达到显著,平均效应量约降为原来的一半。本文拆解这项“研究之研究”的抽样、对照、样本量、测量与偏差控制,并说明结论能推广到哪里。
抽样框与选题流程
项目从 2011 年 11 月开始制定方案。研究者没有从整个心理学文献中随机抽样,而是事先划定一个“准随机”抽样框:2008 年出版的《心理科学》(Psychological Science)、《人格与社会心理学杂志》(JPSP)和《实验心理学杂志:学习、记忆与认知》(JEP:LMC)上的全部论文。选这三本,是为了兼顾综合期刊与社会、认知两个子领域,同时让论文既新到还能拿到原始材料,又旧到能看出引用影响。
论文不是一次性全部放出:最初每本期刊只开放前 20 篇供志愿团队认领,配对得差不多了,再按 10 篇一批追加。这样既能让团队按兴趣和专长选题,又因为每次可选范围小,压缩了专挑“好重复”研究的空间。每篇论文默认重复最后一项实验,理由是多实验论文的第一项往往只是初步演示;100 次重复中有 84 次遵守了这条默认规则,偏离原因写进各自的报告。每项研究还要事先指定一个能用单个检验或效应量表达的“关键结果”,交原作者审阅。
最终的筛选漏斗是:三本期刊 2008 年共 488 篇论文,2011 年 11 月至 2014 年 12 月间有 158 篇进入可认领池,111 篇被认领、产生 113 次重复,到截止日完成 100 次,来自 98 篇论文(两篇各重复了两次)。未被认领的 47 篇里,6 篇被判定不可行,其余多需要猕猴、自闭症被试、眼动仪或功能磁共振等特殊资源。也就是说,选题环节没有随机化,资源门槛本身就在筛选样本。
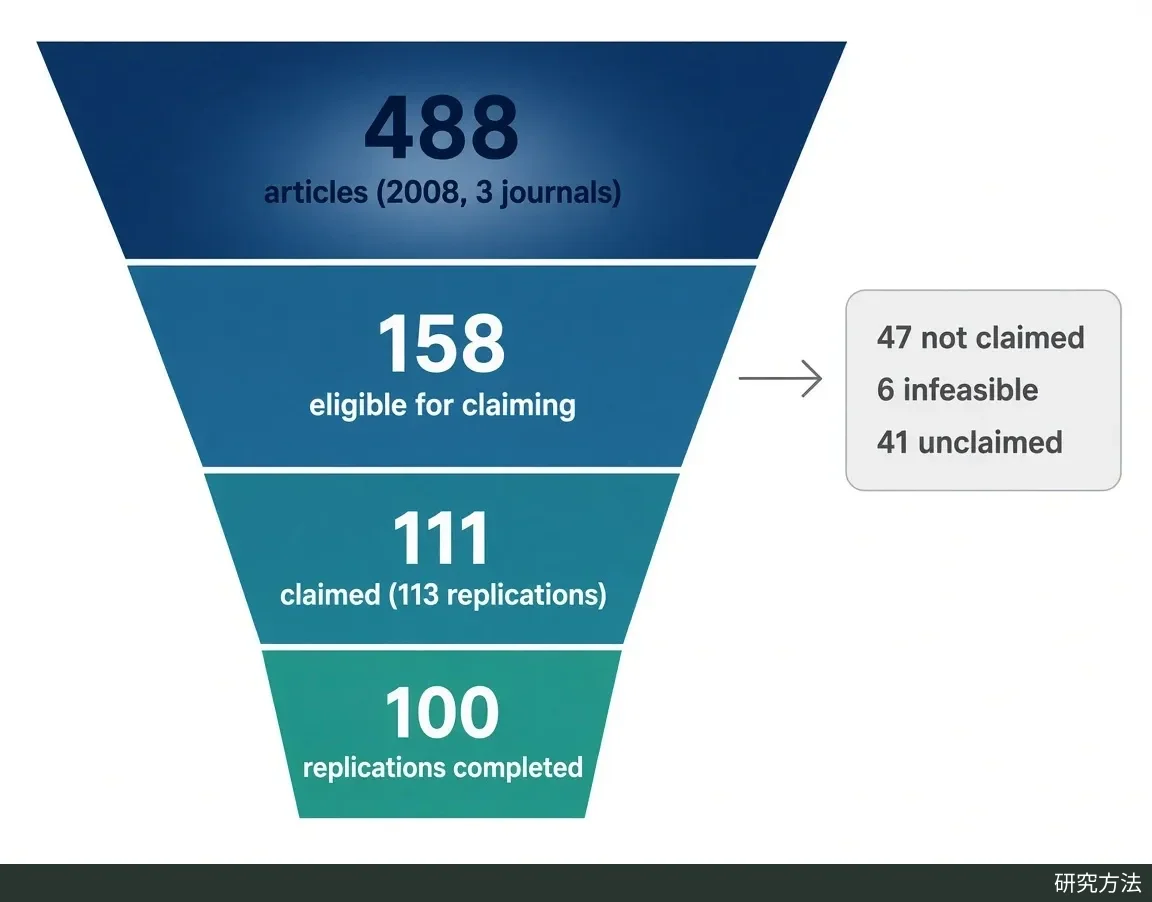
AI 生成示意图:心理学可重复性项目的选题漏斗,数字据 Open Science Collaboration(2015)。
成对对照、样本量与测量
这项研究里的“比较”不是两组被试,而是成对的研究:每个原研究与它的重复研究构成一对,分析单位是两边的效应量。被试层面的随机分组则沿用原研究设计——原研究随机分配条件,重复研究也随机分配;原研究本是相关研究,重复也只能是相关研究。论文说重复的是“100 项实验研究和相关研究”,指的就是这一点。
为了让每一对比较尽量公平,方案规定了几道工序:联系原作者索取原始材料;撰写研究方案和分析计划,交原作者与项目内部成员审阅;在开放科学框架(OSF)公开注册方案后再收集数据;完成后由独立审核者检查材料、数据和报告,再由另一名分析者用统一的 R 脚本重算每项结果。关键结果和分析计划都事先锁定,因此重复一侧不存在选择性报告。
样本量按原研究效应量做功效分析确定,要求统计功效至少 80%。97 个原本显著的效应,其重复研究的平均功效为 0.92(中位数 0.95)。照此推算,如果原效应全部为真且估计准确,应有约 89 个重复达到显著,这就是后面结果的参照线。需要留意的是,功效按原研究报告的效应量计算;如果原效应量被高估,真实功效会低于纸面数字。
测量上,项目把 t、F、相关系数等不同检验统一换算成相关系数 r,并用五个指标判断“是否复现”:重复是否同方向达到 P < 0.05;原效应量是否落在重复研究的 95% 置信区间内;两边效应量的大小比较;原研究与重复研究合并的固定效应元分析;重复团队对“结果复现了吗”的主观判断。作者明确表示,没有单一标准能定义复现成功。
五项指标下的复现结果
按显著性标准,97 个原本显著的效应中只有 35 个在重复中同方向显著,占 36.1%(95% 置信区间 26.6%–46.2%),远低于预期的约 89 个。原效应量落在重复研究 95% 置信区间内的比例为 47.4%;重复团队主观判断复现的有 39 项。效应量均值从原研究的 r = 0.403 降到 0.197;在能同时算出两边效应量的 99 对中,82 对原研究更强。若假设原研究没有偏倚,把两边合并计算,可算出元分析估计的 75 个效应中有 51 个(68%)仍然显著。
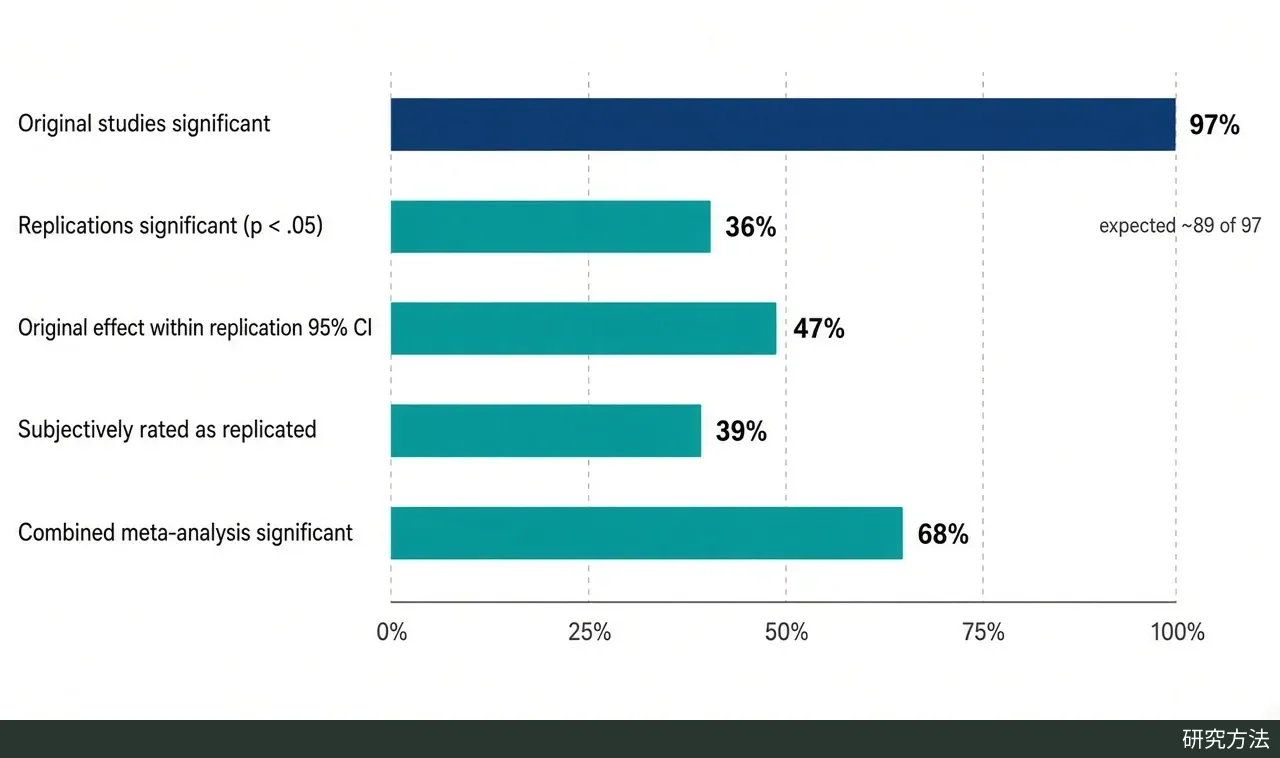
AI 生成示意图:原研究显著率与四项复现指标对比,数字据 Open Science Collaboration(2015)。各指标分母不同:显著性指标 n = 97,元分析指标 n = 75。
子领域差异明显:以 P < 0.05 计,社会心理学效应复现 14/55(25%),认知心理学 21/42(50%),但各期刊与子领域的效应量缩水幅度相近。检验类型也有关系:检验主效应或简单效应的 49 个中复现 23 个(47%),检验交互作用的 37 个中只有 8 个(22%)。原研究证据越强越容易复现:原 P < 0.001 的 32 项中有 20 项复现,原 P > 0.04 的 11 项中只有 2 项。相比之下,团队经验、专长和自评质量与复现结果的关联很弱。
偏差控制的边界与推广范围
这个设计在重复一侧控制住了发表偏倚和选择性报告:所有结果都公开,分析都按预注册计划进行。但它控制不了另外几类偏差。一是选题偏差:只覆盖能被认领、成本较低、能在截止前完成的研究,每篇论文只重复一项研究,每项研究只检验一个效应,作者自己也承认选择偏差的影响未知。二是保真度:材料和程序尽量沿用原版,但样本、场景和时间都变了,未预料的因素仍可能改变效应大小。三是复现率与原研究特征的关系都属于相关证据,不能当作因果结论。
2016 年 3 月,Gilbert、King、Pettigrew 和 Wilson 在《科学》发表评论:约 69% 的原作者认可了重复方案,按置信区间指标,认可组复现率为 59.7%,未认可组仅 15.4%,他们据此认为方案偏离把结果推向了失败。原团队 Anderson 等人在同期回应:项目中“重复与原研究的相似度”评分与复现成功的相关很弱(以显著性标准计 r = 0.015);不认可也可能反映原作者对自己研究稳健性信心不足,这同样是相关数据,不能直接作因果解读。双方都同意,方法差异和统计功效都会影响复现率。
因此,这项结论能推广的范围相当具体:它估计的是 2008 年这三本期刊里、资源门槛较低、能被志愿团队认领的那部分研究,其单个关键效应的复现情况。作者写明,这些发现能否推广到心理学其他领域或其他学科尚不清楚。它是一种“广而浅”的设计,能给出总体复现率的初步估计,对任何单个效应的精度却有限;要弄清某一个效应,需要像 Many Labs 那样对单一效应做多点重复的“窄而深”设计。论文结语也说,经过这番努力,被确证为真或为假的效应都是零——单次研究很少能下定论。