
洗牌:打乱顺序、重新分组,正是置换检验的基本动作。图:rockbadger,《Shuffling small playing cards》,来源 Flickr(https://www.flickr.com/photos/9139977@N05/6525477807),许可 CC BY 2.0(https://creativecommons.org/licenses/by/2.0/)。
置换检验(permutation test)不预设数据服从正态等特定分布:它在“处理无效”的零假设下反复打乱组别标签,用数据自己生成的参照分布判断观测到的差异是否罕见。这一思路可追溯到 Fisher 1935 年的《实验设计》。本文讲清它解决的问题、核心思路、使用前提和常见误用,并用一个 7 名患者的小例子演示计算。
解决的问题与核心思路
经典检验的 p 值建立在分布假设之上。Ernst(2004)以单样本 t 检验为例:只有当数据来自正态分布时,第一类错误(错误地拒绝真实的零假设)的概率才恰好等于事先选定的显著性水平 α;数据不服从正态分布时,统计量不再服从 t 分布,实际的第一类错误率可能与 α 有明显差距,研究者对误差的控制并没有 α 所显示的那么牢靠。置换检验换了一个参照物:不去查理论分布表,而是从手头的数据出发,构造零假设下的分布。
它的推理很朴素。如果处理确实没有作用,那么每个观测值无论被分到哪一组都会是同一个数,组别标签只是随机贴上去的,可以互相交换。具体做法分四步:先选定一个统计量,例如两组均值之差;在原始分组上算出它的观测值;再把全部观测合并,按原来的组大小重新分组,对每一种分法重算统计量,得到零假设下的参照分布;最后数一数参照分布中有多大比例与观测值同样极端或更极端,这个比例就是 p 值。Ernst 转引 Fisher(1936)的话:统计学家通常并不亲手做这个“非常简单又非常繁琐”的过程,但其结论之所以成立,只是因为它们与这种初等方法会得出的结论一致。如今有了计算机,已经没有理由不直接去做。
统计量可以按研究问题选择,均值差、中位数差、截尾均值都可以。把两组数据合并排秩,再用其中一组的秩和作统计量,得到的就是 Wilcoxon 秩和检验,所以秩检验可以看作置换方法的一种。分法太多、无法逐一枚举时(Ernst 举例说,30 个观测平分成两组就有超过 1.55 亿种分法),可以随机抽取 M 次重排做蒙特卡洛近似。这一做法由 Dwass(1957)提出,Ernst 认为通常几千次就足以较准确地估计精确 p 值;单侧 p 值按“(1 + 重排统计量不小于观测值的次数) / (M + 1)”计算,相当于把观测值本身也算作参照分布的一员。
Ernst 还强调要分清两种概率模型。如果研究对象是被随机分配到各处理组的,推断依据就是随机分配本身,这时常称为随机化检验(randomization test),结论只适用于参与研究的这批对象。如果数据是从两个总体中随机抽取的样本,同样的计算称为置换检验,其理论依据由 Pitman(1937)阐述,结论可以推广到总体,但零假设变成“两个总体的分布完全相同”。两者计算步骤相同、含义不同,实践中这两个名称常被混用。
实例:7 名患者的恢复时间
下面的数据来自 Ernst(2004)的演示例子:7 名术后患者中,4 人被随机分配接受新疗法,3 人接受标准疗法,关心的问题是新疗法能否缩短恢复时间。新疗法组的恢复天数为 19、22、25、26,平均 23 天;标准疗法组为 23、33、40,平均 32 天。观测到的均值差(新疗法减标准疗法)为 −9 天。
如果新疗法无效,那么 19 天康复的那位患者即使接受标准疗法,也会在 19 天康复,变化的只是谁被分到哪一组。从 7 人中选 4 人进入新疗法组共有 C(7,4) = 35 种分法,在零假设下每种分法的概率都是 1/35。逐一计算 35 种分法下的均值差,不大于 −9 的只有 3 种(−9.00、−10.17、−10.75,其中 −9.00 就是实际分组),因此单侧 p 值为 3/35 ≈ 0.086。Ernst 的判断是:这只构成中等程度的处理效应证据。
这个例子也说明了“精确”的含义。35 种分法决定了 p 值只能取 1/35 的某些倍数;若把显著性水平取为其中一个可达值,第一类错误概率就恰好等于 α,若取的不是可达值,检验则偏保守。这一保证只依赖一个条件:患者是被随机分配的。换用中位数差作统计量,本例同样得到 3/35。
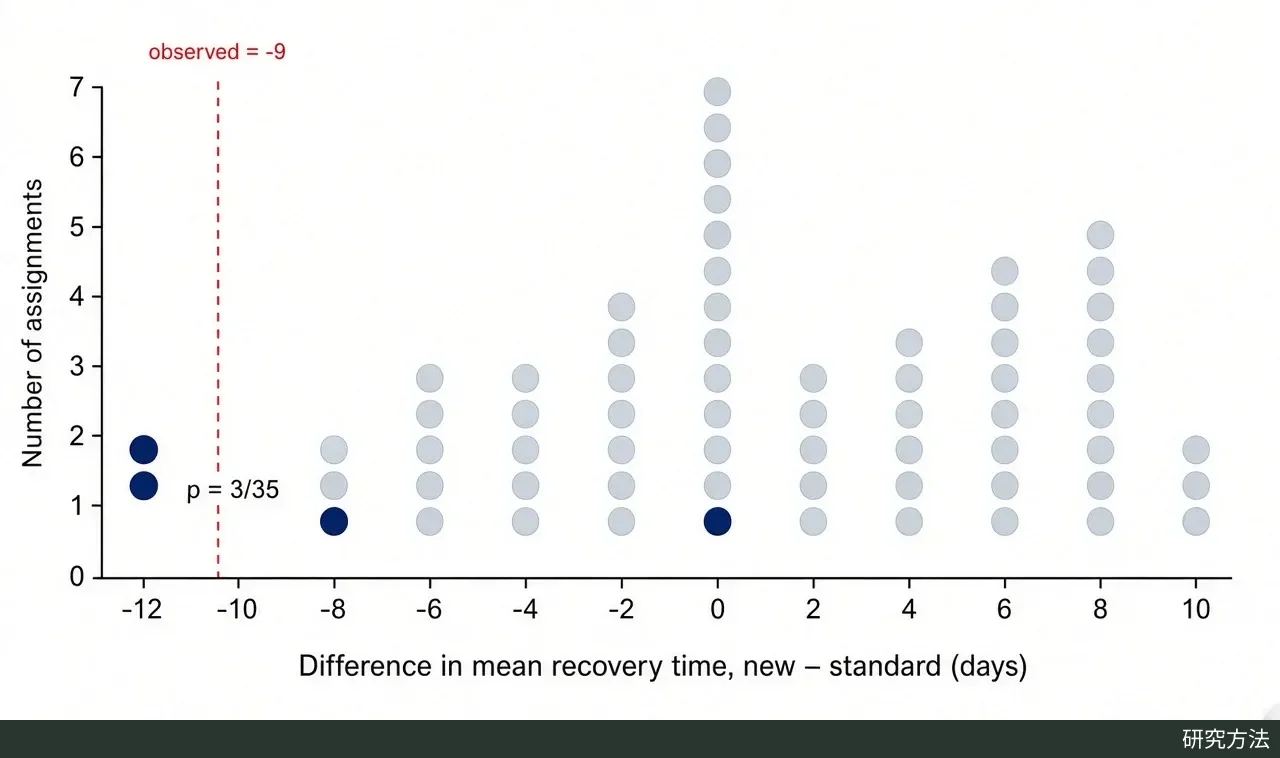
AI 生成示意图:示意 Ernst(2004)表 1 中 35 种等可能分组下均值差的随机化分布,深色点表示与观测值同样极端或更极端的分组。图中点的数量与位置并不精确,准确结果以正文为准:均值差不大于 −9 的分组共 3 种,p = 3/35。
使用前提:可交换性
“不靠分布假设”不等于没有假设。置换检验的核心前提是可交换性(exchangeability):在零假设下,打乱观测的顺序或标签不改变它们的联合分布。Winkler 等(2014)在一般线性模型的置换推断框架中给出了这一定义,并指出可交换性比独立性更宽,可交换的误差之间允许存在全部相同的相关。在随机化实验里,这一前提由随机分配本身保证;在观察数据中,则需要研究者论证零假设下各观测确实可以互换。
重排方式必须与研究设计和零假设相匹配。SciPy 的 permutation_test 把常见情形分成三类:独立样本在组间重新分配观测,对应独立样本 t 检验和 Mann–Whitney U 检验;配对样本只在每一对内部交换,若只看差值,相当于随机翻转每个差值的正负号,对应配对 t 检验和 Wilcoxon 符号秩检验;相关分析保持每个变量自身的取值不变、只打乱变量之间的配对,对应 Pearson、Spearman 等相关系数。遇到重复测量这类结构,Winkler 等建议定义“交换块”(exchangeability blocks),只在块内置换或把整块作为单位置换,而不是把所有观测混在一起打乱。
常见误用
误用一:用均值差检验“均值相等”,却忽略方差差异。两样本置换检验严格检验的是“两组分布完全相同”。Chung 与 Romano(2013)指出,如果真正关心的是均值是否相等,基于样本均值差的置换检验只有在两组方差相等或样本量接近时,才能在大样本下保持名义水平;方差不等且样本量悬殊时,拒绝概率可能远高于名义水平,甚至会把实际为负的均值差判为显著为正。改用中位数差情况更糟,几乎只有两组分布相同时才能保持水平。他们的补救办法是使用学生化统计量(用各组方差估计做标准化的 t 型统计量):两组分布相同时检验仍然精确,只要求均值相等时也能在大样本下保持水平。
误用二:报告 p = 0。Phipson 与 Smyth(2010)发现,基因组学文献中由随机重排得到的 p 值常被算错,偏小约 1/m(m 为重排次数),根源在于把置换当成对尾部概率的估计,而不是把它看作生成了一个精确的离散零分布。这种偏差在绝对值上通常不大,但在多重检验的情境下后果可能很严重。他们建议用 (b + 1)/(m + 1) 计算,其中 b 是重排统计量至少与观测值一样极端的次数,因此 p 值永远不会为 0。SciPy 的 permutation_test 在随机重排时也采用这种分子、分母各加一的保守算法。
误用三:重排方式与设计不符,或把结论说得过宽。把配对数据当作两组独立样本打乱,或在有重复测量的数据里整体置换,都会破坏零假设下的可交换性,得到的参照分布也就不再可靠。另一方面,随机化实验中的随机化检验只对参与研究的对象作出推断;要把结论推广到更大的人群,需要随机抽样或另外的论证(Ernst,2004)。