
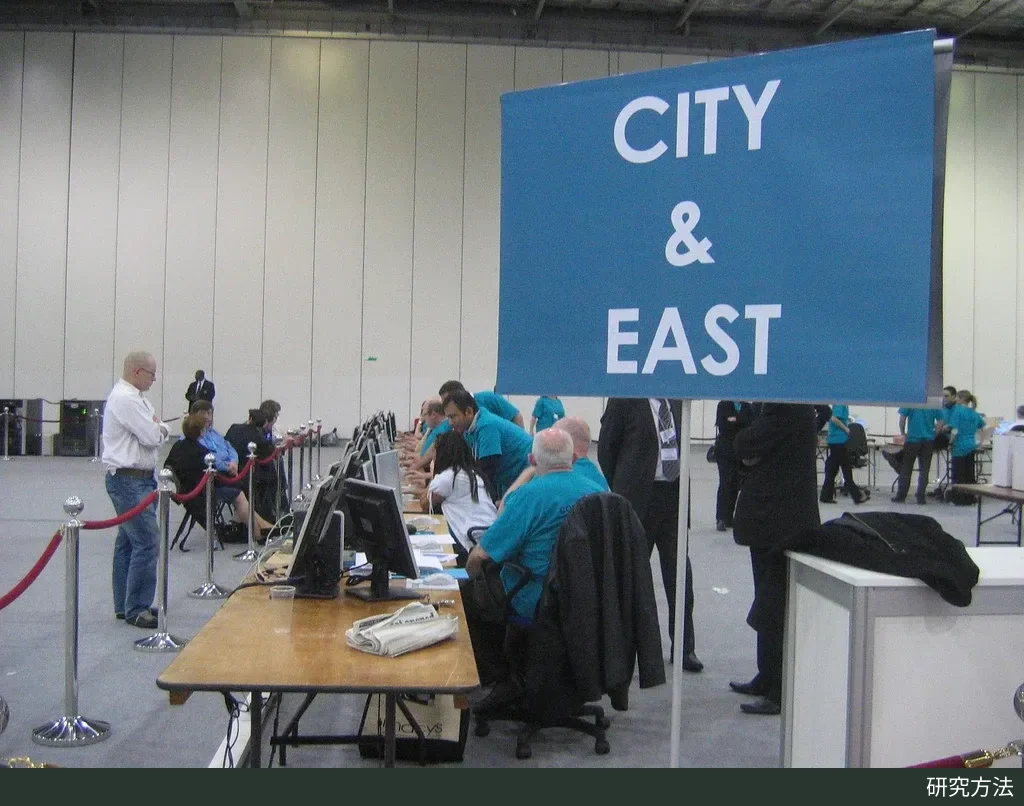
2008 年 5 月 2 日伦敦 ExCeL 计票中心的 City & East 计票区。选举中险胜与险负的对比,是断点回归“局部随机化”解读的典型场景。图:secretlondon123,来源 Flickr,许可 CC BY-SA 2.0。
当一项待遇按分数线、年龄线或得票过半来分配时,刚好过线和差一点没过的人往往十分相似。断点回归设计(regression discontinuity design,RD)正是利用这种“阈值附近近似随机”的结构,比较阈值两侧结果的跳跃来估计因果效应。本文介绍它解决的问题、核心思路、使用前提与常见误用,并以美国最低饮酒年龄研究为例。
问题与核心思路
观察数据里,接受处理的人和没接受的人往往本来就不一样。设想奖学金只发给考试高分的学生:如果直接比较获奖者与未获奖者日后的学业表现,差距里既有奖学金的作用,也混着“本来就更会考试”的那部分。断点回归最早由 Thistlethwaite 与 Campbell 在 1960 年提出,最初分析的正是按考试分数线发放奖励这类情形;Imbens 与 Lemieux(2008)指出,这一方法直到 20 世纪 90 年代末才开始在经济学中被大量应用和扩展。
RD 有三个关键要素:一个在处理之前就已确定的连续变量,称为驱动变量(running variable,也叫分配变量或得分);一个已知的阈值 c;以及“越过阈值就接受处理”的规则。它比较的不是全体处理组与对照组,而是紧挨在阈值两侧的人:在 c 的左右两侧分别拟合结果随驱动变量变化的曲线,两条曲线在 c 处的落差就是估计值,对应阈值处的平均处理效应 τ = E[Y(1) − Y(0) | X = c]。如果越过阈值使处理概率从 0 直接跳到 1,称为清晰断点(sharp RD);如果只是让处理概率发生跳变、两侧都有人不按规则接受处理,称为模糊断点(fuzzy RD),这时要用结果的跳跃除以处理概率的跳跃来估计效应(Hahn、Todd 与 van der Klaauw,2001;Imbens 与 Lemieux,2008)。
“局部随机化”这一解读来自 Lee(2008)。他证明:只要个体能影响自己的得分、却无法精确控制它——得分中总有一部分随机成分,且其密度连续——那么在阈值的一个小邻域内,是否接受处理就近似于随机分配。以美国众议院选举为例,候选人的得票率取决于经验和竞选投入,但最终计票总有不确定性,因此以微弱优势胜出和以微弱劣势落败的选区,在其他方面应当相似。这一解读带来一个可检验的推论:阈值两侧附近的处理前特征(基线协变量)分布应当一致,研究者可以像检查随机试验“随机化是否成功”那样去核对。
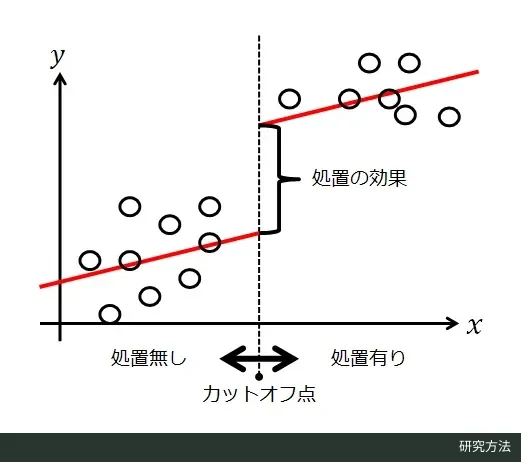
清晰断点示意:竖直虚线为阈值(カットオフ点),左侧未接受处理(処置無し),右侧接受处理(処置有り),两条拟合线在阈值处的落差即处理效应(処置の効果)。图:Munasca,来源 Wikimedia Commons,许可 CC BY-SA 4.0。
使用前提与检验
第一,分配规则必须已知且可观测:阈值是多少、驱动变量是什么、谁越过了阈值,都要能从数据中准确还原,而且驱动变量应在处理之前确定。第二,连续性:如果没有处理,结果的条件期望在阈值处应当平滑变化,不会自己跳一下。Hahn 等(2001)把这一条形式化为 RD 识别所需的最低连续性条件;Lee(2008)也强调,这一假设本身无法直接检验,只能通过它的推论间接检查。
第三,不能存在精确操纵。McCrary(2008)指出,当分配规则公开、个体又有能力调整驱动变量时,就会有人恰好挤到有利的一侧,表现为阈值上方的观测异常多、下方异常少。他据此提出检验驱动变量的密度在阈值处是否断开的方法:用在美国众议院普选数据上,没有发现分选;用在国会唱名表决的票数上,则发现了明显的操纵迹象。
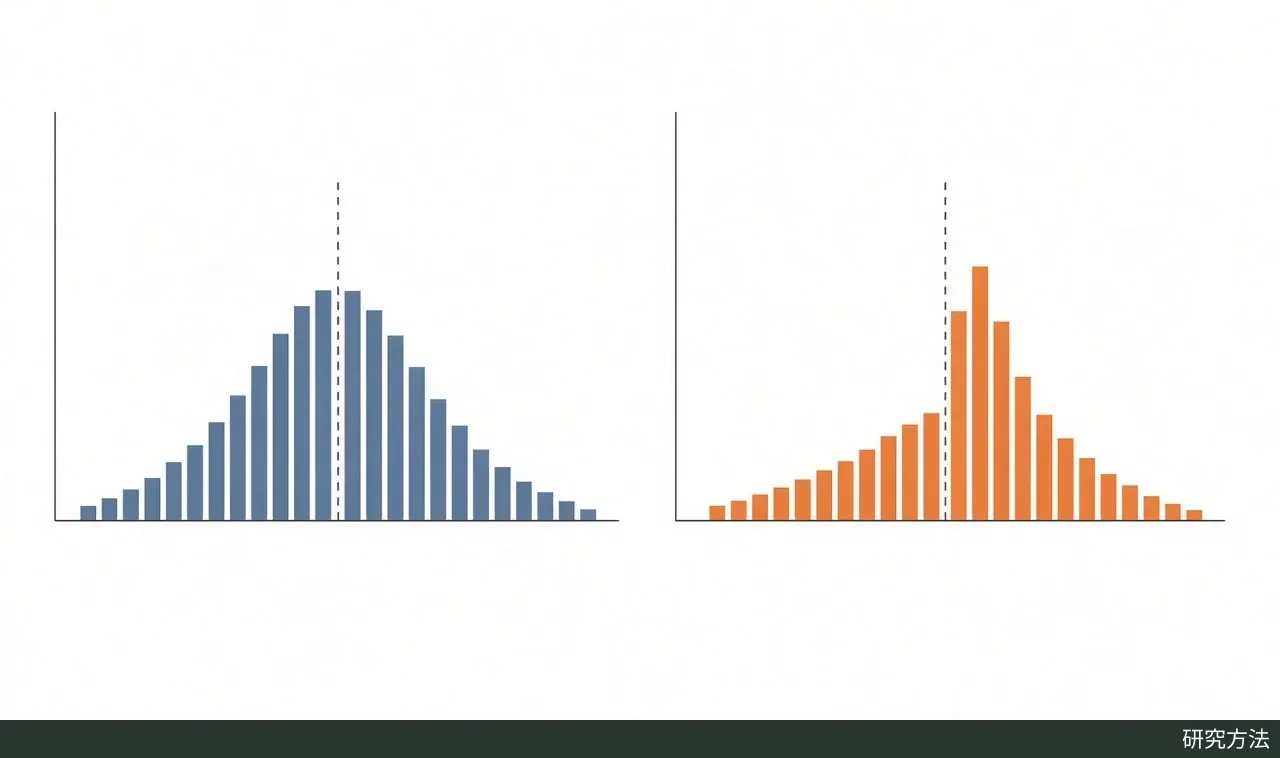
驱动变量分布示意:左图无操纵,直方图平滑穿过阈值(虚线);右图存在操纵,阈值下方偏少、上方堆积,密度在阈值处断开,对应 McCrary(2008)密度检验的直觉。AI 生成示意图。
第四,阈值处不应同时发生别的变化。Imbens 与 Lemieux(2008)举例说,人们到 65 岁时还会获得许多文化机构的优惠;如果用 65 岁做断点研究某项政策,结果的跳跃就可能混入这些优惠的影响。围绕这些前提,他们给出的实操步骤包括:先用分箱均值画图;只用阈值附近的观测做局部线性回归;有依据地选择带宽;再检验协变量和驱动变量密度在阈值处是否连续,并在没有政策变化的其他位置做“安慰剂断点”检验。
常见误用
一是用高阶全局多项式拟合整段数据。不少研究在全样本上控制驱动变量的三次、四次甚至更高次多项式。Gelman 与 Imbens(2019)认为这类估计可能产生误导,建议改用局部线性、局部二次或其他平滑函数。直观地说,高次曲线在数据两端最容易“甩动”,而 RD 关心的恰好是每一侧的端点;Imbens 与 Lemieux(2008)也提醒,阈值是边界点,普通的核回归在边界上表现不佳。
二是随意挑选带宽,只报告“好看”的结果。带宽决定纳入阈值两侧多远的数据:太窄则样本少、噪声大,太宽则把离阈值较远、可比性较差的观测也算进来。Imbens 与 Lemieux(2008)建议用数据驱动的方法选择带宽,并做敏感性分析;Calonico、Cattaneo 与 Titiunik(2014)进一步提出了 RD 的稳健非参数置信区间;Cattaneo 等(2020)的实务教材则围绕清晰断点的估计与推断整理了一套通用做法。较稳妥的做法是事先确定主分析的带宽选择方法,同时报告多个带宽下的估计。
三是跳过操纵检验与平衡检验。只要驱动变量是当事人能精确调整的量,例如可以自行申报、刚好卡在补贴门槛附近的收入,局部随机化的前提就可能被破坏。不做密度检验和基线协变量检验就直接解读阈值处的跳跃,等于默认“随机化”一定成功。
四是把阈值处的效应外推到全体,或把模糊断点当成清晰断点。RD 估计的是阈值附近人群的效应,Lee 与 Lemieux(2010)专门讨论了解读这类估计的局限:分数线附近学生得到的效应,不一定适用于分数远高或远低的学生,要外推就需要额外的假设或设计。在模糊断点中,如果直接把结果的跳跃当作处理效应,效应会被没有按规则接受处理的人稀释,应按前文的比值思路估计。
实例:最低饮酒年龄与死亡率
美国的法定最低饮酒年龄是 21 岁,年龄因此成了一个天然的驱动变量。Carpenter 与 Dobkin(2009)用断点回归比较刚满 21 岁与差一点满 21 岁的年轻人,发现饮酒在 21 岁时出现大而即时的增加,其中近期饮酒天数增加 21%;死亡率在 21 岁处出现约 9% 的跳升,主要来自机动车事故、与酒精相关的死亡和自杀。作者据此估计,年轻人的饮酒天数每增加 10%,死亡率约上升 4.3%。
这个例子能对应前文的几个要点。其一,生日无法临时更改,个体很难精确操纵驱动变量,局部随机化的前提相对可信;但仍需确认 21 岁这个节点上没有其他会影响死亡率的制度同时变化。其二,满 21 岁并不意味着所有人都开始喝酒,此前也并非无人饮酒,越过阈值改变的是饮酒程度而不是“从无到有”,属于模糊断点的思路:9% 的死亡率跳升与 21% 的饮酒天数跳升之比约为 0.43,与作者给出的换算一致。其三,结论描述的是 21 岁前后的年轻人,不能直接推到其他年龄段,也不能直接回答把饮酒年龄改为 18 岁会怎样。