
学生嵌套在班级里、重复测量嵌套在受试者身上时,同组观测彼此相似,普通回归会把标准误算得过小。多层模型(又称混合效应模型)用随机截距和随机斜率描述组间差异,用组内相关系数衡量相似程度。本文依据权威教材与 lme4 论文,介绍模型设定、REML 估计、设计效应和常见误用,并附可复算的 R 算例。
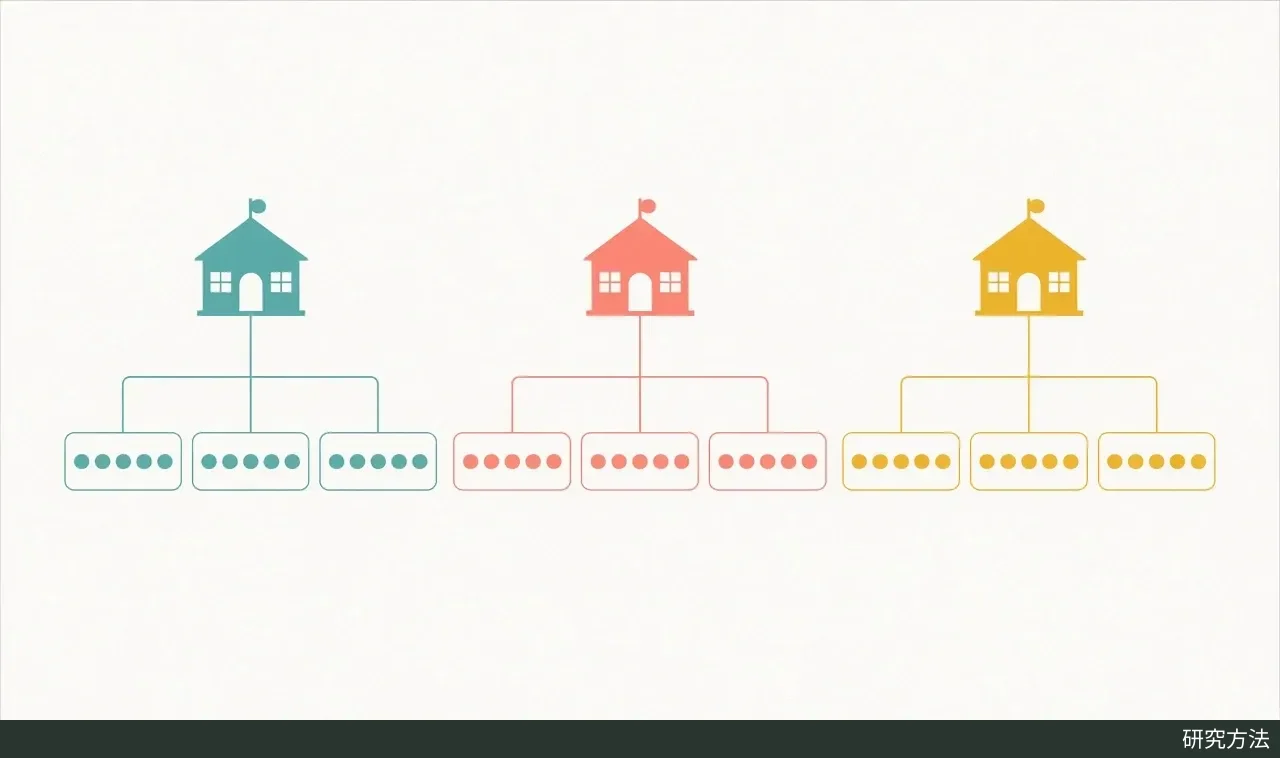
嵌套数据、组内相关与设计效应
教育、医学和心理学数据常带有嵌套结构:学生在班级里,班级在学校里;同一名受试者被反复测量,多次测量“嵌套”在这个人身上。同一组内的观测共享老师、家庭或个人体质,彼此更相似,而普通最小二乘回归假定每条观测相互独立。Gelman 与 Hill 把传统做法归为两个极端:完全合并(complete pooling)忽略组间差异,只拟合一条回归线,会压掉可能正是研究重点的组间变异;完全不合并(no pooling)为每组单独估计或加入组虚拟变量,数据少的组估计很不稳定,而且在经典回归里组虚拟变量与组层面自变量(如学校类型)共线,二者无法同时放进模型。多层模型取二者之间的部分合并(partial pooling):各组有自己的参数,但这些参数受一个组层面分布的约束,信息少的组会更多地向总体均值收缩。
组内相似的程度用组内相关系数(intraclass correlation,ICC,记作 ρ)衡量。先拟合不含自变量的“空模型” yᵢⱼ = γ₀₀ + u₀ⱼ + eᵢⱼ,其中 u₀ⱼ 是第 j 组偏离总均值的部分,方差为 τ₀₀;eᵢⱼ 是组内个体的残差,方差为 σ²。于是 ρ = τ₀₀ /(τ₀₀ + σ²),即总方差中落在组间的比例,也等于同组任意两个观测之间的相关。ρ = 0 表示分组不带来额外的相似性;ρ 越大,同组的多条观测提供的独立信息越少。
ICC 对推断的影响通过设计效应(design effect)体现。Maas 与 Hox(2005)引用 Kish(1965)的结果:在整群抽样中,设计效应约为 1 +(平均组规模 − 1)× ICC,表示与同样本量的简单随机抽样相比,抽样方差被放大的倍数。按这个近似公式做一个假设性的计算:100 个班、每班 30 人,共 3000 名学生,若 ICC = 0.2,设计效应为 1 + 29 × 0.2 = 6.8,有效样本量约为 3000 / 6.8 ≈ 441;忽略嵌套时,算出的标准误只有应有值的 1/√6.8,约 0.38 倍。即使 ICC 只有 0.05,设计效应也有 2.45。组规模越大,很小的 ICC 也足以让普通回归的显著性检验过于乐观。
随机截距与随机斜率
Raudenbush 与 Bryk 的写法把模型拆成两层。以“学生 i 在学校 j”为例,第一层是每所学校内部的回归,第二层把各校的截距和斜率本身当作结果变量,用学校层面的变量 zⱼ 去解释:
Level 1:  y_ij = b0_j + b1_j * x_ij + e_ij,          e_ij ~ N(0, sigma^2)
Level 2:  b0_j = g00 + g01 * z_j + u0_j
          b1_j = g10 + g11 * z_j + u1_j,          (u0_j, u1_j) ~ N(0, T)
Combined: y_ij = g00 + g10 * x_ij + g01 * z_j + g11 * x_ij * z_j
               + u0_j + u1_j * x_ij + e_ij
合并式中的 g(即 γ)系数组成固定部分,描述总体的平均关系;u0、u1 和 e 组成随机部分,“混合效应模型”的名称即由此而来。只保留 u0 的是随机截距模型:各组回归线互相平行,只是高低不同。再加入 u1 就是随机斜率模型:x 对 y 的作用也因组而异,协方差矩阵 T 中包含斜率的组间方差,以及截距与斜率的协方差。组层面变量 z(例如学校类型)可以解释截距的差异,乘积项 x·z 是跨层交互,用来检验组的特征是否改变组内关系。Raudenbush 与 Bryk 还专门讨论了第一层自变量的中心化:按总均值还是按组均值中心化,会改变截距和部分系数的含义。Gelman 与 Hill 在书中有意少用“随机效应”一词,改称变动截距(varying intercepts)和变动斜率(varying slopes),强调这些系数是由一个组层面模型来描述的量。
REML 估计与 lme4 算例
多层模型的方差分量通常用最大似然(ML)或限制性最大似然(REML)估计。ML 估计方差时没有扣除估计固定效应所用掉的自由度:在最简单的线性回归里,无偏的残差方差是残差平方和除以 n − t(t 为回归系数个数),ML 却除以 n,因此偏小。Patterson 与 Thompson(1971)的做法是不对全部数据求似然,只对一组不含固定效应信息的误差对比求似然,这就是后来所说的 REML。R 的 lme4::lmer 与 Python statsmodels 的 MixedLM.fit 默认都用 REML。需要注意,REML 似然不能用来比较固定效应不同的模型,这时应改用 ML;lme4 的 anova() 在比较 REML 拟合的模型时会自动用 ML 重新拟合。
下面用 lme4 自带的 sleepstudy 数据演示。数据来自 Belenky 等(2003)的睡眠剥夺研究,Bates 等(2015)介绍 lme4 的论文全程以它为例:18 名受试者第 0 天正常睡眠,此后每晚只睡 3 小时,因变量是每天一组测试的平均反应时(毫秒),天数为 0–9,共 180 条观测。“天”嵌套在受试者内,属于重复测量型的两层数据。以下代码依次拟合随机截距、独立随机斜率和相关随机斜率三个模型,计算 ICC,做似然比检验,并画出各受试者的回归线对比图。
# install.packages(c("lme4", "ggplot2"))
library(lme4)
library(ggplot2)

data("sleepstudy", package = "lme4")

# Random intercept, independent random slope, correlated random slope (REML by default)
fm3 <- lmer(Reaction ~ Days + (1 | Subject), data = sleepstudy)
fm2 <- lmer(Reaction ~ Days + (Days || Subject), data = sleepstudy)
fm1 <- lmer(Reaction ~ Days + (Days | Subject), data = sleepstudy)
summary(fm1)

# ICC from the random-intercept model
vc <- as.data.frame(VarCorr(fm3))
vc$vcov[vc$grp == "Subject"] / sum(vc$vcov)

# Likelihood-ratio tests; anova() refits the models with ML
anova(fm3, fm2, fm1)

# Per-subject lines: complete pooling, no pooling, partial pooling
pooled  <- coef(lm(Reaction ~ Days, data = sleepstudy))
no_pool <- coef(lmList(Reaction ~ Days | Subject, data = sleepstudy))
partial <- coef(fm1)$Subject
subject_levels <- levels(sleepstudy$Subject)
lines <- rbind(
  data.frame(Subject = factor(rownames(no_pool), levels = subject_levels),
             a = no_pool[, 1], b = no_pool[, 2],
             fit = "No pooling (per-subject OLS)"),
  data.frame(Subject = factor(rownames(partial), levels = subject_levels),
             a = partial[, 1], b = partial[, 2],
             fit = "Partial pooling (lmer)")
)

ggplot(sleepstudy, aes(Days, Reaction)) +
  geom_point(colour = "grey50", size = 1) +
  geom_abline(intercept = pooled[1], slope = pooled[2],
              colour = "grey20", linewidth = 0.3) +
  geom_abline(data = lines,
              aes(intercept = a, slope = b, colour = fit, linetype = fit)) +
  facet_wrap(~ Subject, ncol = 6) +
  scale_x_continuous(breaks = c(0, 3, 6, 9)) +
  labs(x = "Days of sleep deprivation", y = "Mean reaction time (ms)",
       colour = NULL, linetype = NULL) +
  theme_bw() +
  theme(legend.position = "bottom")
ggsave("sleepstudy_lines.png", width = 9, height = 6, dpi = 200)
Bates 等(2015)报告的相关随机斜率模型(fm1,REML)结果如下:固定截距 251.41 毫秒(标准误 6.82),每多剥夺一天睡眠,平均反应时增加 10.47 毫秒(标准误 1.55);受试者间截距标准差 24.74 毫秒,斜率标准差 5.92 毫秒/天,二者相关约 0.07;残差标准差 25.59 毫秒。换句话说,除了“平均每天慢约 10 毫秒”,不同人的基线相差约 25 毫秒,每天变慢的速度也相差约 6 毫秒。用 ML 重新拟合后做似然比检验:在随机截距模型上加入独立的随机斜率,偏差(deviance)下降 42.08(p ≈ 8.8 × 10⁻¹¹);再加入截距与斜率的相关,偏差只下降 0.06(p ≈ 0.8)。lme4 的 summary() 不给固定效应的 p 值,论文第 5.2.5 节讨论了原因。不同版本的优化器可能让末位小数略有出入。
加入随机斜率后,ICC 不再是一个固定数字,而随自变量变化:受试者间方差等于截距方差 + 2 × 天数 × 截距斜率协方差 + 天数² × 斜率方差。按论文报告的方差分量(截距方差 612.1,斜率方差 35.1,协方差 9.6,残差方差 654.9)手算:第 0 天,ICC ≈ 612.1 /(612.1 + 654.9)≈ 0.48;第 9 天,受试者间方差为 612.1 + 2 × 9 × 9.6 + 81 × 35.1 ≈ 3628,ICC ≈ 3628 /(3628 + 654.9)≈ 0.85。剥夺越久,个体差异在总变异中占得越多,这正是随机斜率所刻画的现象。
两类常见误用
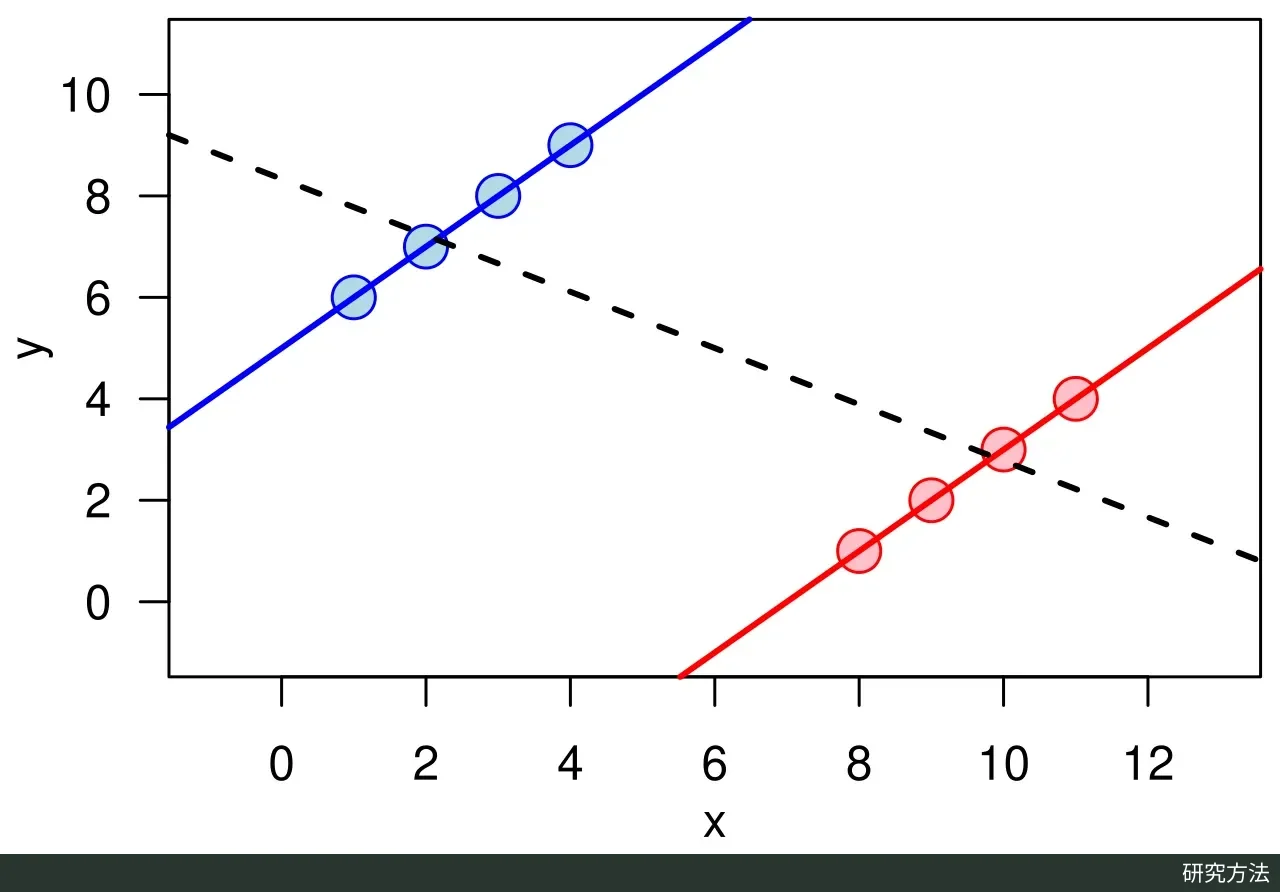
第一类误用是组数太少。关于组间方差的信息几乎全部来自“组”这一层,组数就是这一层的样本量。Maas 与 Hox(2005)用 REML 做模拟(组数 30、50、100,组规模 5、30、50,ICC 0.1–0.3):回归系数及其标准误在所有条件下都较准确,但组数明显少于 100 时,第二层方差分量的标准误偏小——30 组时约低估 15%,95% 置信区间的未覆盖率约 8.9%(名义值为 5%);50 组时约低估 9%,未覆盖率约 7.3%。McNeish 与 Stapleton(2016)的综述指出,组数低于 30 时传统 ML 估计会出现偏差;REML、Kenward–Roger 校正或贝叶斯 MCMC 在部分情形下组数降到 10 个甚至更少仍表现尚可,但他们也提醒不要过于乐观。Kenward–Roger 校正先放大固定效应的协方差矩阵,再用 Satterthwaite 型近似计算检验的自由度;R 的 pbkrtest 包可对部分模型实现这一校正。前面的 sleepstudy 只有 18 名受试者,解读其方差分量时同样应留有余地。
第二类误用是随机效应结构过度简化,最常见的情形是自变量明明在组内变化(如受试者内操纵的实验条件),却只给随机截距。Barr 等(2013)用理论分析和蒙特卡洛模拟表明,当总体中受试者或项目对实验操纵的敏感度确实不同时,只含随机截距的模型会使第一类错误率膨胀,在受试者内或项目内设计中可能高得惊人;他们主张验证性检验采用“设计所支持的最大随机效应结构”。Matuschek 等(2017)则指出,最大模型若复杂到数据不足以支持,会明显损失检验效能,建议用模型选择准则保留数据支持的随机效应。两篇文章的共同底线是:不能不加检查就默认只用随机截距。实际分析中可以从设计所支持的结构出发,在模型不收敛或数据不支持某些方差成分时再有依据地简化,并报告简化过程。sleepstudy 的似然比检验就提供了这样的依据:随机斜率显著改善了拟合,而截距与斜率的相关几乎没有贡献。