
分数达标才获得补助、跨过政策边界才享有资格,这类阈值规则给断点回归提供了因果识别的机会。但图上出现跳跃,并不等于政策效果已经坐实。高阶曲线、挑选带宽和过度外推,都可能让结论偏离设计原本能回答的问题;淮河供暖研究的争议,恰好展示了这些风险。
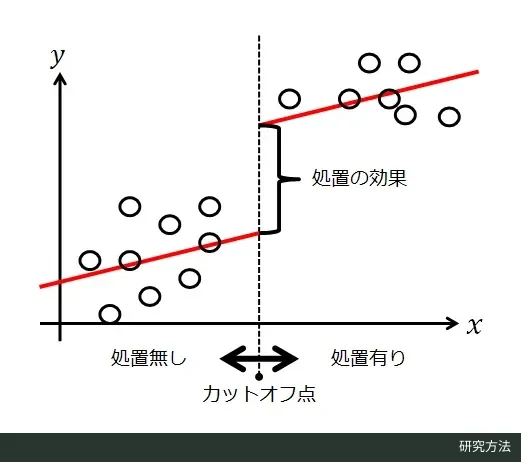
阈值规则与处理分配
断点回归利用的是处理分配在已知阈值处的改变。例如,按分数线发放补助时,直接比较所有领取者与未领取者,会混入原有的分数差异;断点设计把比较集中在分数线附近。分数或距离等用于排序的指标,叫作“跑变量”。关键是分配规则本身,不能看见结果曲线有个转折,就事后把它当成政策断点。
精确断点(sharp RD)中,处理状态由阈值规则完全决定;模糊断点(fuzzy RD)中,跨线只让接受处理的概率发生跳变。后者常用“结果的跳跃÷处理概率的跳跃”估计效应,但需要非零的第一阶段、排除限制及单调性等条件:跨线只能通过接受处理影响结果,且不能同时让一部分人更愿意接受、另一部分人反而拒绝处理。由此得到的是阈值附近服从规则者的局部平均效应。Lee 与 Lemieux(2010)
本文采用连续性框架:通过阈值两侧的极限比较识别效应;把某个有限窗口直接按随机试验分析,则还需要局部随机化框架的相应假设,不能仅凭“离阈值近”就自动成立。方法综述
题图说明:断点回归概念示意(日文标注),并非淮河研究数据。作者 Munasca,来源 Wikimedia Commons,许可 CC BY-SA 4.0;保留原图内容,工作台转换为 WebP。

识别条件与诊断边界
识别的核心并非“观测到的结果必须连续”,而是在没有处理分配变化时,潜在结果的条件期望应当在阈值处连续;否则,观察到的跳跃可能另有原因。个体不能精确操纵跑变量、把自己安置到想要的一侧,是支持这一条件的重要制度依据。还要排查同一阈值处是否有其他政策或样本构成变化,不能靠加入几个控制变量代替制度核查。Lee 与 Lemieux(2010)
可做的检验各有分工。McCrary 密度检验寻找跑变量在阈值处异常堆积或稀缺的线索;rddensity 则实现较新的局部多项式密度检验,并非简单换名的 McCrary 命令。检验未拒绝密度连续,不能证明没有操纵,更不能直接证明潜在结果连续;双向排序可能掩盖密度变化,统计功效也有限。McCrary 作者稿、Cattaneo 等(2018)、rddensity 官方说明
协变量检查应选处理前已确定的特征,看它们在断点处是否跳变;安慰剂断点则检查其他没有真实政策切换的位置是否也出现跳跃。这些都是寻找反证,不能把一串“不显著”当成设计合格证。安慰剂位置本身不能碰上别的政策阈值。跑变量若只有少数离散取值或明显取整堆积,还需评估密度方法与连续跑变量近似是否适用,不能照搬默认检验。Imbens 与 Lemieux(2008)、密度检验方法说明
拟合、带宽与外推的误区
第一处误用,是用全局高阶多项式换取“足够灵活”。Gelman 与 Imbens 的论文指出,这类估计可能噪声大、对阶数敏感,置信区间覆盖率也不可靠:远离阈值的观测仍可能对断点估计施加很大的权重,而整体拟合漂亮,不代表边界处的因果估计可信。他们建议采用局部线性、局部二次等方法。这里的批评针对全局高阶拟合,并非禁止偏差校正中使用局部二次回归。该文在线发表于 2018 年,正式卷期为 2019 年 JBES 37(3)。Gelman 与 Imbens
第二处误用,是反复改带宽,直到区间不再包含零。带宽决定阈值附近用多宽的范围:过宽可能引入曲率偏差,过窄则让估计不稳定。较可信的做法是说明主分析的带宽选择准则,报告合理范围内的敏感性,并同时展示点估计和区间。变化本身就是读者需要看到的信息,不能只留下最显著的一档。Lee 与 Lemieux(2010)
数据驱动带宽还必须搭配适合的推断。Calonico、Cattaneo 与 Titiunik(2014)说明,均方误差导向的带宽可能使常规区间受到不可忽略的偏差影响;稳健偏差校正既调整估计中心,也把估计偏差带来的不确定性纳入标准误。使用 rdrobust 时,应明确报告稳健偏差校正区间及相应设定,不能拿校正后的点估计配上原来的常规标准误,也不能把“稳健”理解为能够修复无效的识别设计。方法论文、rdrobust 官方说明
第三处误用,是把阈值处的效果推广为所有人的平均效果。在分数线附近识别出的补助效果,不能自动回答远低于分数线的人获助会怎样;模糊断点还受到服从规则者这一人群限制。外推需要额外证据与假设,区间再窄也不能消除这层限制。Lee 与 Lemieux(2010)
淮河供暖研究的设定争议
Chen、Ebenstein、Greenstone 与 Li 于 2013 年在 PNAS 发表研究,利用秦岭—淮河一线以北供暖政策造成的差异,考察长期空气污染与预期寿命。论文分析的污染指标是总悬浮颗粒物(TSP),报告北侧阈值处预期寿命低约 5.5 年,95% 置信区间为 0.8–10.2 年。这是特定设计与设定下的估计,不是对每一位北方居民寿命的预测。2013 年原文
争议集中在这个跳跃有多依赖拟合方式。Gelman 与 Zelizer 在 2015 年的批评论文中指出,原研究补充材料里的三次调整给出约 5.5 年的差异,线性调整则约为 1.6 年,后者标准误为 1.7 年。他们并未因此认定线性模型正确,也没有据此否定污染的危害;批评的是,醒目的数值及其显著性对模型选择过于敏感。不能把这组比较解释为“换成线性,就证明没有效应”。2015 年批评原文
Ebenstein、Fan、Greenstone、He 与 Zhou 的再研究于 2017 年 9 月 11 日在线发表于 PNAS,采用 2004–2012 年死亡数据,污染指标改为 PM₁₀,并报告局部线性、不同核函数和带宽等分析。摘要给出的估计是:长期 PM₁₀ 浓度每增加 10 微克/立方米,预期寿命减少约 0.64 年,95% 置信区间为 0.21–1.07 年。它和前文的 5.5 年分别是不同指标、时期与估计对象,不能直接相减,称作研究“修正了多少年”。2017 年原文
再研究增加了证据,但不会让地理边界自动成为随机分组。原文也明确依赖其他健康决定因素在边界处平滑变化;把政策差异进一步解释为污染效应,还要求政策只通过所研究的污染影响死亡。迁移等补偿行为也影响估计的实际含义。读这类研究,应把政策机制、数据图形、设定敏感性和适用人群放在一起判断,而不是只记住一个寿命数字。
1. 参考文献
- 2010,Regression Discontinuity Designs in Economics。Lee & Lemieux;JEL 48(2), 281–355。
- 2008,Regression discontinuity designs: A guide to practice。Imbens & Lemieux;Journal of Econometrics 142(2), 615–635。
- 2008,Manipulation of the Running Variable in the Regression Discontinuity Design: A Density Test。McCrary;Journal of Econometrics 142(2), 698–714;链接为2006年12月作者稿。
- 2018,Manipulation Testing Based on Density Discontinuity。Cattaneo, Jansson & Ma;Stata Journal 18(1), 234–261。
- 2014,Robust Nonparametric Confidence Intervals for Regression-Discontinuity Designs。Calonico, Cattaneo & Titiunik;Econometrica 82(6), 2295–2326。
- 2019,Why High-Order Polynomials Should Not Be Used in Regression Discontinuity Designs。Gelman & Imbens;JBES 37(3), 447–456;2018-05-14在线发表,2019年编入卷期。
- 2013,Evidence on the impact of sustained exposure to air pollution on life expectancy from China’s Huai River policy。Chen, Ebenstein, Greenstone & Li;PNAS 110(32), 12936–12941。
- 2015,Evidence on the deleterious impact of sustained use of polynomial regression on causal inference。Gelman & Zelizer;Research & Politics 2(1)。
- 2017,New evidence on the impact of sustained exposure to air pollution on life expectancy from China’s Huai River Policy。Ebenstein, Fan, Greenstone, He & Zhou;PNAS 114(39), 10384–10389。
- rdrobust: Robust Local Polynomial Methods for RD Designs。官方README与方法参考文献;读取于2026-10-19。
- rddensity: Manipulation Testing Using Local Polynomial Density Methods。官方README与方法参考文献;读取于2026-10-19。
- 2022,Cattaneo & Titiunik,Regression Discontinuity Designs。Annual Review of Economics 14, 821–851;连续性与局部随机化框架综述。