
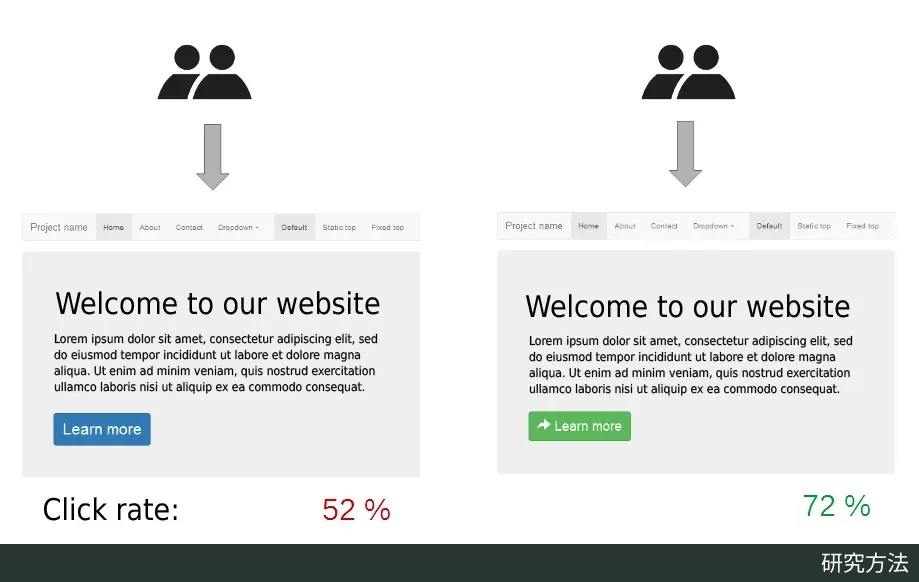
网站 A/B 测试的一般示意:同一页面的两个版本(按钮样式不同)分别展示给两组用户,再比较点击率。图中 52% 与 72% 为示意数字,与必应广告标题实验无关,画面也不是必应的广告版式。图:Maxime Lorant,来源 Wikimedia Commons(File:A-B testing example.png),许可 CC BY-SA 4.0。
2012 年,必应(Bing)一名员工提议把广告标题行加长。这个改动只需几天开发,却在待办清单里搁置了六个多月,直到一位工程师用在线对照实验(A/B 测试)试了一下:新版让必应收入提高 12%,按当时规模折算,仅美国一年就超过 1 亿美元。本文借这个案例拆解随机分流、对照、样本量、测量指标与偏差控制,并讨论这个结论能推广多远。
被搁置半年的标题改动
据 Kohavi 与 Thomke 发表在《哈佛商业评论》2017 年 9–10 月号的文章,2012 年一名在必应工作的微软员工提议改变广告标题的显示方式。Kohavi、Tang 与 Xu 在 2020 年出版的《Trustworthy Online Controlled Experiments》第一章里给出了具体做法:把广告的标题行与其下方第一行文字合并,让标题变长。实现它只需一名工程师几天时间,但它只是数百个提案之一,被判为低优先级,搁置了六个多月。
后来,一位开发者觉得代码成本很低,便实现了这个改动,并直接在真实用户身上检验:随机让一部分用户看到新标题版式,其余用户看到原版,同时记录广告点击和由此产生的收入。实验开始几小时后,系统触发了“收入过高”告警。书中解释,这类“好得不像真的”告警通常意味着严重 bug,比如收入被重复记录,或页面只显示广告、其余部分坏掉。但这一次增长是真实的:必应收入提高 12%,按当时规模折算,仅美国一年就超过 1 亿美元,而关键用户体验指标没有显著变差。书中还写明,这个实验之后在较长时期内重复做了多次。
两份资料都称它是必应历史上带来收入最多的单个想法,这个故事也因此常被当作“A/B 测试能挖到金矿”的例子。但从研究方法的角度看,更值得追问的是:一个 12% 的结果,是怎样经过设计和检查,才变得可以相信的。
随机分流、对照组与评估指标
这次实验的骨架是随机分配。书中把它当作最简单的对照实验来介绍:对照组(A)是原有广告版式,实验组(B)是加长标题的版式,两组同时运行。在线实验通常用哈希等伪随机过程,把“随机化单元”映射到各组。作者建议以用户为单元,并要求分配既持久又相互独立:同一用户多次访问始终看到同一版本,一名用户被分到哪组,也不透露其他用户的分组。这样,两组在时段、设备、搜索意图等因素上只剩随机差异,收入差距才能归因于标题改动。需要说明的是,原始资料没有交代这次实验的分流比例、样本量和运行时长,本文不作推测。
随机化的价值,放在对比中更清楚。书中举过 Office 365 的例子:看到报错、遇到崩溃的用户反而流失更少,原因并非报错有益,而是重度使用同时带来了更多报错和更低的流失。同理,如果必应只是全量上线新标题,再比较上线前后的收入,季节(书中提到每年 12 月前后广告收入会有季节性高峰)、广告主预算和搜索热点的变化都会混进来;同期随机对照则把这些因素平均分到了两组。
测量上,收入只是综合评估指标(OEC)的一部分。书中强调,只盯收入可能导致把页面塞满广告,而这会损害用户体验;必应的 OEC 会把收入与每用户会话数等用户体验指标放在一起权衡。Kohavi 等人 2012 年的 KDD 论文给过一个反面例子:必应一次实验中的 bug 让搜索结果明显变差,每用户独立查询数却上升 10% 以上,每用户收入上升 30% 以上——用户找不到答案,只好多搜、多点广告。标题实验之所以被认可,正是因为收入上升的同时,用户体验指标没有显著下滑。
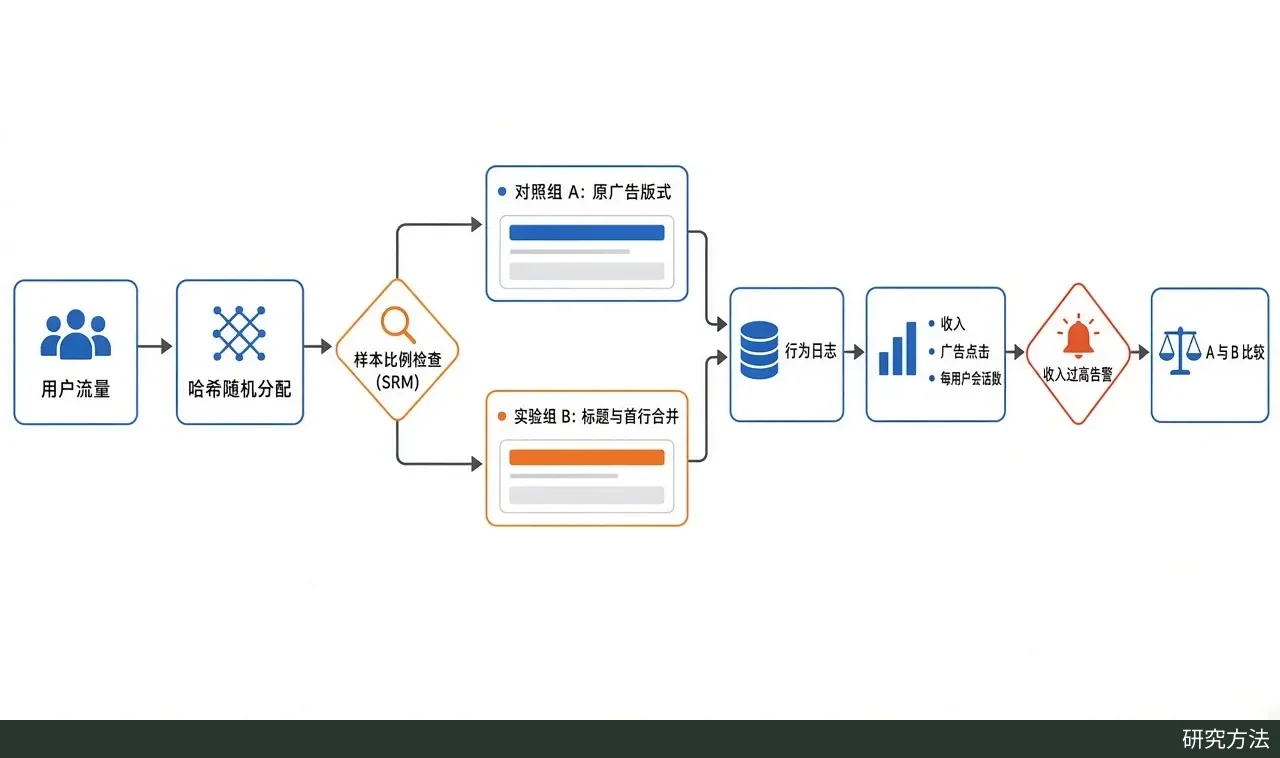
在线对照实验的一般流程与两个信任检查点:分组后核对各组实际人数比例是否符合预设(样本比例检查,SRM),汇总指标时对异常偏高的收入发出告警。据 Kohavi、Tang 与 Xu(2020)及 Fabijan 等(2019)的描述绘制,并非必应实际系统图;原始资料未公布标题实验的分流比例与样本量。AI 生成示意图。
样本量与偏差控制
为什么几小时就能看出异常?Kohavi 等人 2009 年的综述给出过一个常用的经验公式:每组所需用户数 n ≈ 16σ²/Δ²(95% 置信水平、80% 统计功效),其中 σ² 是指标的方差,Δ 是希望检出的最小变化。Δ 以平方进入分母,所以效应越大,需要的数据越少。同一篇综述举例:一个按检出 1% 变化来规划的实验,如果 bug 让指标下跌 20%,只需计划时长的 1/400 就能发现,原本跑两周的实验,第一个小时就会露馅。必应标题实验很快触发告警,可以用同样的逻辑理解:书中说大型网站关键指标的日常改进多在 0.1% 到 2% 之间,12% 远超这一量级。反过来说,几小时的数据只够发现异常,不够下结论,这正是后续还要长期重复验证的原因。
面对异常好的结果,Kohavi 团队的默认立场是怀疑。书中引用 Twyman 定律:任何看起来有趣或与众不同的数字,通常是错的。必应的做法有两层:平台对过高的收入自动告警,迫使人先排查重复计费、页面损坏之类的技术故障;排除故障后,再用较长时期内的多次重复实验确认效应。书中介绍的必应相关性团队也有类似规矩:一个想法经多轮迭代成功后,还要再跑一次只含单一实验组的“认证实验”,以它的效应计入年度目标,因为在成千上万个实验组里,总有一些会碰巧显得正向。
更隐蔽的偏差来自实验管道本身。Fabijan 等人 2019 年的 KDD 论文专门讨论样本比例失衡(SRM):实际进入各组的用户比例与预设比例显著不同。论文举例,一个预期 50/50 分流的实验出现了 821,588 对 815,482 名用户(50.2/49.8),用卡方检验算出偶然出现这种偏差的概率低于五十万分之一;他们分析最近一年的实验发现,微软约 6% 的实验存在 SRM。SRM 往往说明某一组的用户被系统性地丢失或多记,论文认为它在多数情况下会让实验结果完全失效。原始资料没有说明标题实验是否做过这项检查,这里只把它作为同一团队总结的通用检查项。
时间维度上也有陷阱。2012 年的 KDD 论文指出,实验头几天的效应估计波动很大,看起来像“用户逐渐适应”的趋势,常常只是统计噪声——论文展示的一张“趋势图”,其实来自两组完全相同的 A/A 测试。作者没有找到哪个实验因首因效应或新奇效应,从显著为负翻转为显著为正,并建议实验至少运行一周,以覆盖星期几带来的差异。他们还发现遗留效应可以持续很久:复用的用户桶在一次实验结束后约三周才恢复,一次严重 bug 之后,三个月仍未完全恢复,因此需要先用 A/A 测试确认分桶“干净”。
结论的适用范围
这个实验能支持的结论相当具体:在 2012 年前后必应的广告系统和用户群中,把广告标题与首行文字合并,在当时的评估指标下提高了收入,且没有显著损害用户体验。“年化超 1 亿美元”是按当时美国业务规模折算的数字,不是一整年实测的账面收入。它不能直接推出“长标题广告普遍更赚钱”,也不能原样搬到其他搜索引擎、其他市场或今天的必应,因为页面布局、广告系统和用户习惯都可能不同。
Kohavi 等人 2009 年的综述列出了对照实验的几条固有局限,正好适用于此:实验能说明哪个版本更好、好多少,却说明不了为什么;它测量的是实验期间(通常几周)的效应,长期影响只能靠把长期目标纳入 OEC 来部分弥补;新版式还可能带来新奇效应。至于广告主一侧会不会因此长期调整投放,现有原始资料没有讨论,只能保留为未知。
还要留意故事本身的选择性。书中说,必应每年运行超过 10,000 个实验,像这样的简单改动带来巨大提升,几年才出现一次;在微软接受测试的想法里,只有约三分之一改善了它们本想改善的指标。因此,这个案例可以推广的不是 12% 这个数字,而是一套流程:用低成本的随机对照检验想法,事先确定兼顾收入与体验的评估指标,对“好得不像真的”结果先查错、再重复。