
空白的五点李克特量表问卷模板:多道题各自计分后相加得到总分,α 评价的正是这类总分。作者:User:Amousey;来源:Wikimedia Commons;许可:CC0 1.0。
克龙巴赫 α 系数由 Lee J. Cronbach 于 1951 年在《Psychometrika》上系统提出,至今仍是量表信度最常报告的指标。它只在各题载荷相等、误差互不相关时等于总分信度,条件不满足时通常只是下限;它会随题目数上升,也不能证明量表只测一个维度。本条目对照 McDonald's ω,梳理 α 的含义、适用范围与常见误用。
公式与 Cronbach 1951 原文
Cronbach 的论文题为“Coefficient Alpha and the Internal Structure of Tests”,刊于《Psychometrika》1951 年 9 月第 16 卷第 3 期,第 297–334 页。按原文摘要,α 是 Kuder–Richardson 系数(KR-20,用于对错计分的题目)的一般化形式;它等于把测验按所有可能方式对半分割后所得分半信度的平均值,因此可以理解为:从同类题目的总体中随机抽两组题,两组得分之间相关的估计。
其中 为题目数, 为第 题的方差, 为总分方差。总分方差里“各题自身方差”占比越小,也就是题目之间的协方差越大,α 越高。若先把各题标准化,得到标准化 α:
为平均题间相关。它与 Spearman–Brown 预测公式形式相同,这一点是理解“题目越多 α 越高”的关键。
原文本身已经设下边界。Cronbach 在摘要中写明:α 可以作为“第一因子集中度”的指标,但很短的测验除外;能分成明显不同分测验的测验,应先拆分再分别套用公式。半个世纪后,他在 2004 年与 Richard J. Shavelson 联名发表的笔记中表示,已怀疑 α 是否是判断工具信度的最佳方式,认为它只覆盖信度信息需求中的一小部分,应放进概化理论(generalizability theory)这一更大的信度分析体系中看待。
α 与 McDonald's ω
经典测量理论把信度定义为真分数方差在观测分数方差中所占的比例。只凭一次施测估计它,就必须对“题目如何反映潜在特质”作出假设。α 隐含的是 τ 等价模型:每道题对同一个潜在因子的载荷相同,且测量误差互不相关(McNeish, 2018)。现实量表更常见的是同属模型(congeneric):各题测的是同一个因子,但载荷高低不一。此时 α 是总分信度的下限,会低估;Sijtsma(2009)进一步指出,在通常的测量误差假设下,α 并不等于总分信度本身。
McDonald(1999)的 ω 直接用单因子模型的载荷 与误差方差 计算:
载荷全部相等时,ω 与 α 重合;载荷越参差,α 低估得越多。以 6 道标准化题目为例:载荷都为 0.6 时,α 与 ω 都是 0.771;改为两题 0.9、四题 0.3 时,α 降为 0.647,ω 为 0.691(计算见下一节代码)。
量表若包含一个总因子和若干群因子,还要区分 ω_total 与 ω_hierarchical:前者是全部公共因子解释的总分方差比例,后者只计总因子的部分,才真正回答“总分在多大程度上反映同一个构念”。Revelle 与 Zinbarg(2009)在评论 Sijtsma 时主张用 ω_t 而非 glb(最大下界)报告信度,并指出 glb 实际上系统性地小于 ω_t。ω 也不是免检指标:它建立在因子模型之上,模型设定或拟合有问题时,ω 同样会误导。Dunn、Baguley 与 Brunsden(2014)给出了在开源软件 R 中计算 ω 点估计和区间估计的步骤;McNeish(2018)在梳理 α 的前提假设后,也建议改用 ω 等基于模型的信度系数。
题目数与维度对 α 的影响
由标准化 α 的公式可见,平均题间相关不变时,α 随题目数单调上升。设平均题间相关为 0.30:5 题时 α 约 0.68,10 题约 0.81,20 题约 0.90,40 题约 0.94。即使平均题间相关只有 0.10,40 题量表的 α 也能达到约 0.82。Cortina(1993)据此强调,α 同时取决于题目数和题间相关,长量表的高 α 不能直接说明题目之间高度相关。
维度问题同理。Green、Lissitz 与 Mulaik(1977)指出,文献常把“内部一致性”与“同质性”混为一谈,而 α 是由多种因素共同决定的统计量,题目同质性只是其中之一。一个极端的例子:20 道题分成两组,每组 10 题,组内题间相关 0.5,两组之间相关为 0,也就是两个毫不相关的维度。总分方差为 20 + 2 × (10 × 9 × 0.5) = 110,于是 α = (20/19) × (1 − 20/110) ≈ 0.86。这个数字看上去“良好”,总分却把两种互不相关的东西加在了一起。
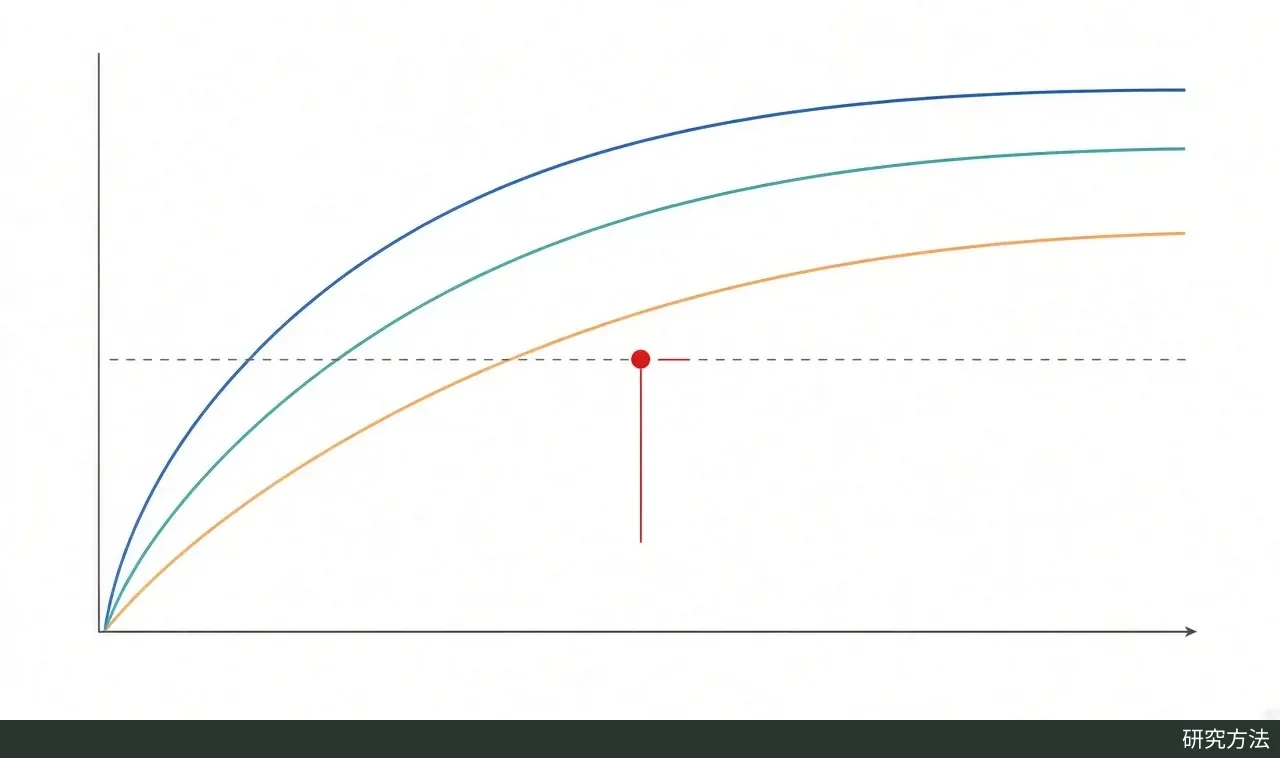
AI 生成示意图:三条曲线自上而下示意平均题间相关由高到低时,α 随题目数增加而上升并逐渐趋平,虚线示意常被引用的 0.70。图中曲线与红色标记均未按实际数值绘制,具体数值以正文和下方代码为准。
下面的 Python 代码只依赖 NumPy,直接在总体协方差矩阵上计算 α 与 ω,不涉及随机抽样,运行即可逐一复算本条目中的数值:
import numpy as np


def alpha_from_cov(S):
    """Cronbach's alpha from an item covariance matrix."""
    k = S.shape[0]
    return k / (k - 1) * (1 - np.trace(S) / S.sum())


def omega_from_loadings(lam):
    """McDonald's omega for a one-factor model with standardized items."""
    lam = np.asarray(lam, dtype=float)
    psi = 1 - lam**2
    return lam.sum() ** 2 / (lam.sum() ** 2 + psi.sum())


def implied_cov(lam):
    """Model-implied correlation matrix of a one-factor model."""
    lam = np.asarray(lam, dtype=float)
    S = np.outer(lam, lam)
    np.fill_diagonal(S, 1.0)
    return S


# 1) Alpha rises with the number of items at a fixed mean inter-item correlation
for r in (0.1, 0.3):
    for k in (5, 10, 20, 40):
        S = np.full((k, k), r)
        np.fill_diagonal(S, 1.0)
        print(f"r={r}, k={k}: alpha={alpha_from_cov(S):.3f}")

# 2) Two uncorrelated 10-item dimensions still give a "good" alpha
block = np.full((10, 10), 0.5)
np.fill_diagonal(block, 1.0)
zeros = np.zeros((10, 10))
S2 = np.block([[block, zeros], [zeros, block]])
print(f"two orthogonal dimensions: alpha={alpha_from_cov(S2):.3f}")

# 3) Tau-equivalent vs congeneric loadings
for lam in ([0.6] * 6, [0.9, 0.9, 0.3, 0.3, 0.3, 0.3]):
    S3 = implied_cov(lam)
    print(lam, f"alpha={alpha_from_cov(S3):.3f}", f"omega={omega_from_loadings(lam):.3f}")
按公式推得的输出为:平均题间相关 0.1 时,5/10/20/40 题的 α 依次为 0.357、0.526、0.690、0.816;相关 0.3 时依次为 0.682、0.811、0.896、0.945;两个互不相关维度的 α 为 0.861;载荷全为 0.6 时 α = ω = 0.771,载荷不等时 α = 0.647、ω = 0.691。
常见误用与报告建议
- 把 α 当作单维性证据。 上一节的两维度例子说明,α 高不代表量表只测一个维度(Green 等, 1977;Schmitt, 1996)。结构应先用因子分析检验,再谈信度。
- 多维量表只报一个总 α。 Cronbach(1951)原文就建议,能分成不同分测验的测验应先拆分再计算。应按分量表分别报告;若确实要使用总分,再补充 ω_hierarchical。
- 机械套用 0.70 门槛。 Schmitt(1996)认为不存在一个让 α “足够”的普适数值。可接受的水平取决于分数用途:比较群体均值,与据此对个人做诊断或筛选,要求截然不同。Sijtsma(2009)也提醒,单次施测得到的统计量,对个人测量精度提供的信息很有限。
- 为追求高 α 加题或保留近义题。 由公式可知,增加题目、保留措辞高度相似的题都会推高 α,但这不等于测量对研究问题更有用,还可能让构念覆盖面变窄。
- 把 α 当作量表的固定属性。 α 由本次样本的题目方差和总分方差算出,样本分数变异受限时它也会随之下降。应报告本研究样本的估计值及置信区间,而不是只引用量表手册里的数字;区间估计方法可参考 Dunn 等(2014)。
- 把 α 当作唯一的信度。 α 只反映“抽到哪些题”带来的误差,不涵盖跨时间(重测)或跨评分者的误差。Cronbach 与 Shavelson(2004)主张在概化理论框架下分别考察这些误差来源。
落到报告上,一个较稳妥的顺序是:先检验因子结构;若为单因子且各题载荷接近,α 与 ω 差别很小,报告 α 并无大碍;若载荷差异明显,改报 ω_total;存在总因子加群因子的结构时,再补充 ω_hierarchical。同时写明题目数、平均题间相关、置信区间,以及这些分数打算用于群体比较还是个人决策。