
交叉验证示意:数据均分为若干份,每轮留出一份(橙色)作验证集,留出的位置逐轮轮换。AI 生成示意图。
模型在训练数据上表现再好,也不等于能预测新数据。交叉验证把样本轮流分成训练部分和验证部分,用模型“没见过”的数据估计泛化误差,k 折和留一法是最常用的两种做法。它成立的前提是验证数据的信息不能以任何途径进入建模过程;一旦发生数据泄漏,估计就会系统性地偏乐观。
为什么需要交叉验证
用同一批数据拟合模型再给它打分,好比让学生拿做过的原题考试。scikit-learn 用户指南举的极端例子是:一个只会复述已见样本标签的模型能拿满分,却预测不了任何新数据,这就是过拟合。直接的补救是留出一部分数据作测试集,但样本少时,这会进一步压缩训练数据,而且结果取决于哪些样本恰好被分进测试集。交叉验证要做的,是在不浪费太多数据的前提下,得到更稳定的泛化误差估计。
这一思路由来已久。Stone 于 1973 年 12 月在英国皇家统计学会宣读、1974 年发表于该会会刊 B 辑的论文,把交叉验证准则同时用于预测方法的“选择”和“评估”,例子涵盖单变量估计、线性回归和方差分析。《统计学习基础》(The Elements of Statistical Learning,下称 ESL)第 7 章同样区分“模型选择”与“模型评估”:前者用交叉验证挑模型、定参数,后者用它报告最终模型在新数据上的误差。把两件事放进同一轮交叉验证,正是后文要讲的一类偏差来源。
k 折与留一法
k 折交叉验证先把样本随机分成大小相近的 k 份。每一轮取其中 1 份作验证集,用其余 k−1 份训练模型,再在验证集上计算误差或准确率;k 轮结束后取平均,就是交叉验证估计。这样每个样本恰好当一次验证样本,所有数据都参与了训练和评估。当 k 等于样本量 n 时,每轮只留出 1 个样本,就是留一法交叉验证(LOOCV)。
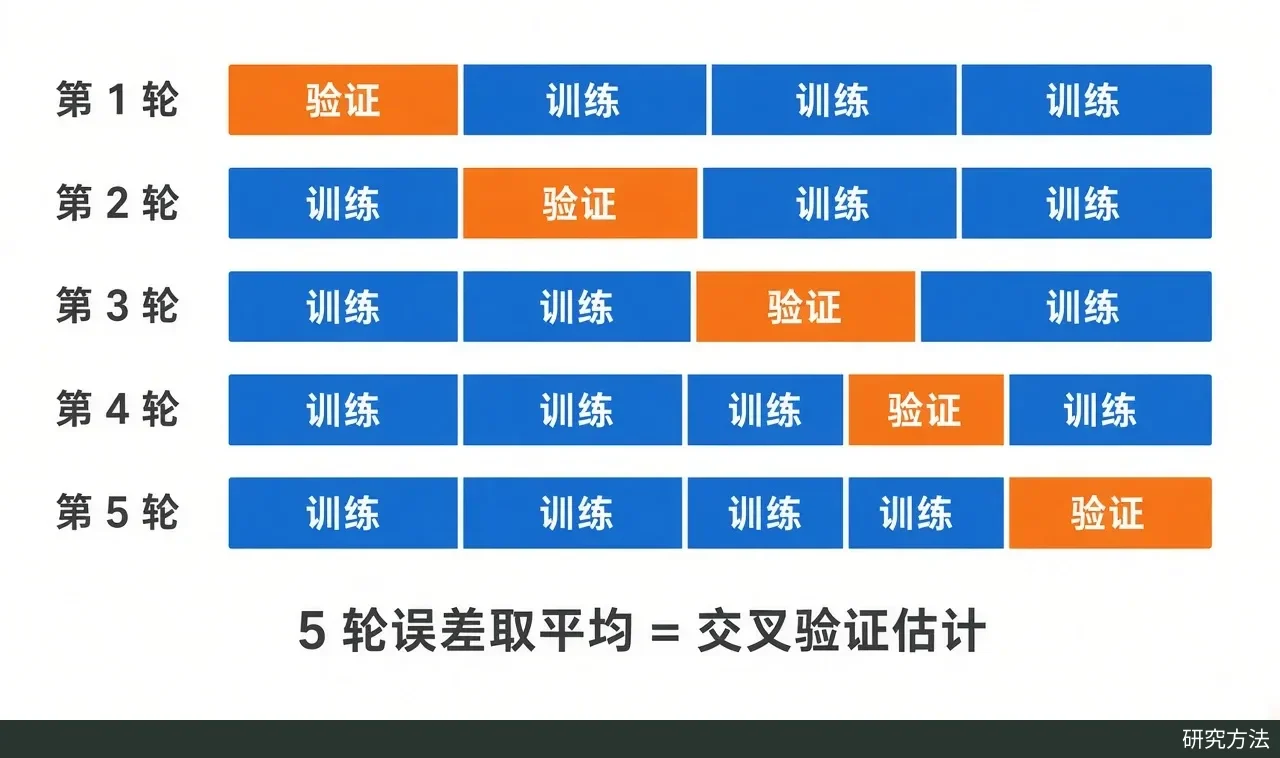
5 折交叉验证:每轮留出一折作验证集,其余四折用于训练,5 轮误差取平均即为交叉验证估计。AI 生成示意图。
k 的选择是偏差与方差之间的权衡。ESL 指出,留一法对期望预测误差近似无偏,但 n 个训练集彼此几乎相同,估计的方差可能较大,计算量也大;5 折或 10 折每轮少用一部分训练数据,如果学习曲线在当前样本量下仍明显上升,就会高估真实误差。书中的结论是 5 折或 10 折是较好的折中,scikit-learn 文档给出的一般建议同样是优先用 5 折或 10 折,而不是留一法。分类问题还常用分层 k 折,让每一折的类别比例与全体样本接近。
还要弄清交叉验证评估的对象。Varma 和 Simon(2006)强调,交叉验证检验的是一套固定的训练算法,而不是某个已经拟合好的模型;只有特征选择、参数调节等全部训练步骤都在每一折内部、只用未留出的数据重做,误差估计的无偏性才有保证。
使用前提:验证数据必须独立
随机划分的 k 折隐含一个前提:样本独立同分布,验证折对训练折来说相当于新数据。scikit-learn 文档提醒,这一假设在实践中很少严格成立。同一位患者的多次测量、同一实验批次或同一台设备产生的数据彼此相关;如果它们同时出现在训练折和验证折,模型可能靠记住个体特征拿到高分,换一批新患者就失灵。这时应按组划分,例如 GroupKFold 或留一组法,保证同一组样本只出现在训练或验证的一侧。
时间和空间结构同理。Roberts 等人(2017)在《Ecography》上综述生态数据的交叉验证时指出,忽视时间、空间、层级或系统发育结构的随机划分,会严重低估预测误差;按时间段、地理区块或分组切分的“区块交叉验证”可以缓解这一问题。他们同时提醒,区块如果沿环境梯度切分,验证折可能落在训练数据未覆盖的预测变量范围内,评估的就变成了外推能力。对按时间排列的数据,scikit-learn 提供的 TimeSeriesSplit 只用较早的观测训练、较晚的观测验证。
常见误用:数据泄漏
最经典的反例来自 ESL 第 7.10.2 节的模拟。设有 50 个样本,平均分属两类,另有 5000 个与类别完全无关的标准正态预测变量,因此任何分类器的真实错误率都是 50%。错误做法是先用全部 50 个样本挑出与类别标签相关最强的 100 个变量,再只对“用这 100 个变量建分类器(书中用 1 近邻)”这一步做交叉验证。50 次模拟中,这样得到的交叉验证错误率平均为 3%,远低于真实的 50%。问题在于第一步已经看过所有样本的标签,被留出的样本并不“新”。正确做法是先分折,在每一折里只用训练部分筛选变量、拟合模型,再预测留出的部分;书中特别说明,不使用类别标签的无监督筛选可以在分折前进行。
调参同样可能泄漏。Varma 和 Simon 用两类之间毫无差异的“零”数据做模拟,每个数据集 40 个样本、6000 个特征:对收缩质心法用 10 折交叉验证选参数,有 18.5% 的数据集报告的最优交叉验证错误率低于 30%;对支持向量机用留一法调参,这一比例为 38%,而这些“最优”模型在独立测试集上并不比随机猜测好。改用嵌套交叉验证,即内层循环调参、外层循环估计误差后,估计值与独立测试集的结果非常接近。
泄漏不只出在变量筛选。scikit-learn 文档把数据泄漏定义为建模时用到了预测时不可得的信息,并指出标准化、缺失值填补、主成分分析等需要拟合的预处理,若在分折前用全部数据拟合,同样会让交叉验证分数过于乐观;文档建议把预处理与模型串成 Pipeline,整体交给交叉验证函数,并用随机标签数据演示了正确做法的准确率会回到接近随机的水平。这类错误在已发表研究中并不少见:Kapoor 和 Narayanan(2023)汇总此前的综述,发现数据泄漏至少影响了 17 个领域的 294 篇论文;在他们复核的内战预测研究中,纠正泄漏后,复杂机器学习模型并不比传统逻辑回归明显更好。
下面的 scikit-learn 写法把变量筛选、模型拟合和调参都放进每一折内部,外层交叉验证给出的才是整套流程的误差估计(X、y 为自备数据):
from sklearn.feature_selection import SelectKBest
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV, cross_val_score
from sklearn.pipeline import make_pipeline

pipe = make_pipeline(SelectKBest(k=100), LogisticRegression(max_iter=1000))
# Inner loop: tune C using only the training part of each outer fold
inner = GridSearchCV(pipe, {"logisticregression__C": [0.01, 0.1, 1, 10]}, cv=5)
# Outer loop: estimate the error of the whole procedure (nested CV)
outer_scores = cross_val_score(inner, X, y, cv=5)