
2026 年 10 月 15 日,Mengtao Wen、Haojie Ren 与 Changliang Zou 在 arXiv 发布预印本,提出变量选择方法 MAS:把某个变量换成常数“代理”,看模型预测误差变差多少,再用 knockoff 式对称阈值控制错误发现率(FDR),无需知道协变量的联合分布。作者模拟中,重尾噪声加强相关时它比近似 knockoff 更守得住 FDR,线性模型里功效则不及专门方法。
论文发布与 knockoff 的分布难题
这篇论文题为《Controlling the False Discovery Rate via Model-Agnostic Importance Measures》,arXiv 编号 2610.21360,v1 于 2026 年 10 月 15 日 06:39(UTC)提交,主分类为统计方法(stat.ME),交叉列入统计机器学习(stat.ML)。第一作者 Mengtao Wen 与 Changliang Zou 署名南开大学统计与数据科学学院,通讯作者 Haojie Ren 署名上海交通大学数学科学学院。截至发稿,它仍是未经同行评审的预印本,arXiv 页面没有期刊发表信息。
它要解决的是高维研究里的老问题:手上有 p 个候选变量(比如几百个基因突变位点),想找出在控制其他变量后仍与结果 Y 相关的那些,同时保证错误发现率——选出的变量里假阳性所占比例的期望——不超过预设水平 α。Barber 与 Candès 2015 年发表的 knockoff 过滤器为每个变量造一个“仿冒品”,让真假变量同场竞争,但要求线性模型且样本量不少于变量数;2018 年发表的 Model-X knockoff 放开了对 Y 模型的限制,代价是必须知道协变量 X 的联合分布。现实中这个分布通常未知,只能近似(例如二阶高斯近似),FDR 能否守住就取决于近似得好不好。打个比方:knockoff 要给每位候选人找一个连人际关系都一模一样的替身,替身不像,比赛就不公平。
MAS 的三处改动
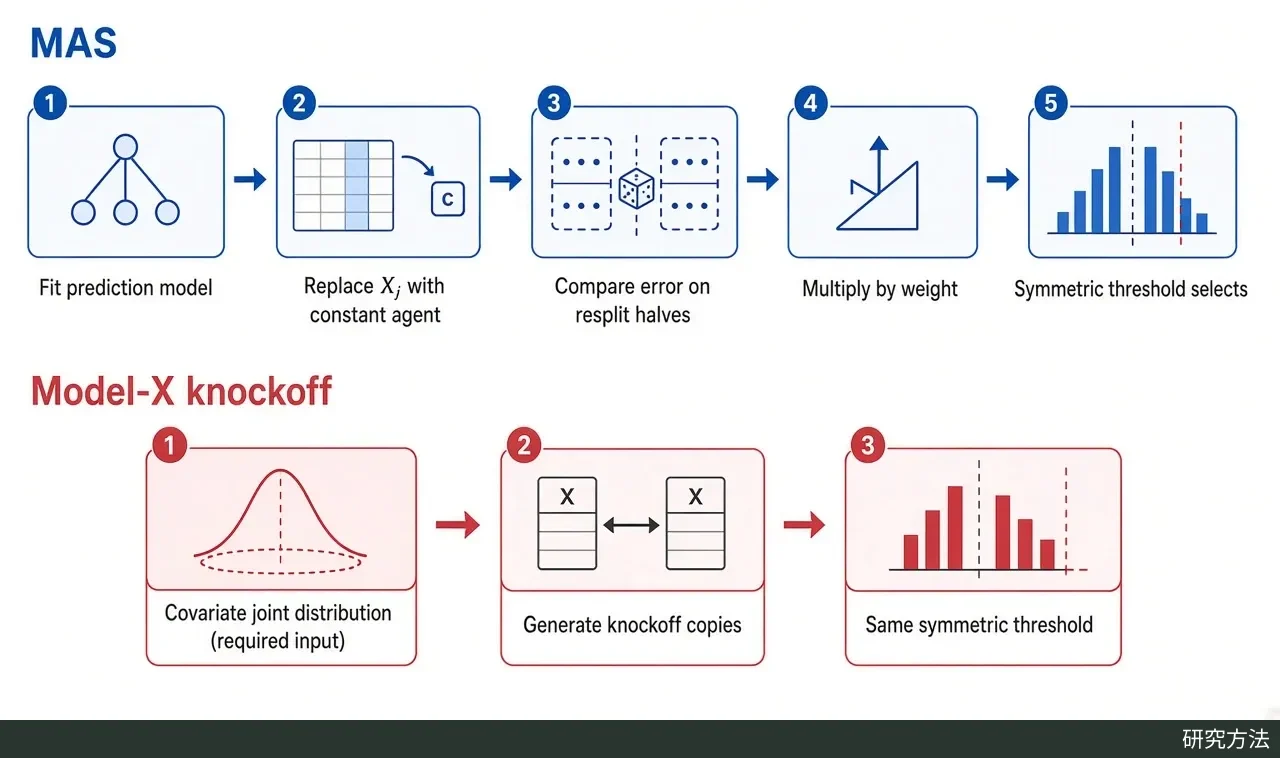
MAS 的思路是不造替身,而是让变量“请假”。作者定义了“代理变量重要性”(agent-X importance):先训练一个预测模型,再把第 j 个变量的取值全部换成与 Y 无关的代理值(对标准化变量推荐取常数 z₀.₉₅ ≈ 1.645),比较替换前后的预测误差。变量真有用,误差会明显变大;变量无关,误差基本不变。与常见的“留一变量”(LOCO)做法相比,它不必删掉变量后重新拟合 p 个模型,计算量大幅下降。论文还给了一个两变量高斯例子:当两变量相关系数 ρ 趋近 ±1 时,LOCO 重要性按 (1−ρ²) 缩到零,代理变量重要性则保持不变。
第二处改动针对统计量之间的相关。为避免零假设下统计量退化,MAS 采用 5 折交叉拟合,并把每折的评估样本一分为二,一半算替换后的误差、一半算原始误差;关键在于这次二分对每个变量独立重新抽签(resplit-per-covariate)。如果所有变量共用同一次切分,无关变量的估计值几乎一模一样,FDR 会失真;各自重抽后,它们近似互不相关。第三处改动是“数据聚合”:给每个统计量乘上一个辅助权重,放大信号、弥补样本切分损失的功效。最后沿用 knockoff 式的无 p 值阈值:无关变量的统计量在零附近正负对称,真信号偏向正值,于是用低于 −t 的个数估计高于 t 的假发现数,取比值不超过 α 的最小 t 作为门槛。
理论上,作者证明 MAS 在样本量与变量数同时增大时渐近控制 FDR,前提是所用学习算法(lasso、XGBoost 等)收敛到最优预测函数。Model-X knockoff 则在协变量分布已知时给出有限样本下的精确保证。换句话说,MAS 把“必须知道 X 的分布”换成了“必须有一个足够好的预测模型”。
对比证据:模拟与 HIV-1 数据
论文的证据全部来自作者自己的模拟和一组公开数据,模拟均重复 400 次,目标 FDR 设为 20%。在线性模型的消融实验中(n=400、p=250、10% 变量为真信号、学习算法用 lasso),MAS 的 FDR 为 19.3%、功效 65.5%;Model-X knockoff 的 FDR 只有 4.4%,过于保守,功效 55.1%。把代理变量重要性换回 LOCO 后,功效跌到 1.2%,运行时间从 4.2 涨到 478.4(论文表中单次重复耗时)。直接对 LOCO 的 p 值做 BH 校正则表现两极:要么一个都不选,要么几乎全选。
差别最明显的是复杂非线性模型(n=600、p=100、20 个真信号):作者让协变量和噪声都来自重尾的 t(3) 分布,并逐步加大变量间相关 ρ。下表摘自论文表 3(FDR / 功效):
| 相关系数 ρ | MAS-XGBoost | MAS-集成学习 | Knockoff |
|---|---|---|---|
| 0 | 19.3% / 60.5% | 18.5% / 79.3% | 8.2% / 80.4% |
| 0.2 | 19.2% / 60.2% | 18.7% / 79.5% | 14.0% / 81.5% |
| 0.4 | 19.3% / 56.6% | 17.5% / 79.3% | 23.4% / 82.0% |
| 0.6 | 17.8% / 46.4% | 20.4% / 77.6% | 29.5% / 76.8% |
ρ 升到 0.4 以后,近似高斯 knockoff 的 FDR 超过 20% 的目标,ρ=0.6 时达到 29.5%;两种 MAS 都停在 20% 附近。在正态分布设定下,knockoff 反而偏保守(FDR 7.8%–13.1%)。另一面,MAS 的功效明显取决于学习算法:同样的重尾强相关场景,XGBoost 版本只有 46.4%,换成 lasso、随机森林与 XGBoost 的堆叠集成后升到 77.6%。
并非所有场景 MAS 都占优。在线性模型(n=600、p=400、80 个真信号)里,基于去偏 lasso 的 BH 方法和数据分割法(DS)功效都高于 MAS 与 knockoff——它们本就是为线性模型设计的。在较简单的非线性模型中,高斯近似 knockoff 已经够用,MAS 的功效低于 knockoff。真实数据方面,作者分析了 HIV-1 蛋白酶抑制剂耐药数据,对 7 种药物逐一检测与耐药相关的突变,以已知的治疗选择突变(TSM)列表近似作为真值,各方法重复运行 100 次。结果显示 MAS 与 knockoff 的 FDR 控制好于 DS 和 BH,DS 在 APV、IDV、NFV、RTV 四种药物上 FDR 超标;MAS 的功效与 knockoff 相当,在不同药物间更稳定。这组结果在论文中只以箱线图呈现,没有给出逐药数值。
适用边界与选用建议
- 证据层级:这是 2026 年 10 月 15 日首发的预印本,尚无同行评审和独立复现;我们查阅的 arXiv HTML 全文未给出 MAS 的实现代码链接,想试用需按论文算法自行实现。
- 保证类型:FDR 控制是渐近的,依赖学习算法收敛。如果协变量分布能够可靠建模,Model-X knockoff 的有限样本保证仍然更硬。
- 学习器决定功效:在 n=600 的线性模型中改用随机森林时,p=200 下 MAS 的功效仅 0.6%;论文提出的协变量自适应增强版能升到 11.6%,但作者承认这一版本还缺乏严格理论。
- 代理值需要权衡:代理常数越大功效越高,但小样本下 FDR 更容易超标;论文推荐的 z₀.₉₅ 是其模拟设定下的折中,并非普适最优。
- 样本切分的代价:交叉拟合与逐变量二分会损失功效,也让结果随切分随机变化,实际使用宜多次重复运行并报告选择结果的稳定性。
- 怎么选:相信线性模型时,去偏 lasso 加 BH 或数据分割法通常更有力;关系复杂、协变量分布难以建模而预测模型较好训练时,MAS 可以作为 knockoff 之外的备选,作者也明确把它推荐给高维稀疏问题。