研究结束时,有人仍未发生事件,有人已经失访;把他们删掉或一律算作“没事”,都会丢失随访信息。生存分析把已观察的时间与未知的结局分开处理。本文从右删失和 Kaplan–Meier 曲线出发,说明对数秩检验与 Cox 模型各自回答什么,再用可复算的 R 算例检查比例风险假设,避免把风险率比读成绝对风险。
右删失与生存曲线
生存分析研究的是“从规定起点到规定事件的时间”。事件可以是死亡、复发或设备故障,时间零点可以是入组、手术或设备启用;起点和事件必须先定义一致。设真实事件时间为T,停止观察时间为C,实际记录的是Y=min(T,C),以及事件指示δ:观察到事件时为1,右删失时为0。[1–3]
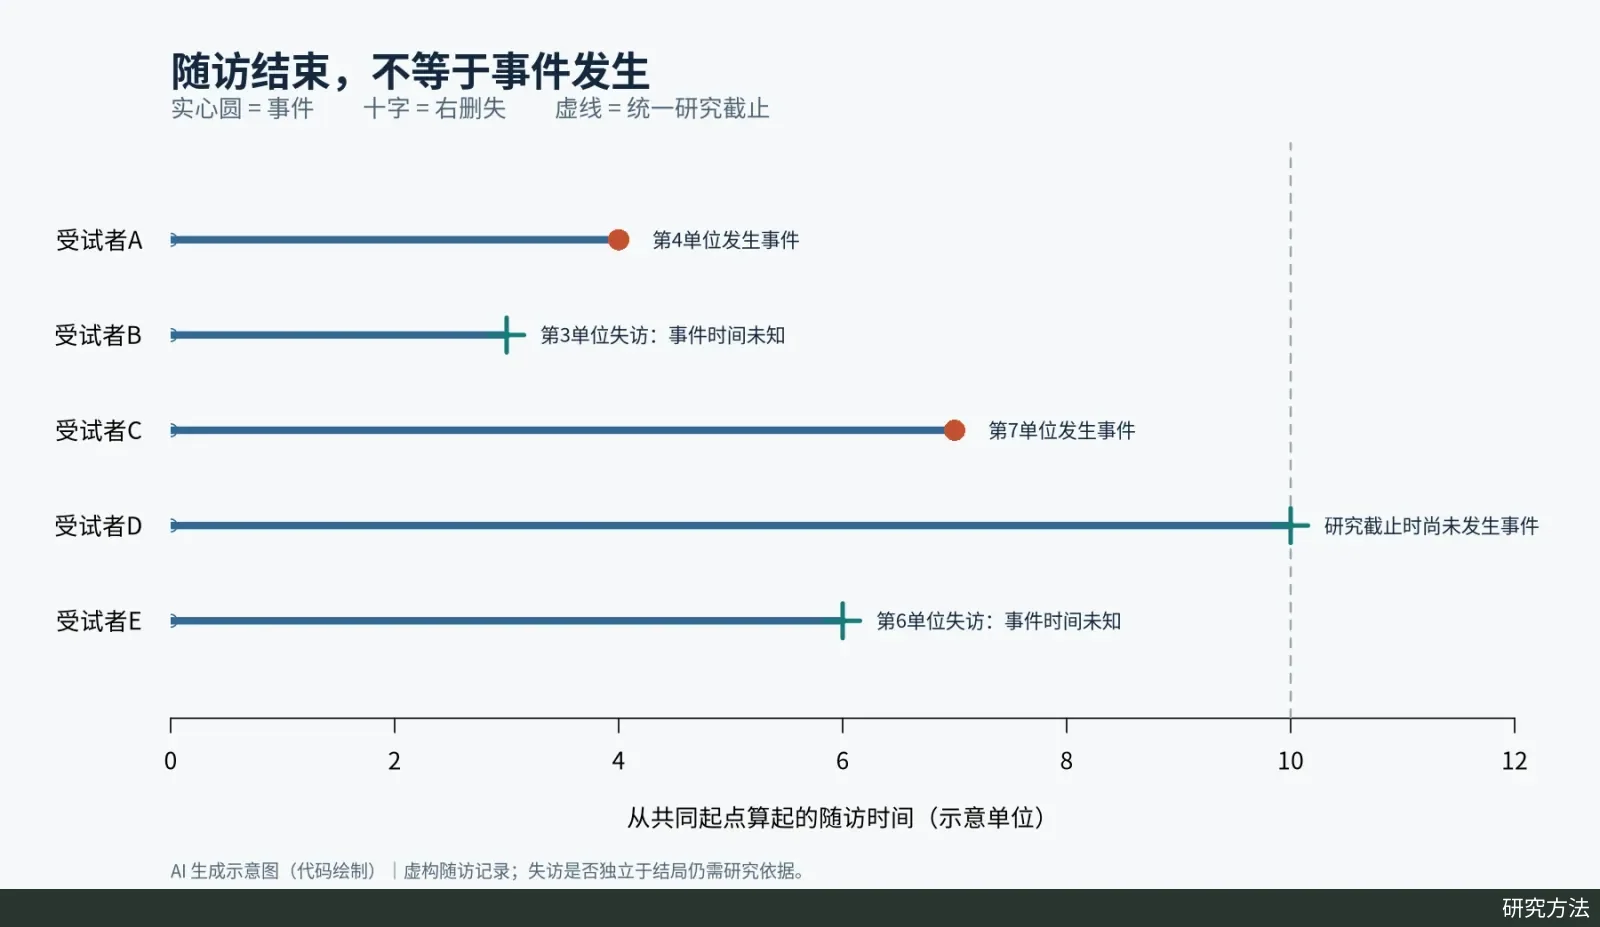
例如,一个人在第6个月最后一次随访时尚未复发,此后联系不上。我们知道的是T>6个月,而不是“永不复发”,也不是“第6个月复发”。研究按计划截止时仍无事件,也会产生右删失;它与因病情恶化而退出研究的失访,虽然记录形式相同,背后的机制可能很不一样。
Kaplan与Meier在1958年6月发表的论文讨论了如何从这种不完整观察估计生存函数S(t)=P(T>t)。常用写法是:
Ŝ(t)=∏_{tⱼ≤t}(1−dⱼ/nⱼ)。
tⱼ是不同的事件时点,dⱼ是该时点发生事件的人数,nⱼ是该时点之前仍在随访且尚未发生事件的人数,即风险集。每一步先计算“已撑到这里的人继续无事件”的比例,再把这些条件比例相乘。删失者在停止观察前仍贡献信息;删失本身不让曲线下降,却会缩小此后的风险集。[1,2]
这不是绕过未知信息的魔法。普通分组KM估计要求在各组内,删失者后续的事件经历能由仍被观察者代表,通常用事件时间与删失时间独立来表达;调整模型则需要相应的条件独立假设。原文已提醒这一假设须仔细审视。若病情更差的人更容易失访,曲线可能偏乐观;删失比例低也不能单独证明没有偏倚。[1]
读图还要看风险集与置信区间:尾部只剩几个人时,阶梯的变化很不稳定。曲线未降至0.5,中位生存期就是“未达到”,不能拿最后随访时间代替。题图拟用的时间线为虚构示意,不代表某项临床研究。
组间比较与协变量调整
KM曲线描述各组在不同时间仍未发生事件的概率;比较整段随访中的组间差异,常用对数秩检验。它在每个事件时点,按风险集中两组的人数计算零假设下的期望事件数,再汇总观察值与期望值的差异。它给的是检验结果,不直接给出“多活多少天”或某个时点相差多少个百分点。[2,3,6]
普通对数秩检验在两组风险率大致成比例时尤其有效。曲线交叉时,早期和晚期差异可能相互抵消,检验不显著也不能据此认定两组没有值得研究的差异;但不能倒过来说,只有严格满足比例风险,检验才有意义。分析目标、比较时限和检验方法宜事先确定,不应看到曲线后反复更换检验,挑出最小的p值。
若要同时考虑年龄等协变量,可以使用Cox在1972年论文中提出的模型:
h(t|x)=h₀(t)exp(βᵀx)。
h(t|x)是在已存活至t的条件下,紧接着发生事件的瞬时速率;h₀(t)是未预先指定形状的基线风险率。拟合通常通过事件时点的风险集构造偏似然来估计β,无须先给h₀(t)选一个参数分布。[2]
对其他协变量相同的两个人,某个协变量相差一个单位时,风险率比HR=exp(β)。HR为0.6,表示模型下瞬时风险率约为比较对象的0.6倍;它不等于“某日死亡概率减少40%”,也不意味着“寿命延长40%”。绝对风险还取决于基线风险和时间范围。对观察数据加入几个协变量,也不会自动消除混杂或产生因果结论。
比例风险假设与解释边界
比例风险假设要求:在模型所规定的协变量比较下,HR不随时间改变。它没有要求h₀(t)恒定;两组风险率完全可以一起随时间升高或降低,只要其比值保持不变。KM曲线是否交叉可以提供线索,却不能单独确认或排除这一假设。[2]
R的cox.zph使用缩放Schoenfeld残差相关的得分检验,可查看各模型项及全局结果;plot()给出随时间变化的系数β(t)估计及不确定性。若比例风险成立,真实β(t)应为水平线,水平位置不必是0。实际判断应结合平滑趋势、区间、事件数和研究背景。p>0.05只表示在该检验下未发现足够证据,不能写成“比例风险假设已被证明”。[4]
若某个分组变量不满足假设,可考虑分层Cox,使各层拥有不同基线风险,但这样不再估计该分层变量的共同HR。若主要关心某种暴露的作用如何变化,可考虑预先规定的时间交互,报告随时间变化的效应;Cox原文已讨论这种扩展。也可重新明确比较时限和估计目标,例如比较某个时限内的平均无事件生存时间,不能把它当作同一个HR的替代数值。[2,7]
几个常见误用须分开检查:信息性失访不能靠比例风险检验排除;连续变量函数形式错误也不会因检验不显著而消失;曲线尾部的小风险集不能支持精确的远期预测。若研究特定死因或某种首次事件,其他互斥事件属于竞争风险,把它们一律当作普通删失后用1−KM解释现实中的累积发生概率,估计目标就错了,应考虑累积发生率及Aalen–Johansen等相应方法。竞争风险分析与全因死亡的生存分析,需要先分清问题。[7,8]
用R复算一组随访数据
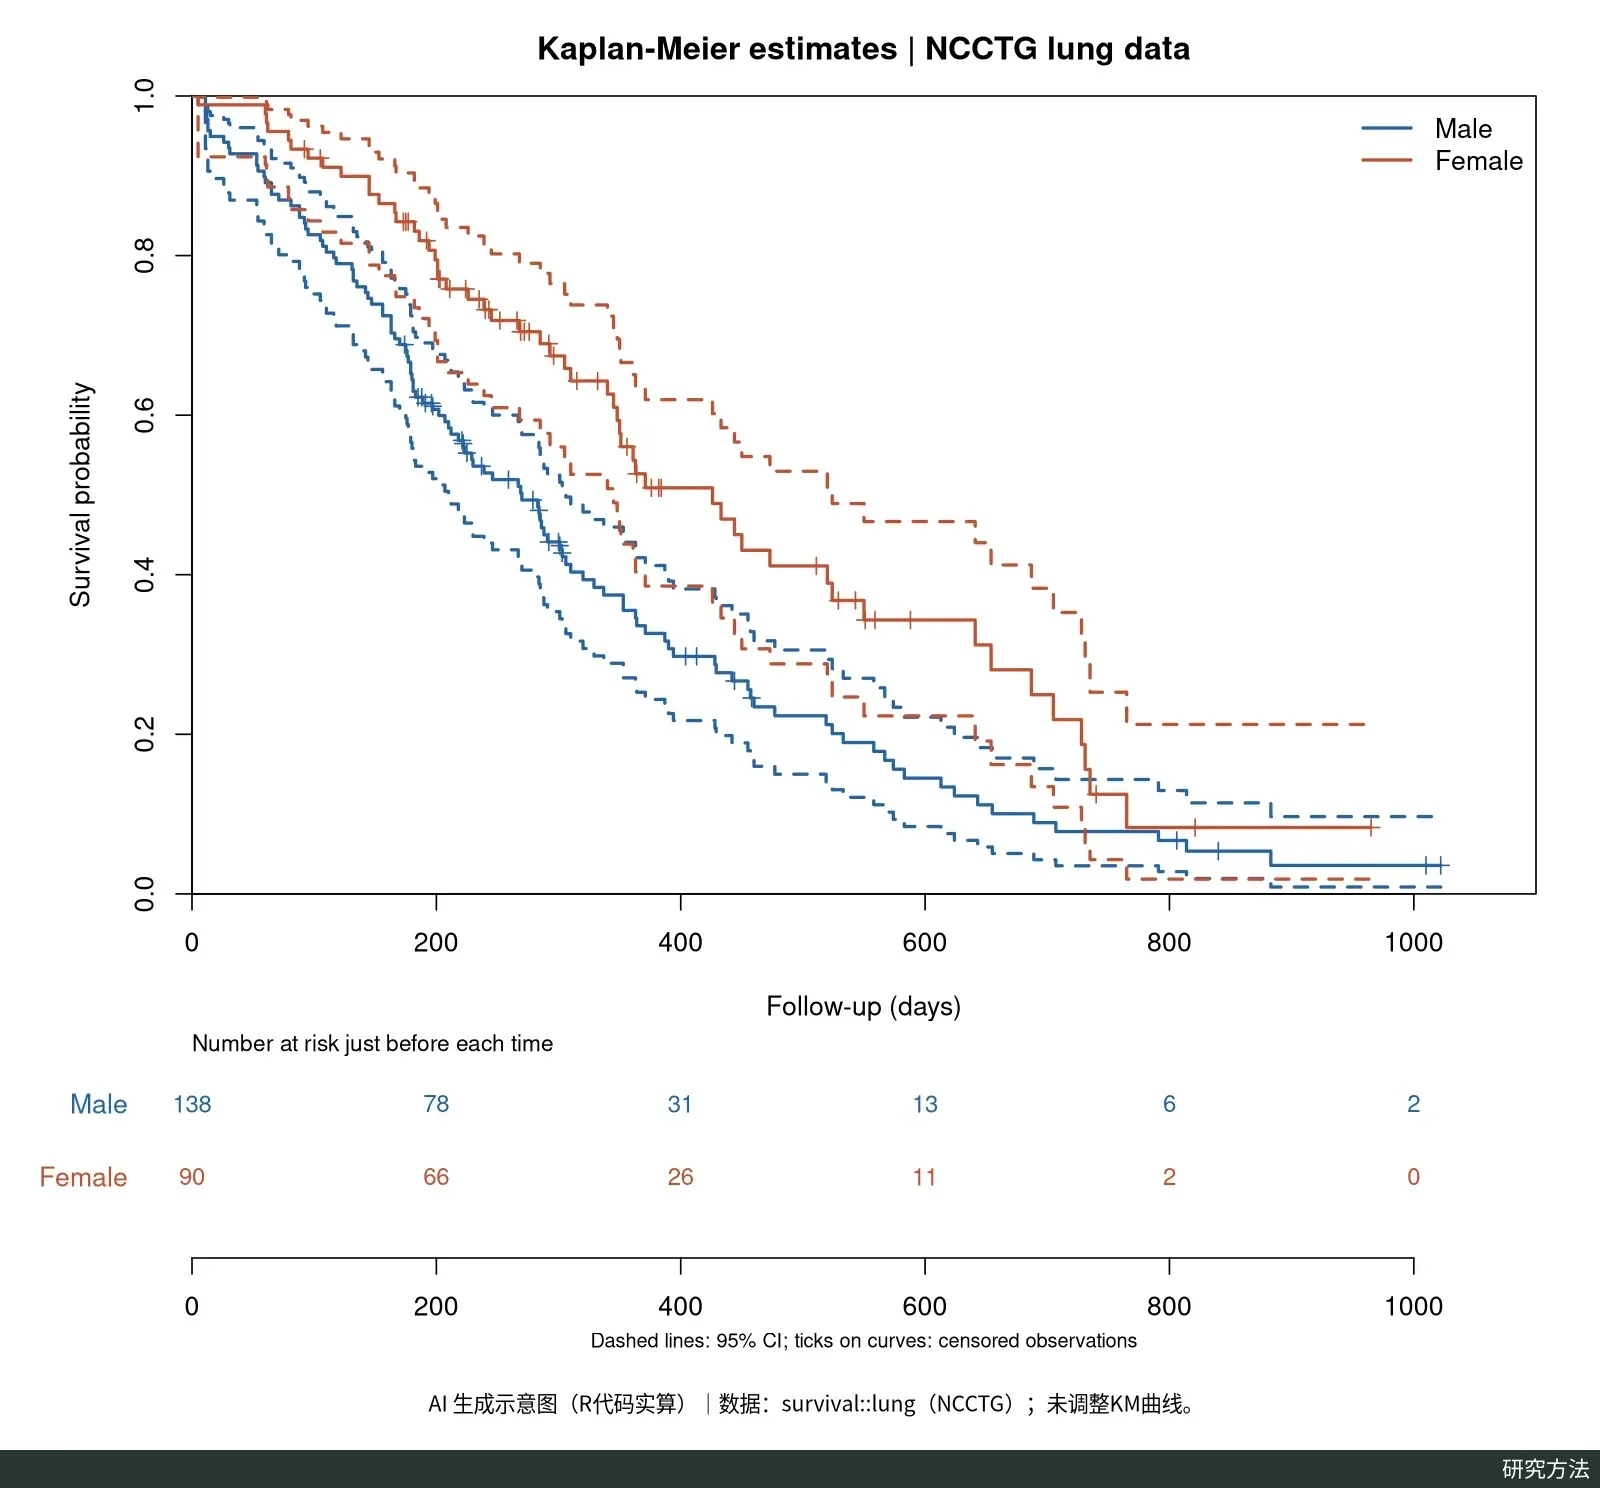
下面用survival包内的lung数据演示完整流程。官方帮助将其描述为NCCTG晚期肺癌患者数据,并引用Loprinzi等1994年的预后研究;这不是本文新做的临床试验。time的单位是天,status原编码1=删失、2=死亡,sex原编码1=男性、2=女性,不能直接把status当作0/1事件变量。[5]
代码只按本模型需要的time、status、age、sex处理缺失,避免因其他未使用变量缺失而多删样本。先画未调整的男女KM曲线,再做对数秩检验,最后拟合年龄调整的Cox模型,并检查PH假设。年龄在此按线性项处理,仅为入门示范,不代表已完成模型选择、函数形式检查或临床预测验证。
本次在R 4.5.0、survival 3.8-3下实际运行:原始228人,排除0人,分析228人,其中165个死亡事件;男性138人、112个事件,女性90人、53个事件。对数秩检验χ²约10.327,1个自由度,p=0.001311。Cox模型中,女性相对男性的年龄调整HR为0.5986(95%置信区间0.4311–0.8311);年龄每增加1岁的HR为1.0172(0.9990–1.0357)。这些结果描述该数据与模型中的关联,不能推成某种干预的疗效。
cox.zph的p值约为:年龄0.65、性别0.11、全局0.25。实际诊断图中,性别系数平滑线随时间有上升趋势,尾部区间较宽;这里可以报告“该检验未拒绝比例风险假设”,不能只凭全局p值就宣告诊断通过。代码同时导出生存曲线和诊断图,便于对照复算。
library(survival)
raw <- survival::lung
vars <- c("time", "status", "age", "sex")
d <- raw[complete.cases(raw[, vars]), vars]
stopifnot(all(d$status %in% c(1, 2)), all(d$sex %in% c(1, 2)))
d$event <- as.integer(d$status == 2)
d$sex <- factor(d$sex, levels = c(1, 2), labels = c("Male", "Female"))
cat("Original:", nrow(raw), "Excluded:", nrow(raw)-nrow(d),
    "Analysed:", nrow(d), "Events:", sum(d$event), "\n")
print(with(d, table(sex, event)))
km <- survfit(Surv(time, event) ~ sex, data=d, conf.type="log-log")
lr <- survdiff(Surv(time, event) ~ sex, data=d, rho=0)
print(lr)
cat("Log-rank p:", pchisq(lr$chisq, length(lr$n)-1, lower.tail=FALSE), "\n")
fit <- coxph(Surv(time, event) ~ age + sex, data=d,
             ties="efron", x=TRUE)
print(summary(fit))
ph <- cox.zph(fit, transform="km")
print(ph)
png("km-lung.png", width=1600, height=1300, res=160, type="cairo")
layout(matrix(c(1, 2), ncol=1), heights=c(4, 1.3))
cols <- c("#2563A5", "#C45131")
par(mar=c(4, 5, 3, 2))
plot(km, col=cols, lwd=2, conf.int=TRUE, mark.time=TRUE,
     xlim=c(0, 1100), ylim=c(0, 1), xaxs="i", yaxs="i",
     xlab="Follow-up (days)", ylab="Survival probability",
     main="Kaplan-Meier estimates | NCCTG lung data")
legend("topright", levels(d$sex), col=cols, lwd=2, bty="n")
par(mar=c(3, 5, 0, 2))
plot.new(); plot.window(xlim=c(0, 1100), ylim=c(0, 3), xaxs="i")
ticks <- c(0, 200, 400, 600, 800, 1000)
text(0, 2.8, "Number at risk just before each time", adj=0, cex=0.85)
for (i in 1:2) {
  risk <- sapply(ticks, function(t) sum(d$sex==levels(d$sex)[i] & d$time>=t))
  text(ticks, 3-i, risk, col=cols[i], cex=0.9, xpd=NA)
  mtext(levels(d$sex)[i], side=2, at=3-i, las=1, col=cols[i], line=2)
}
axis(1, at=ticks)
mtext("Dashed lines: 95% CI; ticks on curves: censored observations", 1, line=2, cex=0.75)
dev.off()
png("ph-diagnostics.png", width=1600, height=800, res=150, type="cairo")
par(mfrow=c(1,2)); plot(ph); dev.off()
print(summary(km, times=ticks)$n.risk)
print(sessionInfo())
生存曲线图注:研究方法使用上述R代码绘制,数据来源为survival::lung(NCCTG)。蓝线Male为男性,橙线Female为女性;实线为未调整KM估计,虚线为点态95%置信区间,短刻线为删失记录。表中是在相应时点之前仍在险的人数,不是该时点累计事件数。第1000天男性仅剩2人在险、女性为0人,远端曲线尤其不宜过度解读。