
模型拟合完成,研究问题往往才开始:两种条件下的预测差多少,不同人群又有何区别?2026 年 9 月 10 日,marginaleffects 项目发布 R 包 1.0.0,把更新重点放在模型之后的比较与不确定性计算。分组、加权分析有了更完整的自动微分支持,旧脚本也有一处明确需要迁移的接口。
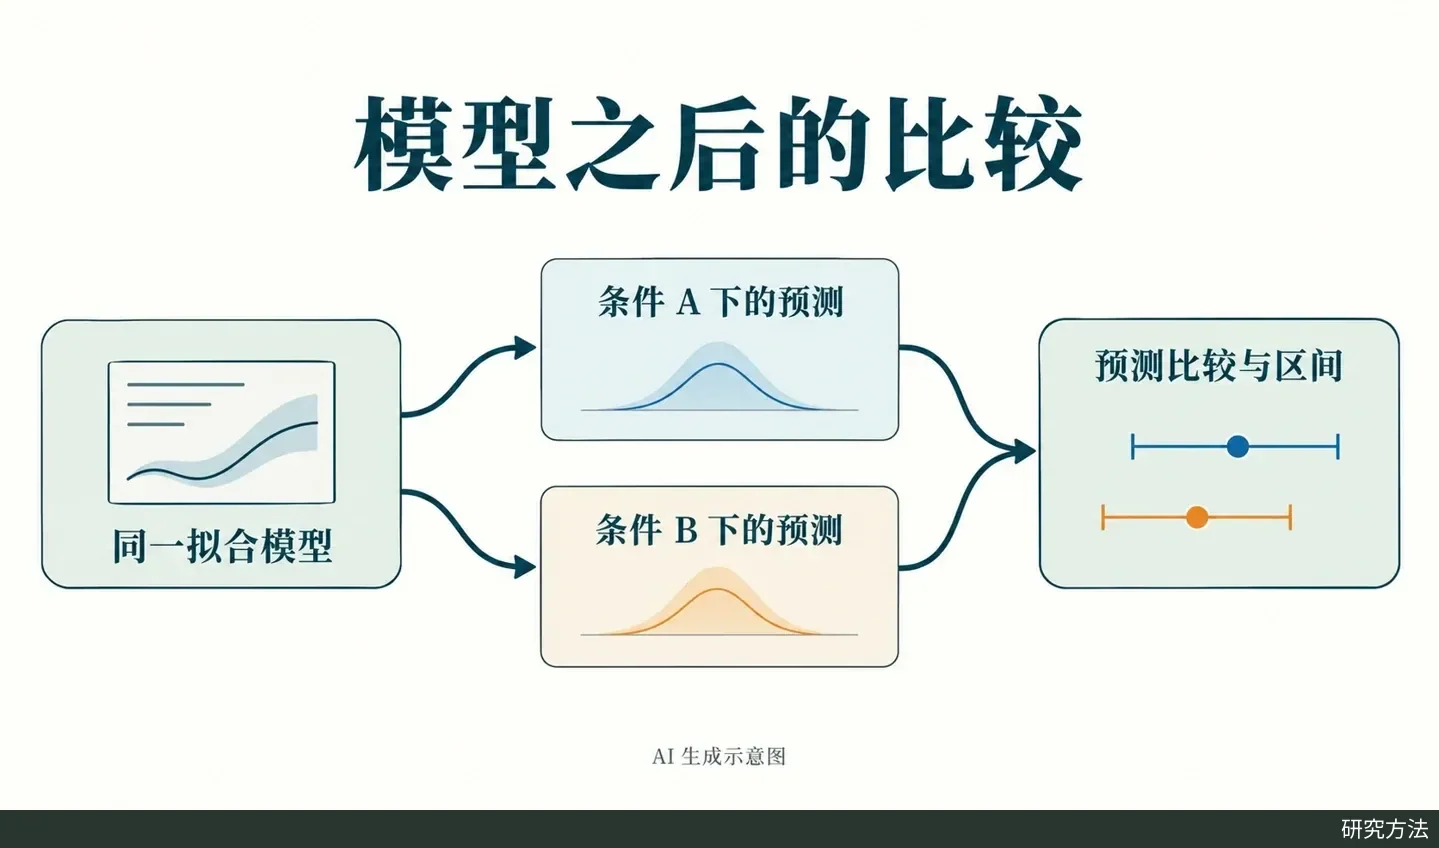
从拟合转向比较
这次发布值得关注的不是版本号到了整数,而是解释模型结果的工作范围扩大了。官方更新说明列出新增的调查加权向量广义线性模型支持,以及其他模型接口。它不是纯修复版本。
更贴近日常研究的是分组比较:例如,在模型中分别设置两种条件,比较每个人的预测,再按研究目标汇总。comparisons() 与 avg_comparisons() 处理的是预测之间的比较;回归系数本身未必就是读者关心的概率差或预测差。这里的例子只是说明用途,不代表新版做过某项实证研究。
分组计算的新路径
自动微分不是 1.0.0 才首次出现:官方版本记录已在 0.30.0 介绍这条计算路径。此次推进的是适用组合,包括加权平均、以数据框指定的分组、矩阵或向量形式的假设,以及分组平均中的比值比较;相关计算整合进单一 JAX 流程。
它改变的是导数如何计算,进而影响标准误计算的效率与数值表现。有限差分通过小幅改变参数来近似导数;自动微分沿计算过程求导。对于受支持的复杂汇总,研究者可减少另写求导与拼接结果的工作,但仍须先决定比较什么、按谁的分布平均。计算路线更顺畅,不会自动赋予比较以因果意义。
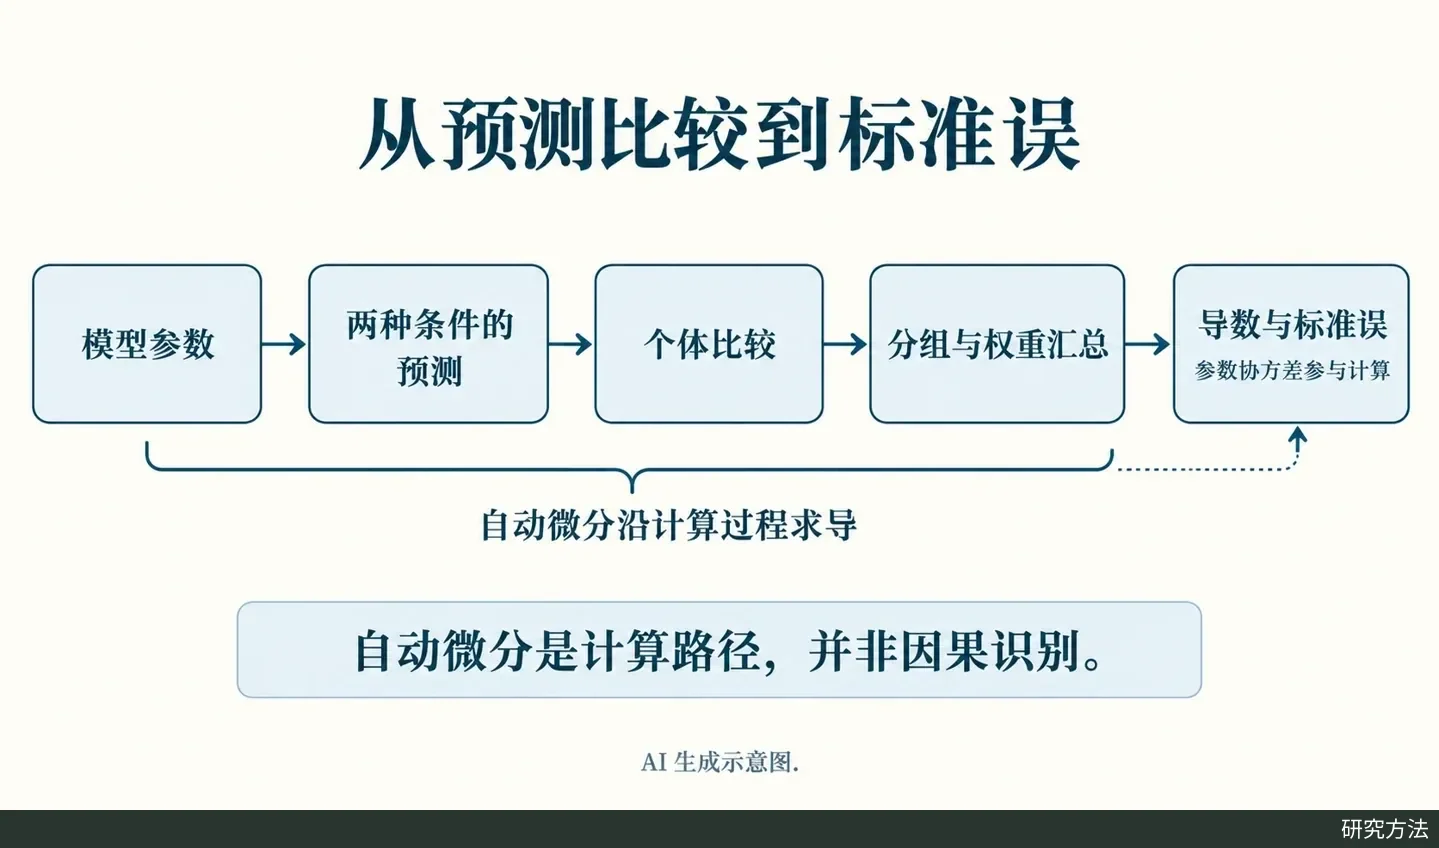
升级前的接口检查
迁移时先检查旧代码有没有 byfun:1.0.0 已不再支持它,自定义汇总应转向 hypothesis。在循环、嵌套函数或 Shiny 中难以找回训练数据的工作流,可留意新增的 set_modeldata(),显式把训练数据附到模型对象。
自动微分也不能理解为安装新版后所有模型都自动切换。按官方当前接口文档,需在每个会话调用 autodiff(TRUE) 启用,autodiff() 可查询状态;它经由 reticulate 使用 Python 的 JAX。文档仍标注为实验性功能,列明支持的模型包括 lm、glm、ols,不支持的模型或调用会回退到有限差分。因此,“打开开关”与“本次调用确实使用该路径”需要分开理解。
最该关心这次更新的是反复报告分组预测差异、加权平均比较的应用研究者,以及维护自动化分析脚本的人。建议在独立环境保存旧结果,用相同数据、模型、权重和假设对照新版的估计值、标准误与行标签;这是迁移建议,本文未执行软件性能或数值测试。若当前工作只需简单系数表,这些新能力未必立刻成为升级理由。