
2026 年 10 月 13 日,美国西北大学统计学家 Elizabeth Tipton 在 arXiv 发布预印本,为预测模型补上一种“事前功效分析”:只需样本量、预测变量数、假定的总体 R² 和刻画杠杆分布的设计效率因子 D*,就能在收集结果数据之前,估算留一法下的期望样本外 R²,并判断最小二乘或岭回归能否胜过“直接用均值预测”。
握着智能手机的手(2019 年拍摄,与论文研究无直接关联,仅作主题示意;论文实例用手机行为日志预测人格)。摄影:Artem Beliaikin,来源:Flickr,许可:CC0 1.0。
预测研究缺少的事前设计计算
做假设检验的研究者习惯在动手前算统计功效:样本够不够大,能不能检出想要的效应。转向预测模型的社会科学研究却很少有对应工具。论文指出,现有的预测样本量公式主要服务于临床预测模型(Riley 等,2019)和多基因评分,并不针对社会科学常用的最小二乘和岭回归;经典的“R² 收缩”公式则只看样本量 n 和变量数 p。结果是,当一个模型的样本外 R² 令人失望时,研究者很难分辨原因:是现象本身难以预测、测量太差,还是这个设计从一开始就撑不起预测。
Tipton 的切入点是区分两个常被混用的量。调整后的样本内 R² 估计的是总体参数 ρ²,即预测变量在总体中能解释多少结果方差,它不随样本量变化;样本外 R²(论文记为 R²_oos)衡量的是某一项具体研究能把这部分解释力“兑现”多少,取决于 n、p 和设计本身,性质上更接近统计功效。论文据此推导出在只有协变量、尚无结果数据时就能计算的期望样本外 R² 和期望样本外相关系数 r_oos。
四个设计输入与设计效率因子 D*
公式只需要四个输入:样本量 n、预测变量数 p、研究者假定的总体 R²(ρ²_in),以及新引入的设计效率因子 D*。D* 取值在 0 到 1 之间,只用协变量矩阵就能算出,概括各观测的杠杆值(leverage)分布得是否均匀:每个观测的杠杆一样时 D* = 1,少数观测远离其他观测时 D* 下降。可以把它想成一张桌子的几条腿——重量平均分在四条腿上最稳,压在一条腿上,留出任何一个观测去预测时误差都会被放大。在最小二乘下,期望样本外 R² 约为 (nψ − 1)/(n − 1),其中 ψ = ρ²_in − (1 − ρ²_in)(p + 1)/[(n − p − 1)D*]。与只依赖 n 和 p 的经典公式不同,这里协变量的不平衡和偏态都会进入计算。
由此得到一个实用门槛:要让期望样本外 R² 不低于 0,也就是模型至少不输给用样本均值预测,总体 R² 必须达到 ρ²_min = 1/n + (1 − 1/n)(p + 1)/[(p + 1) + (n − p − 1)D*]。论文称之为预测版的“最小可检测效应量”。补充材料在 n = 100、p = 10 的设定下演示了 D* 的敏感性:一个 90/5/5 分布的分类变量使 D* 降到 0.949,96/2/2 时降到 0.843,偏态协变量平均降到 0.749,最大杠杆值从 0.11 升至 0.68。对岭回归,论文给出设计阶段即可计算的惩罚参数 κ* = p(1 − ρ²_in)/ρ²_in(与 Hoerl 等 1975 年提出的取值相同),再用有效参数个数 p_eff 和岭回归版 D* 替换公式中的 p 和 D*。
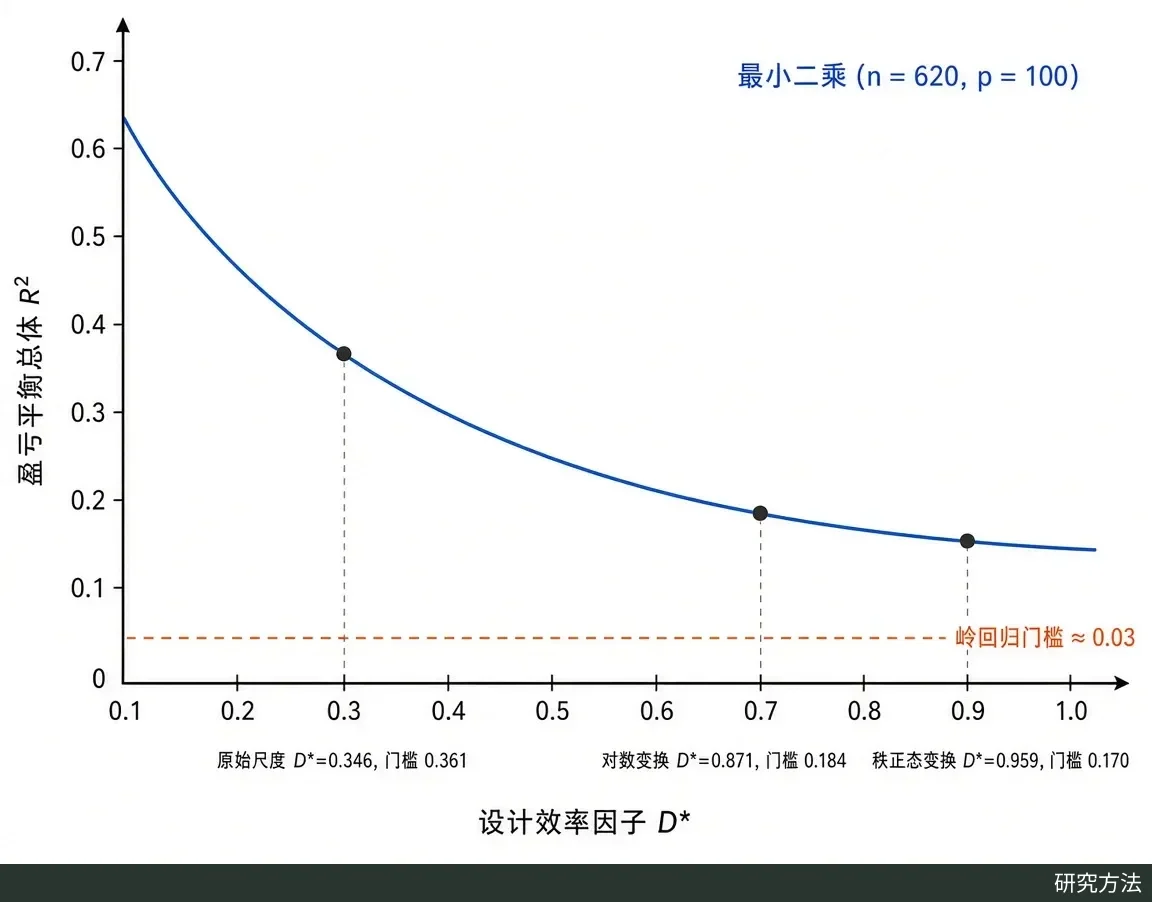
最小二乘的盈亏平衡总体 R² 随设计效率因子 D* 升高而下降(n = 620、p = 100,依据 Tipton 2026 推论 2.1)。图中标注的 D* 与门槛数值取自论文 PhoneStudy 分析,曲线、竖线与岭回归虚线的位置仅为示意,未按精确刻度绘制,读数以正文为准。AI 生成示意图。
模拟研究与手机人格预测实例
论文用模拟检验公式与实际留一法结果的吻合度:n 取 30、60、250、600,(p + 1)/n 从 0.1 到 2.0,再交叉总体 R²、信号结构(稠密、稀疏)和共线性、高杠杆条件,共 1,920 个情景,每个情景重复 1,000 次。在 (p + 1)/n ≤ 0.5 时,最小二乘公式的中位绝对误差从 n = 30 时的 0.029 降到 n = 600 时的 0.001,岭回归公式从 0.018 降到 0.002。p 逼近 n 时最小二乘公式明显变差((p + 1)/n 从 0.1 到 0.9,误差由 0.0015 升至 0.056),岭回归公式在 p + 1 = 2n 时误差仍为 0.012。设计阶段算出的 κ* 与交叉验证选出的惩罚参数相近,后者在结果数据到手后平均多得 0.016 的样本外 R²,差距主要出现在小样本(n = 30 时为 0.048)。
实例选自 Stachl 等人 2020 年发表在 PNAS 上的手机行为预测人格研究:620 名参与者(原 624 人,剔除 4 名未报告性别者),1,821 个手机行为变量,预测外向性中的“社交性”分面。取前 100 个变量时,原始尺度的 D* 只有 0.346,最小二乘要求总体 R² 至少 0.361 才能胜过均值,而调整 R² 的 95% 置信区间只有 [0.073, 0.199],实际留一法样本外 R² 为 −0.171。也就是说,预测变量并非没有信息,而是这个 n、p 和 D* 的组合无法把信息转化为样本外精度。对变量做秩正态变换后 D* 升至 0.959,门槛降到 0.170;岭回归的门槛约为 0.03,实际样本外 R² 为 0.079。使用全部 1,821 个变量时,岭回归门槛为 0.053,用 REML 估计的总体 R² 为 0.221(95% 区间 0.133–0.324),实际样本外 R² 为 0.088。作者强调,这类事后比较接近循环论证,与事后功效分析的毛病相同;公式准确性的证据来自模拟,而不是这个实例。
适用边界与 predpower 工具状态
论文明确列出适用前提:每个单位一个结果、误差同方差、没有聚类;目标是留一法的样本外统计量,其他评估方式结论不同;协变量假定没有测量误差。总体 R² 必须由研究者事先假定,和功效分析里的效应量一样,假定不准,结果就不准。公式给出的是期望值而非抽样分布,恰好达到门槛的设计只在大约一半的样本里能胜过均值;要“稳定”胜出,还需要样本外 R² 的方差。惩罚回归只处理了岭回归:信号稠密时,公式比 lasso 实际达到的值高约 0.048;真实信号稀疏(只有 1 个非零系数)时,lasso 反而高出约 0.162,公式变成可达精度的下界。共线性使岭回归的系数先验假设不成立时,公式会偏乐观约 0.04。此外,门槛只回答“能否胜过均值”,多大的样本外 R² 才值得用于决策,社会科学目前还没有公认标准。
配套 R 包 predpower 托管在 GitHub。按论文描述,它可从协变量矩阵计算 D* 和岭回归版 D*、期望样本外 R² 与相关系数、盈亏平衡门槛,并可反解达到目标样本外 R² 所需的样本量或变量数,内置 PhoneStudy 设计作为示例。截至本文核对时,该仓库没有发布版本记录,本文也未实际安装运行;论文为 arXiv 预印本 v1,尚未见同行评审或期刊发表信息。