
2026 年 10 月 19 日,Uri Simonsohn 在 Data Colada 博客介绍了 ResearchBox 的一项新功能:研究者上传 Qualtrics 问卷的 .qsf 文件后,平台会自动生成一份配套 PDF,先按单个参与者的视角展示问卷,再用彩色标注列出逻辑、随机化和各条件之间的文本差异。不使用 ResearchBox 的人,也可以在独立页面完成转换。
日本厚生劳动省检疫所的英文版纸质《健康状况问卷》,仅作问卷示意,与本文所述研究无关。图:contraption,来源:Flickr,许可:CC BY 2.0。
QSF 文件为什么难以审查
Simonsohn 在文中称 Qualtrics 是社会科学网络研究的主流平台,但它“并不是为社会科学家设计的”。Qualtrics 问卷的原生保存格式是 .qsf。按 Qualtrics 官方帮助页的说明,QSF 文件包含问卷的全部格式与设置,不含任何作答数据,主要用来备份或把问卷迁移到另一个 Qualtrics 账户;下载到本地后通常打不开,因为这是“只有 Qualtrics 能读取的特殊格式”。Simonsohn 补充说,QSF 内部是 JSON,这种格式便于计算机存储结构化数据,人却很难直接读懂。
要让人看懂一份 QSF,原文列出两条现有途径。第一条是登录 Qualtrics,经过一串不直观的步骤导入文件,再点“预览”,像参与者一样逐屏走一遍。第二条是在平台内把问卷导出为 Word。Qualtrics 官方把 Word 导出定位为“可读副本或数据字典”,包含题目、区块、分页和选项,但可能丢失部分自定义格式,问卷中的图片也不会被带过去。Simonsohn 的评价是,这种导出有时可用,但常常塞满无用信息;他展示的反例来自自己与 Daniel Banki 做的一项研究,而且按他的说法,那还是一项“异常简单”的研究。
对审稿人来说,难处在于实验设计的关键信息往往不在题目文字里,而在流程设置中:谁被分到哪个条件、选项是否打乱、哪些人会被跳转或拦下。打个比方,读 JSON 像对着电路图猜一台机器怎么运转;走一遍预览则像亲自试用一次,但每次只能走到其中一条路径,其他条件下参与者看到了什么,仍然看不到。
自动生成的两部分 PDF
据原文,作者在 ResearchBox 上传 QSF 文件后无需任何额外操作,平台会自动生成一份配套 PDF,并与原 QSF 放在一起。这份 PDF 以封面页开头,正文分两部分。第一部分按某一位随机参与者实际会看到的样子呈现问卷,每个原始屏幕是一个带编号的框(Screen #1、Screen #2……)。第二部分是完整问卷,即不同参与者可能看到的全部内容,并用彩色标注说明逻辑、随机化和作答验证等设置。原文的示例显示,第二部分会标出某题选项按随机顺序呈现,以及注意力检查要求至少答对 4 题才算通过。
对于不同条件看到不同内容的实验,第二部分用彩色文字把各条件的替代文本并排列出。原文用的例子是 Kahneman 与 Tversky 的经典框架效应研究:参与者读到同样的事实,即一场即将暴发、可能导致 600 人死亡的疫情,再在两个风险不同的方案之间选择;实验比较的是把结果表述为“获救人数”还是“死亡人数”会如何影响选择。在转换后的 PDF 里,两种表述被并排显示。
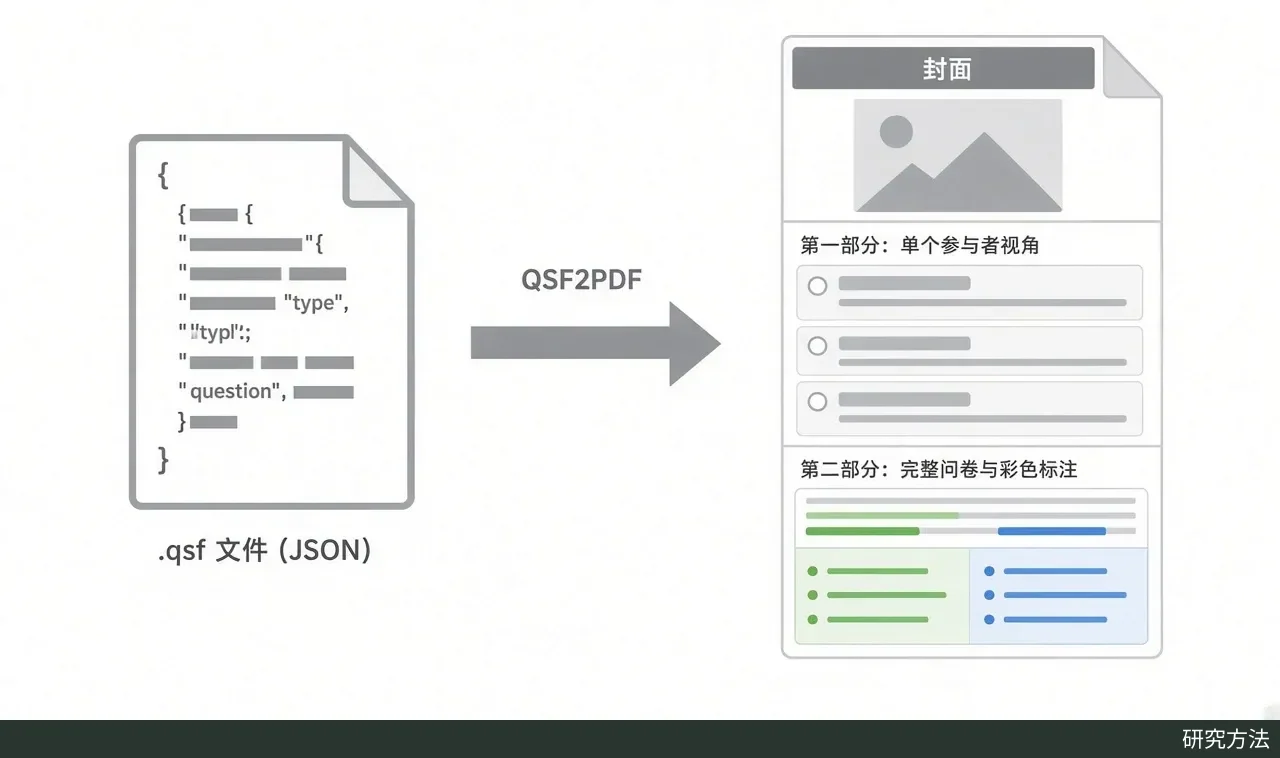
QSF2PDF 的转换流程与生成 PDF 的结构:左侧 .qsf 文件,右侧依次为封面、单个参与者视角的第一部分、带彩色标注的完整问卷第二部分。AI 生成示意图,依据 Data Colada 原文描述,非 ResearchBox 实际输出截图。
Simonsohn 写道,整份 PDF 自动生成,通常不到 1 秒;其中的彩色文字由程序直接读取 QSF 拼出,没有作者参与,也没有使用 AI。不使用 ResearchBox 的研究者可以打开独立的 QSF2PDF 页面,把 .qsf 文件拖进去转换,再把得到的 PDF 上传到自己习惯的平台。读者也可以用它转换别人公开的 QSF,比如论文作者放在 OSF 或 Dataverse 上的问卷文件。
对照预注册的用法
原文没有专门讨论如何拿 PDF 核对预注册,下面是本站依据其功能整理的用法。预注册通常会写明有几个条件、各条件操纵什么、按什么标准排除参与者、主要因变量是什么。拿到转换后的 PDF,可以逐项对照:看第二部分并排的条件文本,判断操纵内容是否与预注册描述一致;看随机化标注,确认条件和选项是否确实随机;看验证与注意力检查的标注,核对排除标准的阈值;再按第一部分的屏幕顺序,确认因变量是在操纵之后测量的,以及有没有预注册里没提到的额外量表。
举一个假设的例子:预注册写的是“排除注意力检查答对少于 3 题的参与者”,而 PDF 第二部分标注的通过门槛是至少答对 4 题。这类不一致在 JSON 里藏在嵌套字段中,在 Word 导出里可能淹没在冗余信息里,在彩色标注的 PDF 中则更容易被看到。发现差异并不等于作者有问题,阈值也可能在正式收集数据前有过合理调整,但这正是审稿人应当追问的地方。
ResearchBox 首页写明,新建的 box 默认私密,专为同行评审设计:文件不会被搜索到,链接带可更换的口令,作者身份隐藏。首页还列出了与预注册平台 AsPredicted 的集成,两者都由 Wharton Credibility Lab 托管。不过,现有官方页面没有说明这项集成是否会把预注册与问卷 PDF 自动对照,目前仍需人工逐项核对。
适用边界与局限
第一,它只能说明问卷文件里设定了什么。QSF 是导出那一刻的问卷快照,不含作答数据;PDF 再清楚,也不能证明收集数据时用的就是这一版,更不能说明数据分析是否按预注册执行。判断时间先后,仍要依靠预注册的时间戳和数据本身。Qualtrics 官方还提到,QSF 会包含回收站里的题目;转换时这些题目如何处理,原文和官方页面都没有说明。
第二,适用范围有限。工具只处理 Qualtrics 的 QSF 文件,其他问卷或实验平台不在原文讨论之内。第一部分展示的只是一位随机参与者的路径,要看全部条件必须读第二部分。原文和独立页面也没有列出支持哪些 Qualtrics 功能(例如自定义 JavaScript、嵌入数据、配额),没有说明转换不完整时会不会提示,也没有说明拖入的文件如何处理和保存。流程复杂的问卷,最好与 Qualtrics 预览交叉核对;含敏感内容的问卷,使用前应先确认文件处理方式。
第三,信息来自开发方。Simonsohn 是 Wharton Credibility Lab 的联合主任,ResearchBox 正由该实验室托管。文中对 Qualtrics 导出效果的批评、“通常不到 1 秒”的转换速度,都来自开发方自己的展示,本站没有独立测试转换效果。