
一张手绘问卷:三道题各在五级李克特量表上勾选了一个刻度(仅作问卷主题示意,与文中论文的测量工具无关)。图:Oliver Tacke,来源:Flickr,许可:CC0 1.0。
2026 年 10 月 2 日,Khashayar Pourtaheri 与 Ahmad Zareei 在 arXiv 发布预印本,检验该给大语言模型扮演的“合成受访者”提供哪类个人信息。在 845 名美国成年人的两轮追踪数据上,只给人口学、人格和认知分数描述时,个体层面的预测仅达到真人重测基准的 7%–12%;加入本人早先的作答记录后升至 28%,但仍远低于真人。
五级信息叠加的研究设计
用大语言模型模拟问卷受访者的做法常被称为“硅样本”(silicon samples),Argyle 等人 2023 年在 Political Analysis 发表的研究让这一说法广为流传:给模型一段真实受访者的人口学背景,让它代为作答,再把合成样本的作答分布与真人比较。此后的评估大多停留在总体层面,即各选项比例是否接近。这篇新论文追问更苛刻的一层:模型能否代替某一个具体的人作答。论文 v1 于 10 月 2 日提交,10 月 12 日更新为 v2,目前是未经同行评审的预印本。
数据来自 Stango 与 Zinman 在 The Review of Economic Studies 发表研究所用的两轮面板:845 名美国成年人在 2014–15 年和 2017 年两次完成同一套行为经济学测量。作者选取其中 14 种“行为偏差”作为结果,例如现时偏好、损失厌恶和过度自信——这里的“偏差”指偏离理性选择标准模型的系统倾向,而不是统计学意义上的估计偏差。每人每种偏差记为“有”或“无”,模型的任务是预测第二轮的结果。生成模型为 Claude Opus 4.8,作答于 2026 年 8 月生成,每道题单独开新对话。
提示信息分五级逐层叠加:A1 不给任何个人信息;A2 加入 16 项人口学字段;A3 再加 BFI-10 大五人格分数;A4 再加数字运算、金融素养等四项认知测验分数;A5 再加该受访者第一轮对其他题目的作答,作者称之为“行为历史”。为防止泄题,A5 会扣除用于计分目标偏差的整个题块,模型看不到此人上次在这一偏差上的表现。由于相邻两级只差一个信息块,比较它们就能看出这一块信息带来多少增益。
评价指标没有用准确率。各偏差在人群中的比例从 0.17 到 0.85 不等,一律猜多数类也能拿到不错的准确率。举个例子:若某种偏差 85% 的人都有,一个永远回答“有”的模型准确率是 85%,却对任何具体的人一无所知。作者改用 informedness,即 J = 真阳性率 + 真阴性率 − 1;上面那个模型的真阳性率为 1、真阴性率为 0,J 恰好为 0。对照基准则是“真人重测”:用同一个人第一轮的结果去预测他第二轮的结果,这代表人自身跨时间的稳定程度,是衡量模型的参照。
总体相似掩盖的个体差距
只看总体平均,五种条件都“很像人”:每人平均表现出的偏差数在 7.1–8.1 个之间,真人为 7.1 个。但人与人之间的差异被压扁了。A1 的标准差只有 0.73,真人为 1.90;只给人物描述的 A2–A4 仅恢复真人人际差异的 53%–67%;加入行为历史的 A5 标准差为 1.94,人际差异回到约与真人相当的水平。这说明,用总体分布对齐来验证硅样本,会漏掉“人人都差不多”这种失真。
个体层面的差距更清楚。准确率从 A1 的 0.550 到 A5 的 0.569 几乎不动,真人重测为 0.709;informedness 则拉开了档次:A1 为 0.001,A2–A4 为 0.020–0.033,相当于真人基准 0.283 的 7%–12%;A5 为 0.078,达到 28%。在按收入、教育、族裔、年龄、性别等划分的 17 个人口学组里,A5 的估计值都是各条件中最高的,而只给描述的条件在部分组里接近零甚至为负。作者还做了一个打乱检验:把 A5 的输出在人口学特征相近的受访者之间重新分配,J 从 0.078 降到 0.026(p < 0.001),说明增益确实来自“对上了这个人”,而不只是学到了群体平均。
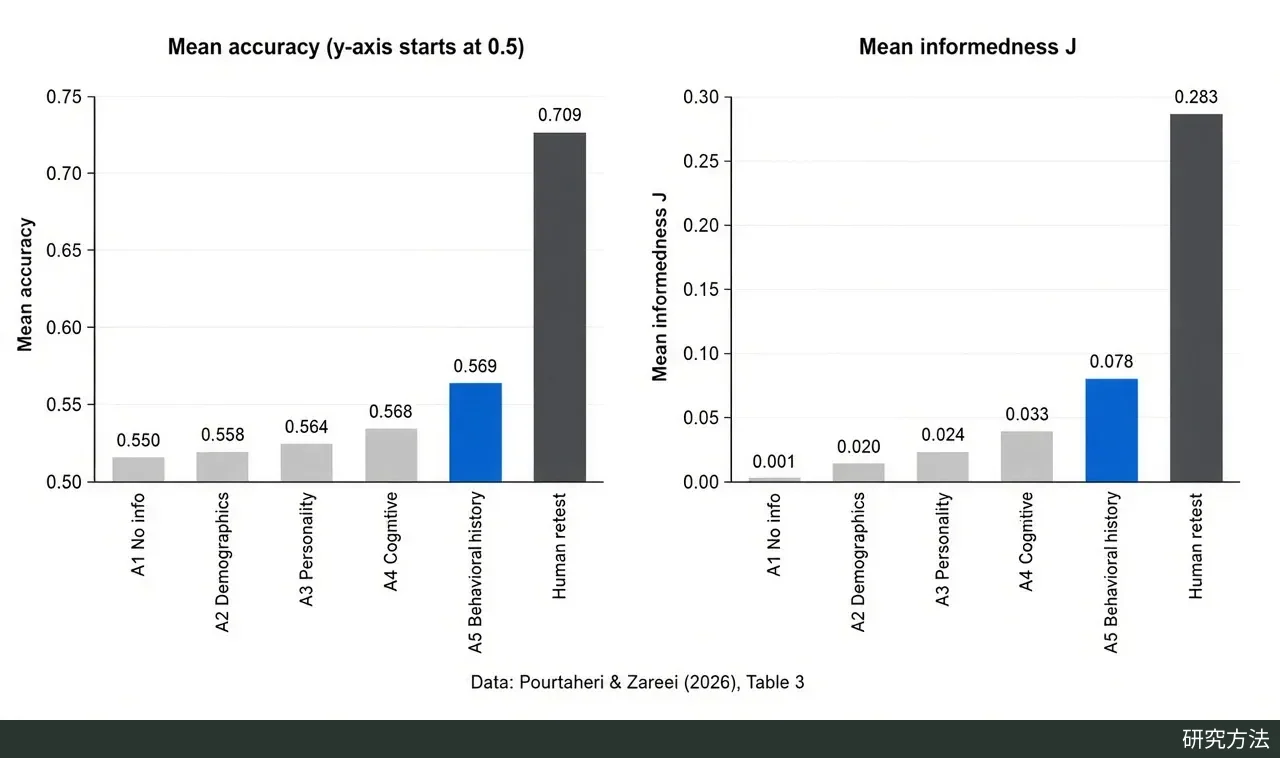
AI 生成示意图:左为平均准确率(纵轴从 0.5 起),右为平均 informedness。随提示信息增加,准确率几乎不变;加入行为历史(A5)后 informedness 明显上升,但仍远低于真人重测。柱上数值据 Pourtaheri & Zareei(2026,arXiv:2610.03998)表 3,柱高为示意,未严格按刻度绘制,读数以标注为准。
同期另一项研究从不同数据得出方向一致的结论。Lukauskas 与 Šarkauskaitė 10 月 10 日在 arXiv 发布的审计,用一份立陶宛组织心理学问卷(263 人、68 题)测试了 47 个生成式模型和 14 个直接输出量表概率的“决策模型”。在预测每个人自己的作答时,基于 11 项档案字段、在 163 名真人上拟合的回归也只比“其他受访者的作答频率”好 1.0%,作者因此建议,以这类档案构建的合成受访者应以样本层面的保真为目标。两项研究合起来看:只知道一个人“是谁”,模型很难知道他“会怎么答”。
适用边界与使用建议
28% 是进步,但离“替代受访者”还很远。用来判断合成画像是否更接近本人而非他人的身份识别 AUC,A5 只有 0.552,真人重测为 0.718(0.5 相当于随机)。反过来,一个分类器能以 AUC 0.976 区分 A5 的合成画像与真人画像,却分不开同一批真人的两轮数据(0.476)。Mantel 检验也没有发现任何条件复现了真人各偏差之间的相关结构。在 207 个“偏差 × 子群”单元中,表现最好的合成条件仍有 84% 低于真人基准。
合成数据还会放大某些群体差异。在真人数据中,教育和收入只占受访者属性所解释变异的 18%;合成数据里这一比例在 A2 为 74%,加入行为历史的 A5 仍有 49%。也就是说,模型更倾向于按学历和收入给人“贴标签”。论文还发现,真人的损失厌恶随收入略有上升,而所有带人物画像的条件都给出了相反方向。若研究目标本身是群体差异,这类扭曲会直接影响结论。
作者列出的局限同样决定了结论的适用范围:只用了一个模型、一个美国面板和 14 种以文字测量的偏差;每个“受访者 × 题目 × 条件”只生成一次,测得的部分人际差异可能来自生成的随机波动;源数据公开,可能已进入模型训练语料,研究设计无法区分模型是学到了总体规律,还是记住了个人记录。所谓行为历史也只是一次较早的问卷。模型输出与分析代码需向作者索取,原始调查数据可从原研究的公开复现材料获得。
对使用者而言,这篇论文给出的是一条收窄的建议,而不是硅样本的通行证。若用途要求个体层面的替代,例如补全某人缺失的作答或预测个人选择,应尽量收集与目标最相关的既往行为记录,并先在保留样本上用 informedness 这类不受多数类影响的指标检验个体一致性;面对没有既往作答记录的新人群,这种增益就无从谈起。若只用于预调查、题目试测等需要总体轮廓的场景,也应同时检查方差和群体差异,而不只是比较平均值。