
1908 年 3 月,《生物统计》(Biometrika)刊出署名“学生”(Student)的论文《均值的可能误差》。作者是都柏林吉尼斯酒厂的化学师威廉·西利·戈塞特。他要解决的是实验中常见的困境:只做了几次测量,连样本标准差本身都不可靠,判断均值时误差界该放宽多少?论文给出的答案,就是后来的 t 分布。
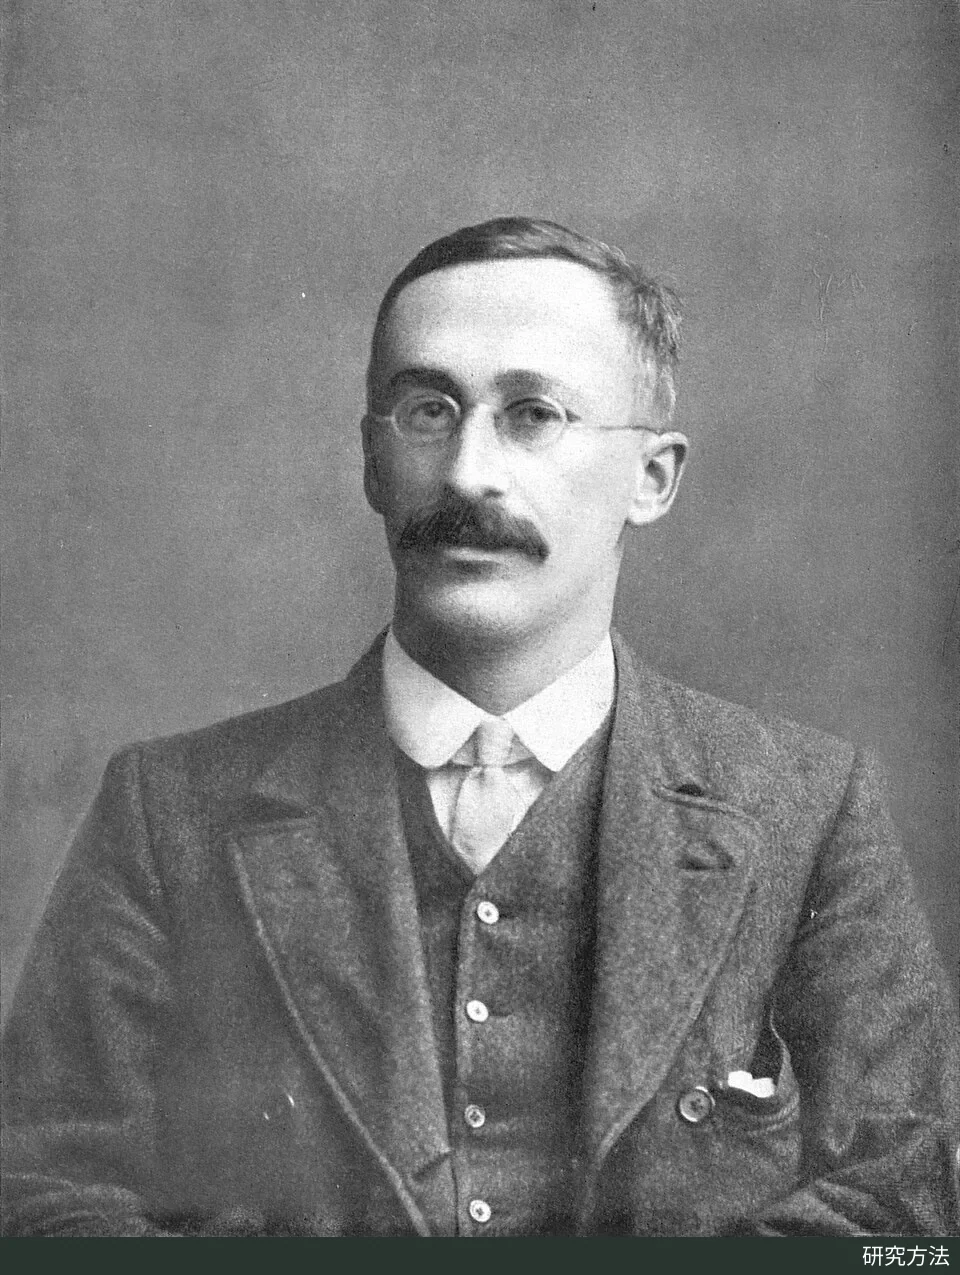
威廉·西利·戈塞特,摄于 1908 年,即《均值的可能误差》发表当年。照片扫描自《优生学年鉴》(Annals of Eugenics)所载讣告,摄影者不详。来源:Wikimedia Commons,许可:公有领域。
吉尼斯酒厂的小样本难题
戈塞特 1876 年生于坎特伯雷,在牛津新学院修读化学和数学,1899 年进入都柏林的亚瑟·吉尼斯父子公司担任化学师。1904 年,他为酒厂写了内部报告《“误差律”在酒厂工作中的应用》,1905 年又带着几个具体问题去见卡尔·皮尔逊。其中一个问题后来成了 1908 年论文的主题:如果分析次数无穷多,他可以说“真值落在分析结果 2.6 以内的赔率是 10 比 1”;可次数有限、有时还不多时,“显然必须放宽界限,但我不知道该放宽多少”。1906–1907 学年,他在皮尔逊位于伦敦的生物统计实验室进修,随后发表了这篇论文。雇主要求向竞争对手隐去作者身份,所以论文署名只有“Student”。
论文开篇就点明了这类问题有多普遍:有些化学实验、许多生物实验以及大多数农业和大规模实验,很难反复做很多次,只能凭一个很小的样本来判断结果的可靠性,而这个样本本身就是变异程度的唯一线索。戈塞特写道,这类实验“迄今几乎在统计研究的范围之外”;人们都知道正态曲线只在样本“大”时才可信,却“没有人清楚地告诉我们”大样本和小样本的界线在哪里。
小样本下的误差界
当时的常规做法,是把样本标准差 s 当作总体标准差 σ,用 s/√n 去查正态分布表。戈塞特指出,样本越小,s 本身的误差就越大,照这样得出的判断“可能完全误导”。打个比方:这就像用一把刻度会随机伸缩的尺子去衡量误差,尺子碰巧缩短的时候,同样大小的偏差就显得格外大。把样本均值的偏差除以一个本身也在波动的 s,得到的比值会比正态分布更分散,两侧尾部更厚。
要放宽多少,取决于样本量。以双侧 95% 为例,正态分布的临界值是 1.96;按今天的 t 分布,样本量 n=4(自由度 3)时临界值是 3.18,区间要宽约 62%;n=10 时是 2.26,宽约 15%;n=30 时是 2.05,只宽约 4%。这正回答了论文提出的问题:大样本与小样本之间没有一刀切的界线,校正幅度随样本量连续变小。
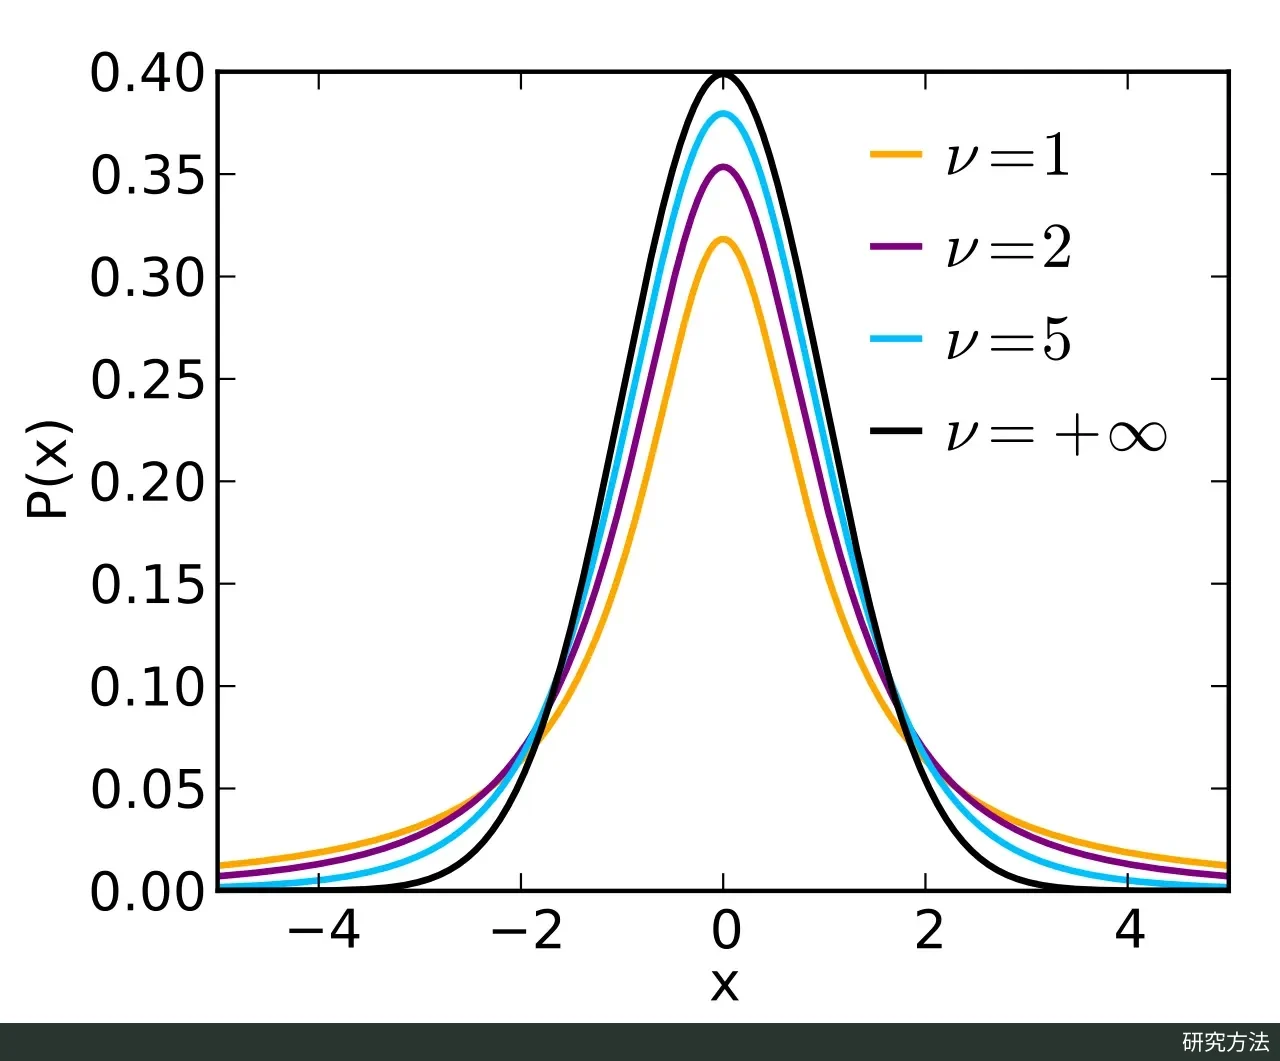
自由度 ν=1、2、5 的 t 分布与标准正态分布(ν=+∞,黑线)的密度曲线:自由度越小,峰越低,两侧尾部越厚。作者:Skbkekas(IkamusumeFan 修订),来源:Wikimedia Commons,许可:CC BY 3.0。
从 z 到 t 的数学要点
戈塞特假定总体服从正态分布,分三步推导。第一步,他算出样本方差 的前四阶矩(当时按除以 定义),发现它们符合皮尔逊 III 型曲线,由此写出 的分布,也就是今天熟知的卡方分布的缩放形式;他坦言自己“没有实际证明”,只是假定它成立。第二步,他论证正态总体中样本均值与样本标准差互不相关。第三步,他据此求出
的分布,其密度与 成正比,并为小样本编制了概率表。
为了检验推导,他还做了一次手工随机抽样:把 3000 名罪犯的身高和左手中指长度写在 3000 张卡片上,充分洗牌后逐张抄录,每 4 张为一组,共得到 750 个样本,再把 750 个 值与理论曲线比较,结果吻合良好。MacTutor 的传记称之为蒙特卡洛方法的早期应用。
据 E. S. 皮尔逊回忆, 检验在酒厂里立即投入使用,但在别处大约十几年都少有人用;1922 年戈塞特把新编的表寄给费希尔时还打趣说,“你大概是唯一会用它们的人”。今天通用的形式来自费希尔:1925 年他在意大利期刊《Metron》发表《“学生”分布的应用》,用多维空间体积的方法证明了样本均值与方差相互独立、分布形式准确,并把统计量改写为
其中 是以 为除数的样本标准差,自由度 。t 分布的密度为
当 时收敛为标准正态分布。费希尔还把 t 推广到两样本比较和回归系数检验。除数之争也有一段插曲:戈塞特本人更倾向小样本时用 ,皮尔逊却在 1912 年对他说两者差别无关紧要,“因为只有淘气的酿酒师才会把 取得那么小”。
实例、前提与现实意义
论文用 Cushny 与 Peebles 1904 年发表的催眠药数据作示范:10 名病人分别服用氢溴酸莨菪碱的右旋体和左旋体,记录比不服药时多睡的小时数。戈塞特把同一病人的两次结果相减,差值均值为 1.58 小时,标准差 1.17(按除以 n 计算),即 z≈1.35,查表得出左旋体催眠效果更好的赔率约为 666 比 1。他还指出,差值的标准差之所以小,是因为同一病人对两种药的反应相关,这正是配对设计的好处。按今天的配对 t 检验,同一组数据 t≈4.06,自由度 9,双侧 p≈0.003。论文还用沃本农场的大麦试验判断种子烘干是否值得:烘干种子平均产量更高的赔率约为 14 比 1,而烘干后大麦品质变差的赔率则“非常大”。
如今,回归结果里每个系数旁边的 t 值、样本均值的置信区间,追根溯源都来自这篇论文。但它有前提。戈塞特明确说,结论严格来讲不适用于已知非正态的总体,不过他判断偏离正态要相当极端才会造成严重错误;他检验用的身高和指长数据本身就略偏离正态,对 z 的分布影响很小。经济学家 Ziliak 还提醒,戈塞特从商业经营的角度看待不确定性,认为单独一个“统计显著”的结论本身“几乎毫无价值”。换句话说,t 分布回答的是小样本下误差界该放宽多少,并不回答结果是否重要、值不值得据此行动。

