
美国得克萨斯州 DISH 镇的空气质量监测设备(2012 年)。摄影:Jeremy Buckingham,来源:Wikimedia Commons,许可:CC BY 2.0。
2026 年 10 月 7 日,Sen 与 Saha 在 arXiv 发布预印本,提出空间数据的“顺序白化”共形预测:让校准集残差也参与预测目标点误差。在模拟和美国 723 个 PM2.5 监测站数据中,它的 90% 区间比现有空间共形方法更窄、更稳定;但精确覆盖依赖协方差设定正确,跨州外推时仍会覆盖不足。
论文背景与空间数据的难点
这篇预印本编号为 arXiv:2610.10168,v1 于 2026 年 10 月 7 日(UTC)提交,主分类为 stat.ML,同时列入 cs.LG、stat.AP 与 stat.ME。第一作者 Ayush Baran Sen 来自印度统计研究所(加尔各答),通讯作者 Arkajyoti Saha 来自加州大学尔湾分校统计系。论文目前未经同行评审;作者在 GitHub 公开了复现全部数值结果的代码,并在致谢中说明曾用生成式 AI 润色文稿和编写实验代码。
分割共形预测(split conformal prediction)的做法是:把数据分成拟合集和校准集,用拟合集训练任意模型,再看模型在 m 个校准点上的绝对残差,取第 ⌈(1−α)(m+1)⌉ 小的那个作为区间半宽。它的保证只要求一个条件:校准点与新目标点的残差“可交换”。打个比方,把目标点的残差混进 m 个校准残差里排队,只要它排在任何名次的机会都相等,它落进前 90% 的概率就至少是 90%,与模型好坏、误差分布形状都无关。
空间数据会动摇这个前提,因为相邻监测站的残差往往同涨同落。位置随机抽样时,可交换性仍然成立,但朴素做法在每个地点给出同样宽的区间,而且相关的校准残差相当于更少的有效样本,阈值波动更大;位置不是随机抽取时,校准残差和目标残差可能根本不可比。论文对照的现有方案来自 Mao 等人(2024):全局空间共形(GSCP)先用拟合集残差做克里金预测,再按预测标准差标准化;局部化版本(LSCP)进一步给靠近目标的校准点更大权重。作者指出,两者都没有利用校准残差本身对目标误差的预测信息,局部化过强时还可能因附近数据不足给出无界区间。
顺序白化的做法与理论保证
直接拿全部校准残差去预测某个校准残差行不通:它会“预测自己”,预测方差变成零,分数失去意义。作者的办法是排队。先固定一个与响应值无关的顺序,每个校准残差只用拟合集残差和排在它前面的校准残差来预测,减去预测值再除以预测标准差;目标点排在最后,用全部拟合与校准残差来预测。论文证明,这一串逐个预测、标准化的操作,等价于用工作协方差矩阵的 Cholesky 因子对整条残差向量做一次三角“白化”。最终区间以模型预测加上空间残差的预测值为中心,半宽等于白化后校准分数的共形分位数乘以目标点的预测标准差。
理论上,论文给出三层结果。在工作协方差正确、残差服从椭圆分布(如多元正态)时,无论站点如何布设,区间都有精确的有限样本覆盖率 ⌈(1−α)(m+1)⌉/(m+1);再加一些条件,区间宽度渐近等于已知真实分布时最短的条件有效区间;协方差设错时,覆盖率偏差有一个基于 KL 散度的上界。作者还定义了“相对预测尺度” κ_rel:约等于 1 时覆盖接近名义水平,小于 1 偏保守,大于 1 则覆盖不足,可以用目标区域内少量留出观测来估计。
实现上,均值模型可以换成任何学习器。文中用随机森林,并用袋外残差避免灵活模型的样本内残差过小;协方差采用带块金效应的指数模型,参数用最近邻高斯过程(NNGP,BRISC 实现)估计。稠密 Cholesky 分解的计算量随样本量立方增长,作者建议大样本改用 NNGP 近似:每行只依赖至多 K 个前序邻居,计算量变为线性。补充材料报告两种实现的结果几乎无差别,结果对排序方式也不敏感。
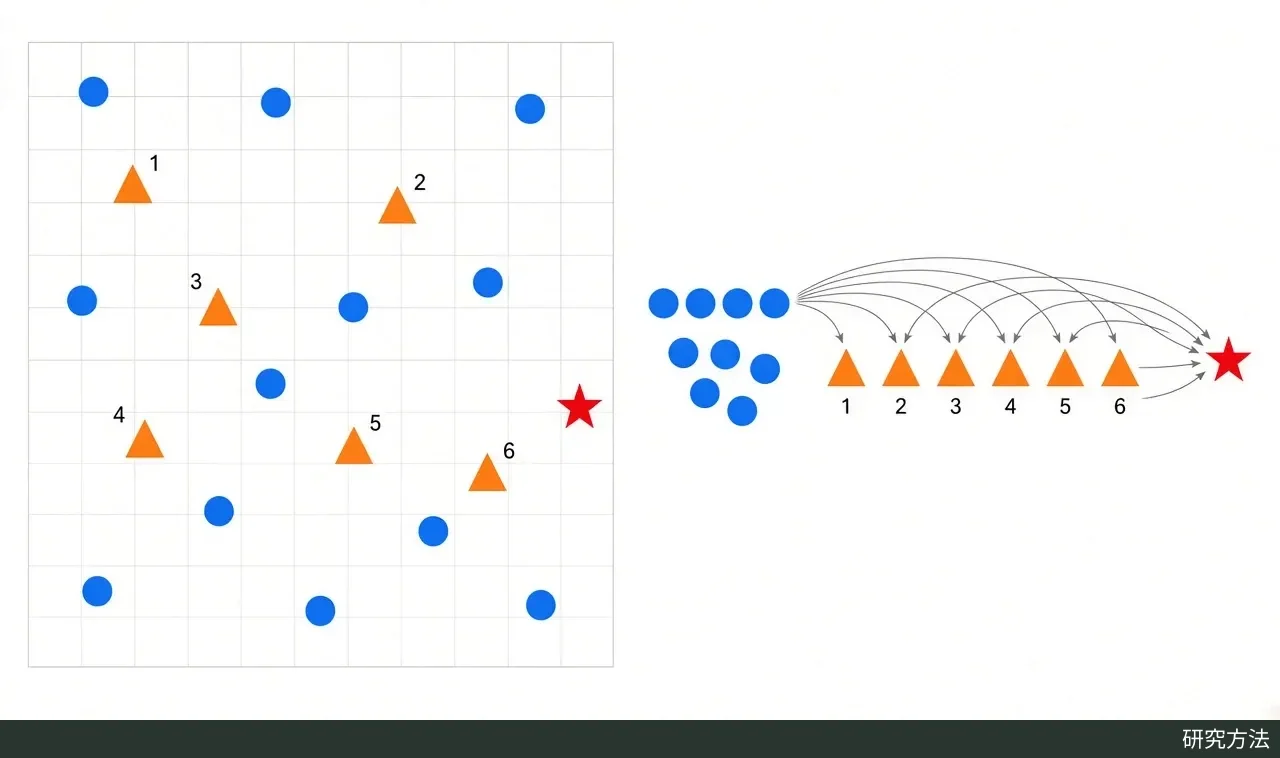
顺序白化示意:左为站点分布,蓝点为拟合站点、橙色三角为校准站点、红星为目标点;右为校准残差按固定编号排队,每个只用排在它前面的残差来预测并标准化,目标点排在最后、使用全部残差。原理依据 Sen 与 Saha(2026)。AI 生成示意图。
与现有方法的对比证据
作者先用一个“双簇”小例子说明问题:100 个有标签点分成相隔很远的两簇,目标点在其中一簇,按名义 90% 重复 20,000 次,并假定均值与协方差已知。当校准点全部落在另一簇(“远处校准”)时,朴素方法覆盖率 0.858、GSCP 0.855,都低于 90%;局部化很强的 LSCP(带宽 h=0.05)在三种划分下都给出无界区间。顺序白化在近处、混合、远处三种划分下覆盖率为 0.900–0.904,平均宽度都是 1.87,宽度变异系数比(CVR,等于 1 表示与独立数据一样稳定)为 1.00–1.01。
正式模拟中,每种设置生成 500 个数据集,每个含 501 个站点(330 个拟合、166 个校准、5 个目标),比较朴素分割共形、GSCP、LSCP(h=0.40)和顺序白化。在随机抽样、随机划分的 9 种设置下,四种方法覆盖率都接近 90%,顺序白化在每种设置中区间都最窄:平均比 GSCP 窄约 4%,比 LSCP 窄约 7%,比朴素方法窄 14%–48%(平均 35%),CVR 也全部最低(仅在 φ=30 的弱相关设置与 GSCP 持平)。当靠近目标的点被分进校准集时,优势更明显:6 种设计中,顺序白化比 GSCP 窄 14.0%–29.3%,收窄幅度与“校准集额外提供的信息量”的相关系数为 0.98。
实际数据是美国环境保护署(EPA)在美国本土 723 个监测站的 2022 年 PM2.5 年均浓度。用环境协变量拟合的随机森林袋外 R² 仅 0.23,残差方差中约 67% 来自空间相关,实际相关距离约 460 千米。作者用两种方式检验:把监测站随机分成 20 折轮流预测,以及把 49 个州级区域逐个整体留出、只用州外数据预测。结果如下表(名义覆盖率 0.90):
| 检验方式 | 朴素分割共形 | GSCP | LSCP | 顺序白化 |
|---|---|---|---|---|
| 随机 20 折 | 0.903 / 5.94 | 0.887 / 5.16 | 0.892 / 5.07 | 0.898 / 4.85 |
| 整州留出 | 0.868 / 5.44 | 0.873 / 5.23 | 0.873 / 5.10 | 0.879 / 5.13 |
每格为覆盖率 / 平均区间宽度(μg/m³);整州留出为 49 个区域等权平均。数据来源:Sen 与 Saha(2026)表 4。
随机分折时,顺序白化比 GSCP、LSCP 和朴素方法分别窄约 6%、4% 和 18%。按“离最近拟合站点的距离”分成五组来看,只有最近的一组里 GSCP 和 LSCP 更窄,但它们在这一组的覆盖率比名义水平低 7–8 个百分点;在最远的一组,GSCP 和 LSCP 的宽度已接近朴素方法,顺序白化仍窄 8%–10%。以上比较均由论文作者完成,尚无独立复现。
假设条件与适用边界
作者承认这并非完全分布无关的方法,而是“模型精简”(model-lean):精确覆盖需要残差服从椭圆分布且工作协方差正确;效率和误设定分析把估计出的协方差当作固定值,没有计入估计误差。换句话说,它把经典共形预测“只要可交换”的前提,换成了“协方差模型基本对”的前提。
协方差不对时,它会和其他依赖工作协方差的方法一起失守。模拟中的“分块留出”设计(校准点附近有拟合点,目标点附近没有)里,四种方法全部覆盖不足,顺序白化为 0.873;“相关距离突变”设计里,平稳协方差抓不住突变,顺序白化为 0.878,反倒是 LSCP 达到 0.902。PM2.5 整州留出时,四种方法覆盖率都只有 0.87–0.88,顺序白化与 LSCP 几乎无差别。
诊断工具能提前提示风险,但不是保证,而且需要目标区域内另有带标签的观测。模拟中额外用了 200 个目标区域观测:在覆盖正常的 4 种设计里,预测覆盖率与实际相差不超过 0.006;在两种失守设计里,误差在 2 个百分点以内。PM2.5 整州留出中,作者只分析了至少有 16 个监测站的 19 个区域,κ_rel 与实际覆盖率的 Spearman 相关为 −0.90;κ_rel 最高的三分之一区域预测覆盖 0.769,实际为 0.744。作者把“基于诊断的校正并给出正式覆盖保证”和“推广到近似及非平稳协方差”列为后续工作。
对使用者来说,这个方法最值得尝试的场景是:点位型空间数据(监测站、采样点),残差有明显空间相关,而且离目标近的观测恰好在校准集里,例如模型已在旧数据上训练好、新观测只能用于校准。目前它只有论文复现代码,没有打包成通用软件,也尚未经过同行评审。