
一幅古典绘画题材的拼图基本拼完,只缺一块。缺块的颜色与图案只能从周围已拼好的部分推断,而且推断总带着不确定性。图:romana klee,来源 Flickr,许可 CC BY-SA 2.0。
遇到缺失数据,删掉不完整的行或填上平均数最省事,却可能让估计产生偏倚、标准误偏小。多重插补(multiple imputation)把每个缺失值依据观测数据随机填补多次,得到 m 份完整数据,分别分析后用 Rubin 规则合并,把缺失带来的不确定性计入结果。它通常以“随机缺失”(MAR)为前提,而这一假设无法单靠数据检验。
缺失数据与三种缺失机制
数据缺失几乎是实证研究的常态。常见的应急办法——用观测值的均值填补、增设“缺失”类别指示变量、把最后一次测量值往后沿用——在一般情况下都不具备统计有效性,可能带来严重偏倚;只填一次的“单一插补”还会把填进去的数当作真实观测,使标准误偏小(Sterne 等,2009)。直接删除不完整个案(完整个案分析)同样有代价:样本变小、精度下降,而当缺失与其他观测变量有关时,估计还可能有偏。不过删除并非总是错的:如果缺失只发生在一次性测量的结局变量上,且与缺失有关的变量都已作为协变量纳入模型,或者预测变量的缺失原因与结局无关,完整个案分析不会因此产生偏倚,这时专门方法的作用主要是挽回精度。
哪种处理合适,取决于数据为什么缺失。Rubin(1976)把缺失机制分为三类,下面沿用 Sterne 等(2009)的血压例子:
- 完全随机缺失(MCAR):缺失概率对所有个案都相同,缺失原因与数据本身无关。例如自动血压计出故障,导致部分读数缺失。
- 随机缺失(MAR):缺失值与观测值之间的系统差异,可以由其他已观测变量解释。例如年轻人更常缺少血压记录,缺失的血压整体偏低,但原因只是年龄,而年龄已被记录。
- 非随机缺失(MNAR):把已观测数据都考虑进去之后,缺失值与观测值之间仍有系统差异。例如高血压患者因头痛更容易错过门诊,缺失与血压本身的高低直接相关。
多数简单补救办法只在 MCAR 这一严格且常常不现实的假设下成立,现代缺失数据方法(包括多重插补)一般从 MAR 出发(van Buuren,2018,第 1.2 节)。难点在于,仅凭观测数据无法区分 MAR 与 MNAR。用 Sterne 等(2009)的话说,“随机缺失”是支撑分析的一个假设,而不是数据自身的属性。
插补、分析与 Rubin 合并规则
多重插补分三步(van Buuren,2018,第 5.1 节)。第一步,依据观测数据为缺失值建立预测分布,从中随机抽取数值填补,重复 m 次,得到 m 份完整数据;抽取时必须注入足够的随机性,以反映缺失值的真值永远无从知晓这一事实(Sterne 等,2009)。第二步,在每份完整数据上分别拟合原本打算使用的分析模型,得到 m 组估计。第三步,用 Rubin 规则把这 m 组结果合并成一个估计及其方差。记第 ℓ 份数据的估计为 、方差为 ,合并公式如下(van Buuren,2018,第 2.3.2 节):
点估计 就是 m 个估计的平均;总方差 由三部分组成: 是插补内方差,即只观测样本而非整个总体带来的常规抽样误差; 是插补间方差,即缺失值本身带来的额外不确定性; 用来修正只做有限次插补造成的模拟误差。van Buuren 指出,最后这一项在 m 较小时尤为关键,漏掉它会使 p 值偏低、置信区间偏窄。比值 可理解为总方差中由缺失数据造成的比例。检验和区间使用 t 分布,自由度要按缺失信息量下调;小样本时通常采用 Barnard 与 Rubin(1999)的校正,保证调整后的自由度不超过完整数据时的自由度。
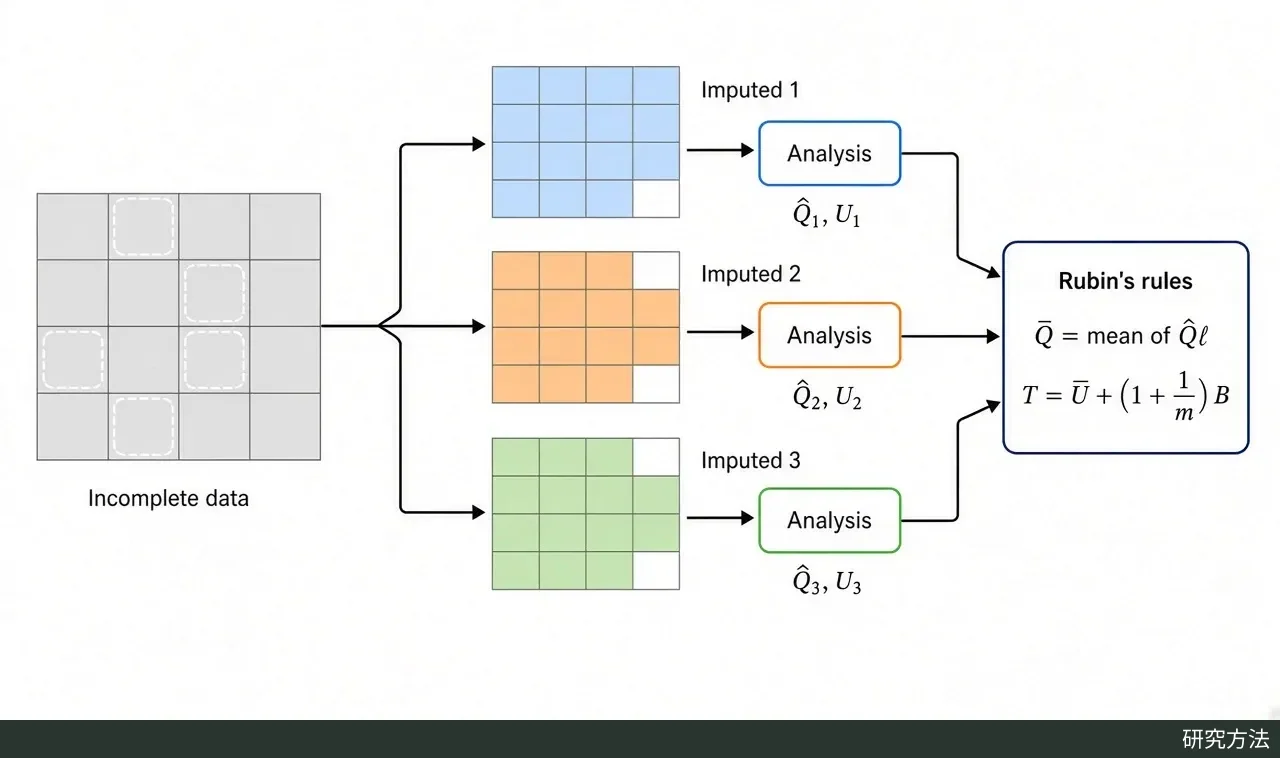
多重插补“插补—分析—合并”三步流程:含缺失值的数据被插补成 m 份(图中示意 3 份)完整数据,每份分别分析得到估计 Q̂ℓ 与方差 Uℓ,再用 Rubin 规则合并为 Q̄ 与总方差 T。流程依据 van Buuren(2018,第 5.1 节)。AI 生成示意图。
插补多少次?传统建议是 3 到 5 次,理由是 m 较小时方差估计的效率损失有限。后来的研究更关注 p 值和置信区间能否稳定复现,结论是 m 往往值得设得更高,常在 20 到 100 之间(van Buuren,2018,第 2.8 节)。White、Royston 与 Wood(2011)采用了 von Hippel 提出的经验法则:插补次数大致等于不完整个案所占的百分比,例如 30% 的个案有缺失就做约 30 次,适用于缺失信息比例不超过 0.5 的情形。实际操作中,可以先用 m = 5 调试插补模型,定稿后再提高 m。
实例:nhanes 数据的合并计算
van Buuren 在《Flexible Imputation of Missing Data》第 2.3.7 节,用 R 包 mice(van Buuren 与 Groothuis-Oudshoorn,2011)自带的 nhanes 数据演示了合并过程。这份数据只有 25 个观测、4 个变量:年龄组 age(1 = 20–39 岁,2 = 40–59 岁,3 = 60 岁及以上)、体质指数 bmi、是否高血压 hyp、血清总胆固醇 chl,其中 bmi、hyp、chl 含缺失值,数据取自 Schafer(1997)。书中插补 10 次,在每份完整数据上拟合 bmi 对 age 的线性回归,再合并结果:
library(mice)
imp <- mice(nhanes, print = FALSE, m = 10, seed = 24415)
fit <- with(imp, lm(bmi ~ age))
est <- pool(fit)
est
书中报告的年龄系数合并结果为:,,,;完整数据自由度为 23,经 Barnard–Rubin 校正后为 15.1;,缺失信息比例为 0.310。可以手算验证规则:,与输出一致。按这些数字推算,合并标准误约为 ;若只用插补内方差,标准误会是 ,置信区间约窄 12%。再取自由度 15.1 的 t 分位数(约 2.13),95% 置信区间约为 −4.4 到 0.2,跨过 0。换句话说,在这份很小的数据里,约五分之一的方差来自缺失本身,忽略这一部分会让结论显得比实际更确定。
这些数字取决于随机种子和软件版本。van Buuren 在第二版序言中说明,书中代码以 mice 3.0 测试,换用新版本不保证精确复现;本文只引用书中输出并据此手算,没有重新运行代码。
使用前提与常见误用
Sterne 等(2009)提醒,多重插补不是按一下按钮就能完成的例行操作,插补模型需要像分析模型一样认真设定。教材和方法论文献反复提到的误用主要有以下几类:
- 把 MAR 当作已被证实。 只有当足以预测缺失的变量都进入插补模型时,MAR 才可能合理。Sterne 等(2009)举例:若社会经济地位较高的人既更常测血压、血压又较低,而插补模型漏掉了社会经济地位,插补就会低估平均收缩压。因此插补模型宜宽,应包括分析模型中的全部变量,以及能预测缺失值或影响缺失过程的辅助变量,即使它们不在分析模型里。
- 插补模型漏掉结局变量。 当缺失出现在预测变量上,结局本身携带着关于缺失值的信息。插补收缩压时若不纳入冠心病结局及随访时间,会虚假地削弱二者的关联。Sterne 等(2009)记录了 QRISK 心血管风险模型的案例:已发表模型中胆固醇与风险看似无关,原因之一正是插补胆固醇时漏掉了心血管病结局;另一个原因是用插补后的总胆固醇和高密度脂蛋白胆固醇再计算比值,产生了极端值;而高密度脂蛋白胆固醇有 70% 缺失,放大了这些问题。
- 把 m 份数据取平均后当作一份完整数据分析。 这样做丢掉了插补间方差,等于退回单一插补:标准误和 p 值普遍偏低,变量间相关被高估。van Buuren(2018,第 5.1.2 节)用 nhanes 演示:平均后的数据中 hyp 与 chl 的相关系数为 0.381,而 5 份插补数据各自相关系数的平均只有 0.299。把多份数据纵向堆叠后直接分析,得到的标准误同样不可信。
- 忽视变量的分布形态。 许多插补程序默认正态分布,用在高度偏态的生化指标上可能填出不合理的极低值甚至负值。可先变换到近似正态再插补,然后变换回原尺度;分类变量和派生变量(比值、交互项)也需要专门处理(Sterne 等,2009)。
- 在 MNAR 下照常使用、不做敏感性分析。 如果抑郁者恰恰因为当天情绪低落而缺席随访,再多的辅助变量也可能无法让 MAR 成立;这时多重插补的偏倚可能和完整个案分析一样大甚至更大,而且无法从数据本身判断偏倚有多大。可行的做法是收集更多关于缺失原因的信息,并在多种 MNAR 假设下做敏感性分析,看结论是否稳健(Sterne 等,2009;van Buuren,2018,第 1.2 节)。
报告环节同样薄弱。Sterne 等检索了 2002–2007 年发表在 NEJM、Lancet、BMJ 和 JAMA 上使用多重插补的论文,纳入统计的 59 篇中只有 22 篇报告了插补次数,5 篇列出了插补模型所用变量,仅 1 篇通过敏感性分析讨论了 MAR 假设是否合理。他们建议至少报告:各变量缺失数量与原因、完整与不完整个案的差异、所用软件与关键设置、插补次数、纳入插补模型的变量,以及与完整个案分析结果的对比;两者差异明显时,应尝试解释原因。