
记录缺东少西,完整病例又寥寥无几,还能怎样估计变量之间的关系?Cho、Kim 与 Berg 于 2026 年 10 月 15 日首次向 arXiv 提交一篇统计方法学预印本,把缺失模式图与分数插补结合起来。它在特定模拟中减少了估计波动,也提醒应用研究者:利用更多残缺记录,仍须付出模型假设的代价。
1
有人漏掉一次随访后又回来,有人只漏问卷甲项,另一些人只漏乙项。这类缺失无法排成从某处开始一路缺下去的顺序,称为非单调缺失。论文原文标注首次提交日期为2026年10月15日,分类包含stat.ME。作者并非重新发明缺失模式图,而是在这一既有框架内提出新的参数化估计程序。
2
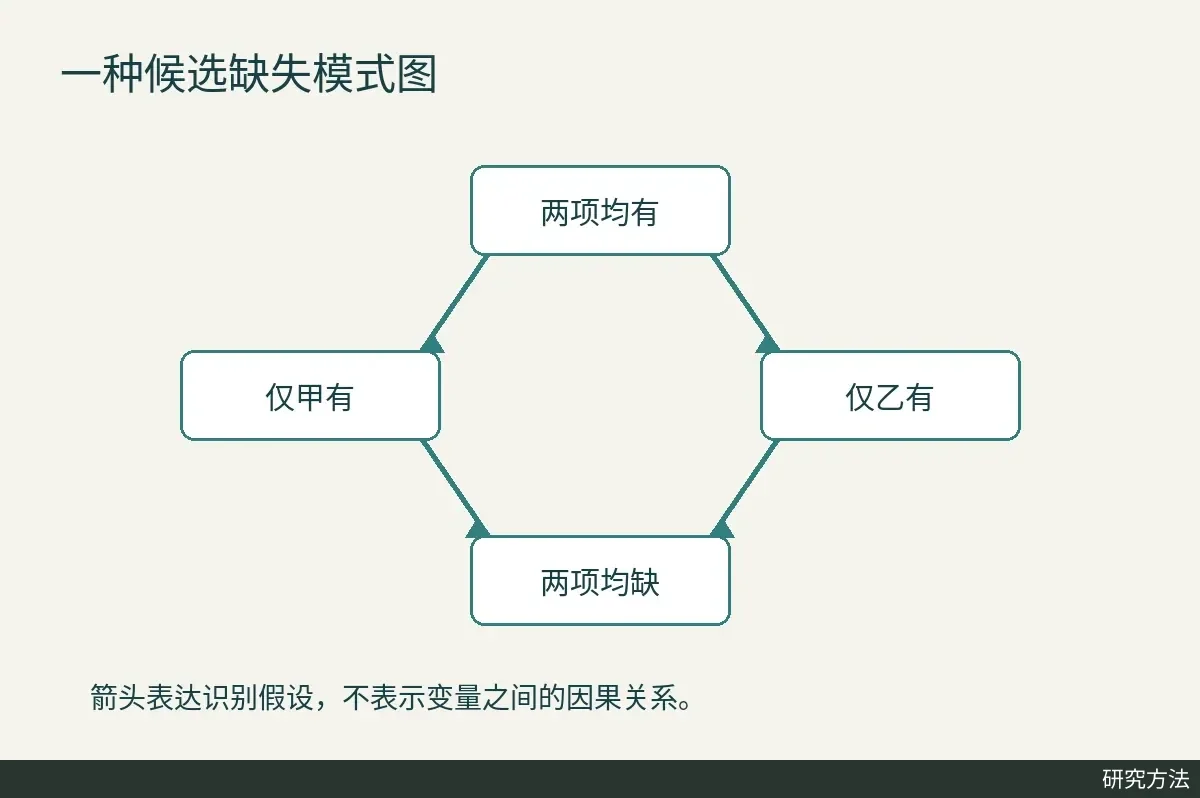
图上的节点代表哪些变量被观察到,箭头把观测较多的模式连向观测较少的模式,表达识别缺失机制所需的限制。新方法先估计模式间的相对概率,再将它与统一的完整数据模型结合,通过EM算法与分数插补估计目标量。缺失位置由多种可能取值及其权重参与计算,不同缺失模式共同提供信息。
3
收益主要见于完整记录稀少的模拟。每组500个观测、重复1,000次,在完整率约4%、变量弱关联的情形,估计三项变量同时为1的概率时,分数插补的RMSE为0.04548,逆概率加权为0.07627;数值已由表2乘以100的展示尺度还原。完整率约32%时,部分目标上的差异很小。
低完整率模拟约6%—7%的生成数据出现分层中没有完整病例的情况。作者重新抽取,只保留各层均有完整病例的重复,因此这些结果以该条件为前提,不能直接代表所有稀疏数据。
4
论文以心肌梗死并发症数据演示关联分析,不构成药物疗效的因果证明。对临床随访、社会调查及生态监测中遇到交错缺失、完整记录又少的研究者,它提供了一条可比较的建模路线。
论文的一致性结论依赖正确指定的图、相对概率模型与结果模型,未声称双重稳健。推断把图视为固定,不涵盖用同一批数据选图的不确定性;合理候选图之间需要敏感性分析。这仍是预印本,本文未独立运行代码。作者提供了模拟与实证分析的R代码。