
安斯库姆四重奏:同一组统计量,四种不同的数据
1973 年 2 月,耶鲁大学统计学家 F. J. 安斯库姆在《美国统计学家》发表短文《统计分析中的图形》,给出四组各含 11 个点的虚构数据。它们的均值、方差、相关系数和回归直线在常规报告精度下完全相同,画出来却分别是直线、曲线、被一个离群点拉偏的直线,以及由单个点决定斜率的竖列。这组“四重奏”至今提醒人们:算完统计量,还要看图。
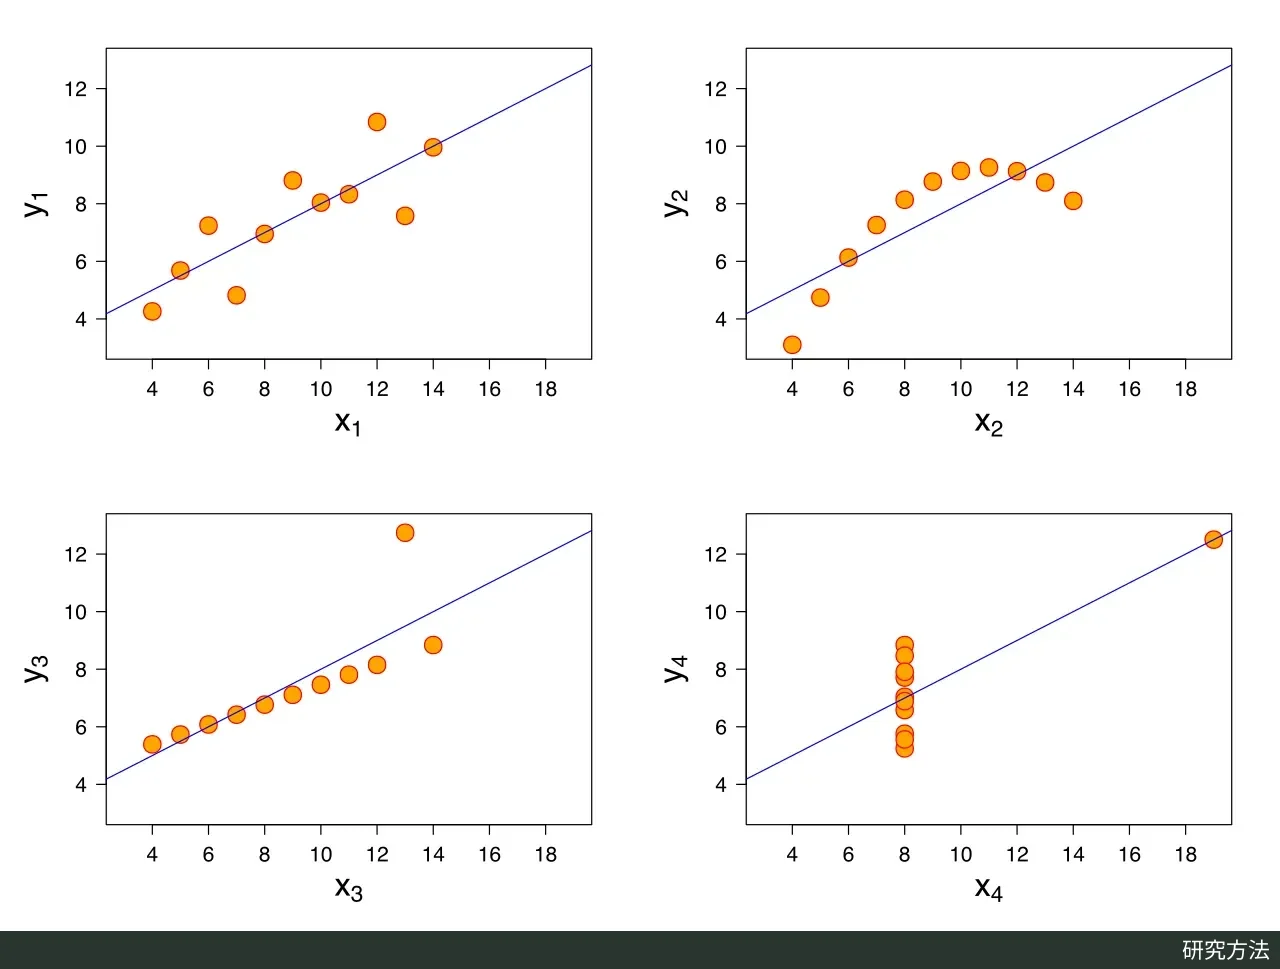
安斯库姆四重奏的四组数据与同一条拟合直线 y = 3 + 0.5x。图:Schutz(原图)、Avenue(下标标注),来源 Wikimedia Commons,许可 CC BY-SA 3.0。
1973 年的一篇短文
1973 年 2 月出版的《美国统计学家》(The American Statistician)第 27 卷第 1 期刊登了一篇 5 页的短文《统计分析中的图形》(Graphs in Statistical Analysis),作者是耶鲁大学统计系的 F. J. 安斯库姆(F. J. Anscombe)。文章开头就批评,多数统计方法教科书和统计计算程序都太不重视图形。他列出三种几乎人人都被灌输过的观念:数值计算是精确的,图形是粗糙的;每类数据只有一套“正确”的计算;做复杂计算是美德,真正去看数据则近乎作弊。
他的主张很直接:计算机既要算数,也要画图,两种输出都应研究,各自都能增进理解。理由在于,多数统计计算建立在关于数据行为的假设之上,假设一旦不成立,结果就可能误导人;图形正是检查假设、看出它错在哪里的有效手段。文末他提到自己习惯在 APL 终端上生成这类图,但当时多数统计程序包诞生于“前可视化时代”,用户想拿到图形,只能靠“麻烦、机巧和斗志”。
为说明这一点,安斯库姆在论文第 3 节构造了四组虚构数据,每组 11 对 (x, y)。前三组共用同一列 x,即 4 到 14 的整数;第四组的 x 除一个点取 19 外,其余全部等于 8。他特意把数据按随机顺序列出,并说即使把回归程序打印的残差从头扫到尾,大概也看不出什么。这组数据后来被称为“安斯库姆四重奏”(Anscombe's quartet),R 语言自带的 datasets 包至今以 anscombe 为名收录。
四组数据与四张散点图
按论文列出的标准回归输出,四组数据的样本量都是 11,x 均值都是 9.0,y 均值都是 7.5,回归方程都是 y = 3 + 0.5x,斜率估计的标准误都是 0.118,R² 都是 0.667。安斯库姆说,第一组的图正是大多数人看到这份摘要时脑海里会浮现的样子:点散布在一条直线两侧,线性模型看起来完全合适,摘要也公正充分。
另外三组各讲了不同的故事。第二组的点沿一条光滑曲线排列,几乎没有残余波动,安斯库姆认为它更像二次关系,直线模型并不合适。第三组有 10 个点几乎落在另一条直线 y = 4 + 0.346x 上,只有 x = 13 处的一个点比这条线高出约 4.2,正是它把标准回归线拉偏;安斯库姆强调,这些才是“需要理解和报告的基本事实”。第四组乍看和第一组一样符合模型,但关于斜率的全部信息都集中在 x = 19 的那一个点上,删掉它,斜率根本无法估计。
第四组的问题最容易被忽视。安斯库姆写道,如果所有观测都真实可靠,第四组和第一组提供的回归信息一样多;可现实中我们很少能确定每个观测都可靠。从第一组任意删去一个点,剩下的数据讲的仍是差不多的故事,第四组却不行。所以他主张,标准回归输出应当附上一条警告:有一个观测起了决定性作用。
摘要统计量记住了什么
四组如此不同的数据为什么能交出同一份成绩单?简单线性回归的全部标准输出,只取决于几项汇总量:样本量 n,x 与 y 的均值,x 的离差平方和 Sxx,y 的离差平方和 Syy,以及两者的交叉乘积和 Sxy。斜率 b₁ = Sxy / Sxx,截距 b₀ = ȳ − b₁x̄,R² = Sxy² / (Sxx·Syy)。论文给出 Sxx = 110、回归平方和 27.50、残差平方和 13.75,据此可以反推:x 的样本方差为 110 / 10 = 11,y 的样本方差为 (27.50 + 13.75) / 10 = 4.125,相关系数为 √0.667 ≈ 0.816。
换个角度数一数:11 个点共有 22 个坐标,而决定上述输出的只是 Σx、Σy、Σx²、Σy²、Σxy 这 5 个和。用 5 个约束去固定 22 个数,剩下的自由足以把点摆成直线、曲线或别的形状。需要说明的是,四组数据的这些量只在论文报告的精度内一致,按原始数值逐位计算,更靠后的小数位仍有细微差别;R 文档对四列 y 的描述也是均值 7.5、标准差 2.03。
安斯库姆在文中点明了其中的前提:如果模型 yᵢ = β₀ + β₁xᵢ + εᵢ 完全正确(误差相互独立,服从均值为零、方差恒定的正态分布),那么 b₀、b₁、残差平方和,连同 n 和 x 的前两阶矩,就是充分统计量,可以替代原始数据而不损失任何信息。问题是我们并不知道模型是否正确,而且通常应当怀疑它不完全正确。均值、方差和相关系数都只是一阶、二阶矩,单看这些数字,无法分辨数据是直线加噪声、一条曲线、一个离群点,还是一个孤立的远点。
第四组可以用杠杆值(leverage)量化。简单回归中第 i 个点的杠杆值为 hᵢ = 1/n + (xᵢ − x̄)² / Sxx,衡量这个点的 x 离中心有多远、对自身拟合值有多大拉力。代入 x = 19:h = 1/11 + (19 − 9)² / 110 = 1/11 + 10/11 = 1。杠杆值等于 1,意味着拟合直线必须穿过这个点,它的残差恒为 0。其余 10 个点的 x 都是 8,只能确定直线在 x = 8 处的高度(它们的 y 均值约为 7.0,正好等于 3 + 0.5 × 8)。所以这个点在残差上看起来“拟合完美”,恰恰是因为斜率由它独自决定。
从阿拉斯加到 Datasaurus
安斯库姆指出,第二到第四组只是把各自的效应推到了极端,较温和的形式在实际分析中很常见。他举了一项当时尚未发表的研究:以美国 50 个州加哥伦比亚特区的人均公立学校教育支出为因变量,对三个预测变量做回归,R² 约为 0.7,残差表现良好;但阿拉斯加的预测变量取值远离其他州,对回归关系贡献很大。直接剔除阿拉斯加并不简单,夏威夷、哥伦比亚特区、加利福尼亚、佛罗里达、纽约、北达科他也各有特殊之处,“到哪里为止?”他的建议是:报告包含全部州的回归,同时说明阿拉斯加贡献很大,并给出删去它之后的结果——回归关系变化不大,但标准误有所增大,R² 降到 0.6 以下。
落到日常分析中,这套做法大致分三步。拟合之前,先画 y 对 x 的散点图,看关系是直线、曲线、无关,还是被少数点主导。拟合之后,画残差对拟合值的散点图,安斯库姆建议两轴用相同刻度,重点找四类迹象:少数特别大的残差,残差随拟合值弯曲,残差波动随拟合值逐渐变化,残差分布偏斜。最后检查结论是否依赖个别观测:删去任意一两个点后关系依然存在,结论才更让人放心。遇到离群值,他建议先核对数值有没有抄错或明显有误;确认真实后,可以把它们单独拿出来研究,再对其余数据拟合,而对离群值的专门研究往往很有收获。
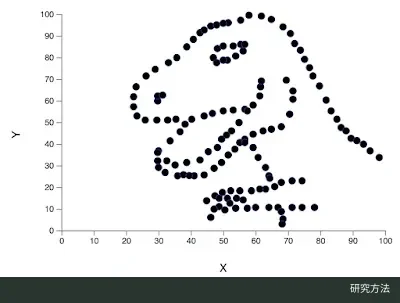
Alberto Cairo 制作的 Datasaurus 数据集散点图。图:Alberto Cairo,来源 Wikimedia Commons,许可 CC0 1.0。
四重奏的思路后来被推得更远。数据可视化学者 Alberto Cairo 制作了一组排成恐龙形状的散点数据 Datasaurus,用来提醒人们“永远不要只相信摘要统计量,一定要把数据画出来”。Autodesk Research 的 Justin Matejka 与 George Fitzmaurice 在 2017 年 CHI 会议论文中以它为起点,用模拟退火反复微调单个点的位置,生成 12 组形状各异的数据,它们与原恐龙图的 x、y 均值、标准差和皮尔逊相关系数在两位小数上保持一致(x 均值 54.26,y 均值 47.83,x 标准差 16.76,y 标准差 26.93,r = 0.06)。他们还展示了分布明显变化、箱线图却始终不变的例子。项目页面也坦言,安斯库姆当年如何构造出这四组数据,至今不得而知。
四重奏并不否定均值、方差和相关系数,它划出的是这些数字的适用范围:它们是在某个模型成立的前提下对数据的压缩。要判断这个前提是否成立,就得先把数据画出来。

