
英国埃塞克斯郡 Gypsy Corner 农场的小麦品种比较试验(2011 年 6 月 8 日摄),木牌标出相邻条带的品种名,非 Onofri 试验现场。摄影:Michael Trolove;来源:Wikimedia Commons(原载 Geograph);许可:CC BY-SA 2.0。

2026 年 10 月 15 日,R-bloggers 转载了意大利佩鲁贾大学 Andrea Onofri 的博文,提醒在区组等设计田间试验中,直接用全部小区数据计算性状相关并做 t 检验并不可靠:小区之间不独立,处理与区组效应会混进系数。该文实为 2019 年旧文重发,方法依据 Bland 与 Altman(1994)和 Piepho(2018)。
旧文重推与方法出处
R-bloggers 页面显示,《Can we trust the correlation coefficient in designed field experiments?》由佩鲁贾大学农业、食品与环境科学系的 Andrea Onofri 于 2026 年 10 月 15 日发布,转自他的博客 Statforbiology;Statforbiology 原页面标注的日期是 10 月 16 日,两处相差一天,页面未说明原因。两个页面末尾都写着“Originally published on 2019-04-30”。在 Statforbiology 的 2019 年存档里,同样的分析以《Dealing with correlation in designed field experiments: part I》为题,日期为 2019 年 4 月 30 日(R-bloggers 当年的转载显示 4 月 29 日)。也就是说,这次不是新方法发布,而是一篇七年前旧文的重新整理和推送。
论点的出处作者在文中交代得很清楚。一是 Bland 与 Altman 1994 年在 BMJ 发表的统计短评《Correlation, regression, and repeated data》,指出把同一对象的重复测量混在一起、当作独立样本计算相关,会制造虚假的显著性;Onofri 说自己只是把这一观点换成了作物科学的例子。二是德国霍恩海姆大学 Hans-Peter Piepho 2018 年发表在 The Journal of Agricultural Science 的论文,用二元混合线性模型在设计试验中估计和检验性状相关。Onofri 随后写过续篇实现 Piepho 的方法:2019 年 5 月用 asreml 包,2025 年 2 月改用免费的 sommer 包和 nlme 包。
直接计算相关的两层问题
Onofri 用的是 statforbiology 包里的 WheatQuality 数据集:27 个冬小麦基因型,随机完全区组设计,3 次重复,共 81 个小区,每个小区都测了产量(Yield)和千粒重(TKW)。把 81 对数据直接交给 Hmisc::rcorr(),得到 r = 0.541,t 检验 P ≈ 1.9×10⁻⁷,看上去是“产量高的小区千粒重也高”的有力证据。作者说这种做法在高水平期刊里也很常见,但结论并不可靠。
第一层问题是检验失效。相关系数的 t 检验要求每一对观测来自相互独立的个体,而这 81 个小区按区组和基因型分组,同一基因型或同一区组内的小区彼此更相似(组内相关)。Bland 和 Altman 用随机数演示过后果:5 个对象各测 5 次,X 与 Y 本无关系;用 5 个对象的均值计算,r = −0.67,P = 0.22;把 25 对观测混在一起,r = −0.47,P 却降到 0.02。计算时被当成有 25 个独立对象,自由度虚增,虚假的显著性由此而来。Onofri 据此认为,凡是设计试验的原始数据,不先扣除全部处理和分组因子的效应,就不能对相关系数做 t 检验。
第二层问题是相关不唯一。打个比方:一所小学全体学生的身高与体重相关,既包含“不同年级之间”的差异,也包含“同年级孩子之间”的个体差异,两者的强弱可以完全不同。田间试验也是如此,小区数据里的协变同时来自基因型效应、区组效应和小区误差。Onofri 按基因型分组计算,27 个组内相关从 −0.999 到 0.985 不等;每组只有 3 对数据,单个估计很不可靠,但足以提示关系可能随基因型而变。按区组分组则稳定在 0.54–0.60。扣除区组和基因型效应后,残差之间的相关只有 0.031(P = 0.78);27 个基因型均值之间的相关为 0.586(P = 0.0013);3 个区组均值之间为 −0.088,数据太少,不宜检验。
这正是误差相关与处理相关的区别。残差(误差)相关回答的是:撇开所属区组和基因型,一个小区产量偏高时,千粒重是否也偏高。基因型均值(处理效应)相关回答的是:高产的品种是不是千粒重也高的品种。本例的答案分别是“基本没有”和“是”。原始数据算出的 0.541 两个问题都没有回答,它主要由基因型之间的差异撑起。Onofri 因此建议,朴素相关系数不要用于解释,解读应集中在残差相关和处理/区组效应的相关上。
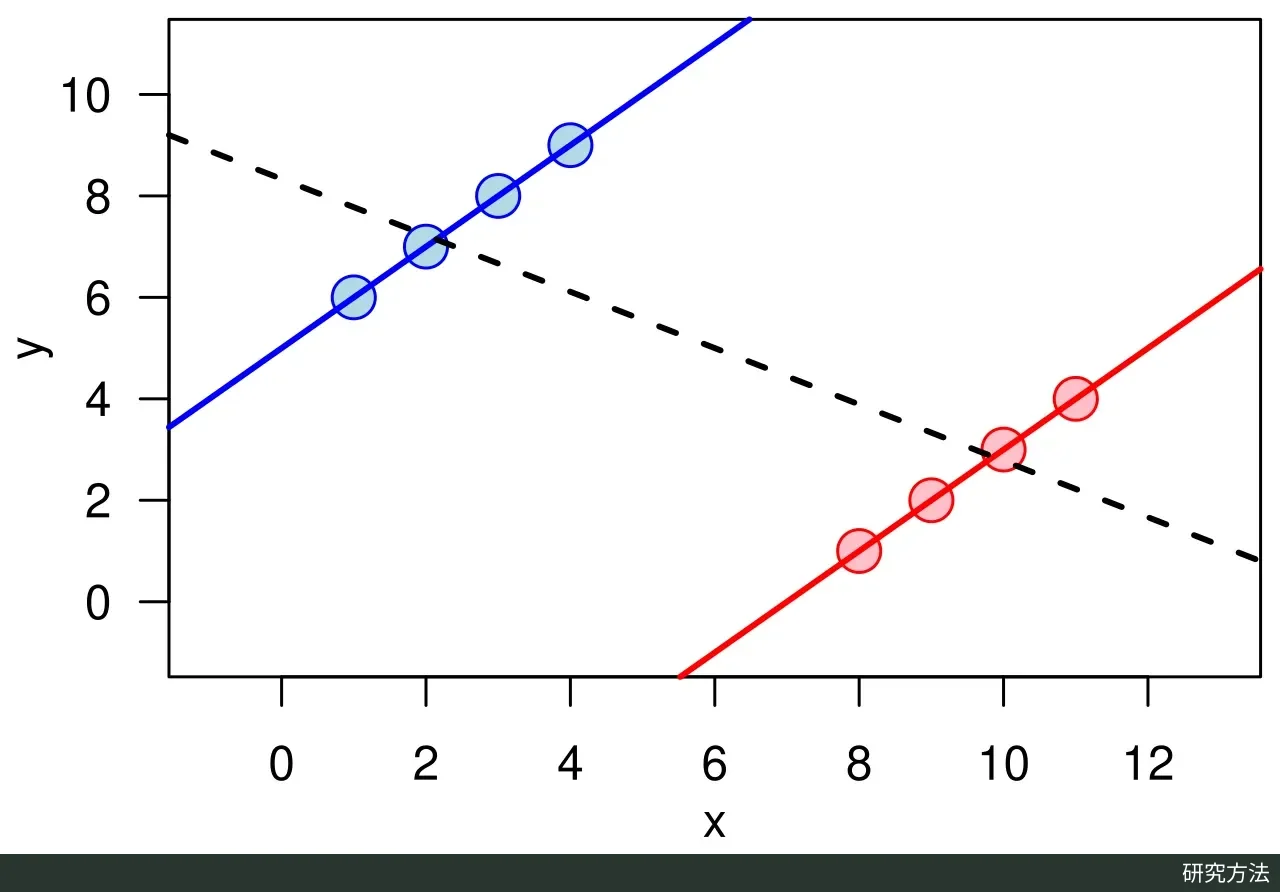
分组数据的相关示意:蓝、红两组内部都呈正相关,合并计算却得到负相关(黑色虚线),说明混合分组数据算出的相关可能与组内相关截然不同。本文小麦例子的偏差方向不同:朴素相关 0.541 主要来自品种间差异,残差相关仅 0.031。图为通用示意,不是 WheatQuality 数据。作者:Schutz;来源:Wikimedia Commons;许可:公有领域。

残差相关、均值相关与二元混合模型
Onofri 给出两套做法。传统做法只用线性模型:先对两个性状分别拟合包含区组和基因型的方差分析模型,再计算两组残差的相关;然后把数据按基因型(或区组)求均值,计算均值之间的相关。据原文整理的核心代码如下:
library(Hmisc)
library(statforbiology)
dataset <- getAgroData("WheatQuality")

# Error (residual) correlation after removing block and genotype effects
mod1 <- lm(Yield ~ factor(Block) + Genotype, data = dataset)
mod2 <- lm(TKW ~ factor(Block) + Genotype, data = dataset)
rcorr(residuals(mod1), residuals(mod2))

# Correlation between genotype means (treatment effects)
means <- aggregate(dataset[, c("TKW", "Yield")], list(dataset$Genotype), mean)
rcorr(as.matrix(means[, 2:3]))
进阶做法来自 Piepho(2018),Onofri 在 2025 年的续篇中把原论文的 SAS PROC MIXED 代码移植到 R。模型写作 Y_ijk = μ_i + β_ik + τ_ij + ε_ijk,其中 i 为性状、j 为基因型、k 为区组。基因型效应和区组效应都设为随机效应,每层各有两个性状专属的方差和一个性状间协方差(非结构化 2×2 矩阵);同一小区两个性状的残差允许方差不等且相互相关。这样一个模型就能同时给出基因型层、区组层和误差层的相关,并可以检验。Piepho 论文摘要强调,这个二元模型要与单性状分析所用的模型相对应。Onofri 用 sommer 包的写法如下:
library(sommer)

# Bivariate mixed model: unstructured 2x2 covariance for genotype and block;
# plot-level residuals of the two traits are heteroscedastic and correlated by default
mod.bimix <- mmer(cbind(Yield, TKW) ~ 1,
                  random = ~ vsr(usr(Genotype)) + vsr(usr(Block)),
                  data = dataset, verbose = FALSE, dateWarning = FALSE)

vpredict(mod.bimix, rg ~ V2 / (sqrt(V1) * sqrt(V3)))  # genotype-level correlation
vpredict(mod.bimix, rb ~ V5 / (sqrt(V4) * sqrt(V6)))  # block-level correlation
vpredict(mod.bimix, re ~ V8 / (sqrt(V7) * sqrt(V9)))  # residual correlation

# Test residual correlation: refit with independent residuals, then LRT
mod.bimix2 <- mmer(cbind(Yield, TKW) ~ 1,
                   random = ~ vsr(usr(Genotype)) + vsr(usr(Block)),
                   rcov = ~ vsr(units, Gtc = diag(2)),
                   data = dataset, verbose = FALSE, dateWarning = FALSE)
anova(mod.bimix, mod.bimix2)
据续篇的输出,基因型层相关为 0.601(标准误 0.131),区组层为 −0.098(标准误 0.757),误差层为 0.031(标准误 0.139),与传统做法的 0.586、−0.088、0.031 很接近。混合模型的好处在于检验更可靠:把残差协方差固定为 0 后,REML 似然比检验 χ² = 0.051(df = 1,P = 0.82);再去掉区组层协方差,P = 0.97;三层协方差全部去掉时 χ² = 10.99(df = 3,P = 0.012)。综合来看,显著的只有基因型均值之间的相关。如果愿意把区组当作固定效应,也可以用 nlme::lme() 把两个性状叠成长格式来拟合,或在 sommer 里写成 mmer(cbind(Yield, TKW) ~ Block, random = ~ vsr(usr(Genotype))),结果相同。
续篇的方差分量还解释了朴素相关为什么会“骗人”。基因型层的方差(产量 77.6、千粒重 53.9)约是误差层(6.09、4.47)的 12 倍,协方差 38.8 对 0.16。把两层相加得到的总体相关为 0.558,与原始数据的 0.541 相近。可见朴素相关大致是各层相关按方差加权的混合,哪一层方差大,结果就像哪一层。Piepho 的建议也由此而来:先用似然比检验或效应估计的散点图判断各层相关是否明显不同;差异大,就只解读效应层面(通常是处理效应)的相关;差异可以忽略,才用二元模型估计一个总的边际相关。
适用边界
- 设计范围:Onofri 的示例只有单点、单季、随机完全区组和两个性状,没有演示裂区、多环境或空间相关设计。按 Piepho“二元模型与单性状模型对应”的原则推论,裂区试验应在模型里保留主区误差层,相关也要分主区层和副区层分别估计;具体写法需查 Piepho 论文的示例。本文只核对了论文摘要,摘要提到四个示例,但没有列出设计类型。
- 样本量:每个基因型内只有 3 对数据,区组均值也只有 3 个,都不宜做检验;混合模型里区组层相关的标准误达 0.757,几乎不含信息。
- 随机还是固定:Piepho 把基因型和区组当作随机效应来估计方差和协方差。Onofri 提醒,在其他应用里基因型更适合作为固定效应,但他没有展开;那时“基因型相关”应理解为所选品种均值之间的相关,不能外推到更大的品种总体。
- 残差检验的自由度(编辑注):rcorr() 按 81 − 2 = 79 的自由度计算残差相关的 P 值,而扣除区组和基因型后的残差自由度只有 52(81 − 1 − 2 − 26),所以 P = 0.78 只是近似值。本例与似然比检验的 P = 0.82 结论一致,但在小样本中两者可能出现分歧。
- 软件版本:sommer 当前 CRAN 版本为 4.4.87(2026 年 10 月 4 日发布),文档推荐用 mmes() 配合 vsm()/usm(),mmer() 仍保留。Onofri 2025 年的代码使用 mmer() + vsr()/usr() 写法,在新版中可能需要改写。本文没有重新运行上述代码,数字均引自原文输出。