
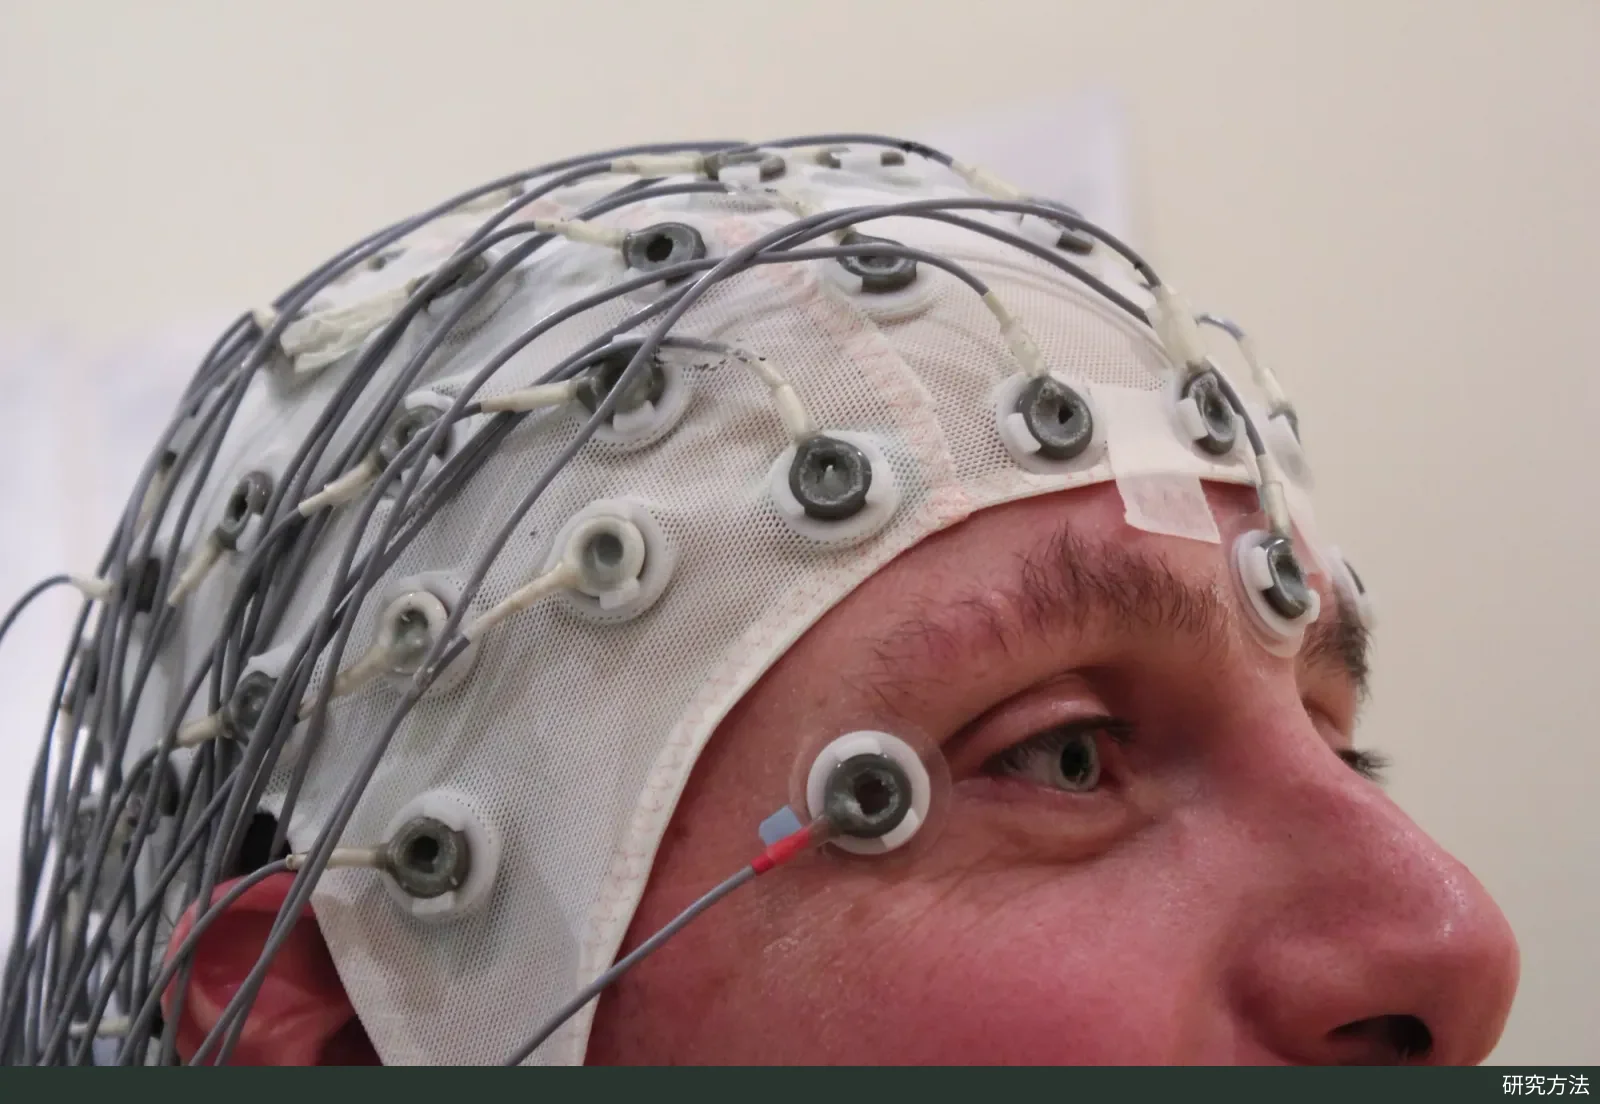
脑电记录帽把电极固定在头皮上,用于采集脑电信号。图:Chris Hope,来源:Wikimedia Commons,许可:CC BY 2.0。

2026 年 10 月 17 日,Towards Data Science 刊出 Renish Joshi 的一项小型复现:在公开脑电数据集 EEGMAT 上,特征和三种分类器都不变,只把“随机切窗口”改成“整个人留作测试”,平衡准确率全线下滑,RBF 核支持向量机从 0.864 跌到 0.602。同一套特征还能以 94.0% 的准确率认出窗口来自 36 人中的哪一位。
一次刻意从简的复现
Joshi 的出发点是脑电(EEG)机器学习里的一个常见操作:把每段记录切成许多短窗口,再把窗口随机分进训练集和测试集。窗口数看上去很多,被试却往往只有几十人。如果同一个人的窗口同时出现在两边,测试检验的就不再是模型能否推广到新的人,而是它能否给“可能见过的人”的窗口分类。他以 Brookshire 等人 2024 年发表在《Frontiers in Neuroscience》上的研究为依据,在尽量简单的设定里重做这一比较:特征提取流程固定,只改评估方式。
数据来自 PhysioNet 上的 EEGMAT(EEG During Mental Arithmetic Tasks,1.0.0 版发布于 2018 年 12 月 17 日,ODC-By 1.0 许可)。据 Zyma 等人 2019 年的数据论文,36 名健康学生志愿者每人有一段静息背景记录和一段连续减法心算记录,采样率 500 Hz,电极按国际 10/20 系统放置。Joshi 取 19 个头皮通道,做 1–40 Hz 带通滤波,切成不重叠的 4 秒窗口,共 2,134 个,其中背景 1,594 个、心算 540 个。每个窗口用 Welch 法估计功率谱,计算 θ、α、β 和低 γ 四个频带的相对功率,19 个通道乘 4 个频带得到 76 维特征。分类器是类别加权的逻辑回归、RBF 核支持向量机和 300 棵树的类别加权随机森林;标准化放在 scikit-learn 流水线内,只在训练数据上拟合。主指标是平衡准确率,另报 ROC-AUC。
记录时长有一处出入:PhysioNet 页面写“所有记录均为 60 秒无伪迹片段”,而 Zyma 等人的数据论文写明静息 180 秒、心算 60 秒。Joshi 采用后者。按 4 秒切窗,心算每人 15 个窗口,36 人正好 540 个;背景窗口约为心算的 3 倍,与他报告的窗口数相符。
按窗口切与按人切
两种协议的差别在于随机化的单位。随机窗口评估以窗口为单位,做 10 次分层的 80/20 随机划分,同一名被试可以同时向训练集和测试集贡献窗口。按被试留出评估用 6 折 GroupKFold,以被试编号分组,每一折的测试被试在训练集中一个窗口都没有。Joshi 特别指出,两者估计的是不同的量:前者衡量允许被试重叠时模型对新窗口的表现,后者衡量模型迁移到完全陌生的人身上的能力。
打个比方:老师从同一批学生的作业里抽一半当练习、一半当考题,阅卷模型考得好,可能只是认得出“这是谁的字迹”;想知道它换了陌生人的作业还能不能判对,就得把某些人的作业整份留作考卷。EEGMAT 里每个人同时有静息和心算两类窗口,看似“人内比较”,身份本身并不直接对应类别;但只要同一人的窗口两边都有,模型就可以针对见过的人分别记住其静息与心算的差异,这种因人而异的分界线到了新的人身上未必成立。
scikit-learn 官方文档把这种情形列为分组交叉验证的典型场景:同一患者有多个样本,数据依赖于个体,应以患者编号作为分组标识;GroupKFold 保证同一组不会同时出现在训练集和测试集中,可以用来发现模型学到了个人特有特征、却推广不到新被试的过拟合。
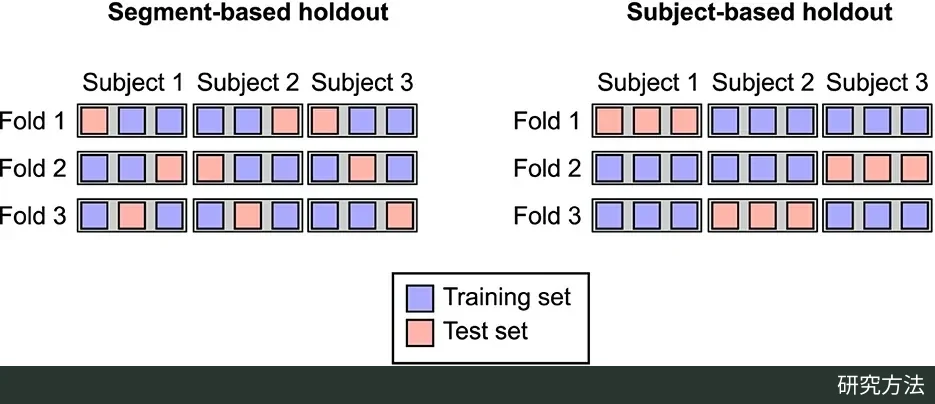
按片段划分与按被试划分的示意:3 名被试、每人 3 段数据、3 折交叉验证,每行为一折,蓝色为训练、红色为测试,灰框圈出同一被试的数据。按片段划分时,同一人的片段可同时进入训练集和测试集;按被试划分时,每人的片段只属于一边。图:Brookshire 等(2024)图 1,来源:Frontiers in Neuroscience,许可:CC BY(据论文版权声明)。
分数落差与认人测试
三种分类器在按被试留出时都变差。平衡准确率方面,逻辑回归从 0.770 降到 0.648,随机森林从 0.664 降到 0.532,RBF 支持向量机从 0.864 降到 0.602,作者报告的绝对差距为 0.263,为三者最大。ROC-AUC 呈同样趋势:逻辑回归从 0.849 降到 0.699,支持向量机从 0.932 降到 0.671,随机森林从 0.909 降到 0.691。Joshi 认为,线性模型、核方法和树集成都出现这一模式,因此很难归结为某一种分类器的特性。
分数下滑本身不说明机制。为检查 76 维谱特征里是否带有个体信息,Joshi 把任务换成“判断窗口来自 36 人中的哪一位”:首个身份分类器的准确率为 95.6%,随机猜测水平只有 2.8%。由于背景窗口约为心算窗口的 3 倍,他又为每人随机抽取 15 个背景窗口和 15 个心算窗口,组成 1,080 个窗口的平衡子集,身份识别准确率仍为 94.0%,约为随机水平的 33.8 倍,前三位命中率 99.5%。他明确说明,这不能证明分类器把身份当作决策规则,只表明这套特征里含有大量个体特有信息,足以让被试重叠时的随机窗口评估偏于乐观。
在同一个 1,080 窗口的平衡子集上重跑三种分类器,随机窗口与按被试留出之间的平衡准确率差距依然存在:逻辑回归 0.120,支持向量机 0.194,随机森林 0.167。因此,类别不平衡不能单独解释这一落差。
平均数还会掩盖个体差异。Joshi 保留按被试分组的逻辑回归在各折外的预测,逐人计算平衡准确率:均值 0.649,中位数 0.644,被试间标准差 0.143;对被试做 10,000 次重抽样,均值的 95% 置信区间为 0.602–0.695。单人数值从 0.289 到 0.956 不等,36 人中有 5 人低于 0.50 的随机水平。
这组数字与 Brookshire 等人 2024 年 5 月 3 日发表的结果方向一致,后者的落差更大。他们原样复现两项已发表的卷积神经网络:在 49 名阿尔茨海默病患者与 49 名主观认知减退者的静息脑电上,按片段划分的测试准确率为 99.8%(99.1%–100.0%),按被试划分降到 53.0%(43.1%–64.8%),区间包含 50% 的随机水平;在 Siena 头皮脑电数据库 14 名癫痫患者的发作检测任务上,准确率从 79.1% 降到 65.1%。他们还以非穷尽检索检视了 63 篇用深度网络和脑电识别疾病的论文,只有 17 篇(27.0%)明确避免了这类泄漏。相比之下,Joshi 换成了传统谱特征和三种经典分类器,并加上身份识别与类别平衡两项对照。
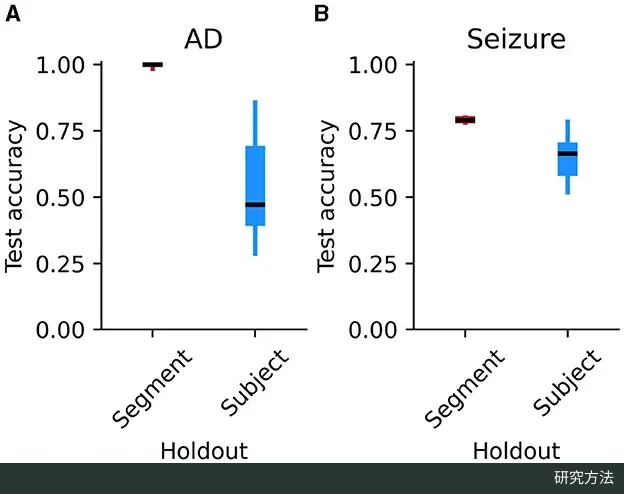
Brookshire 等复现的卷积网络在两种划分下的测试准确率:A 为阿尔茨海默病分类,B 为癫痫发作检测;箱体为四分位距,粗线为中位数,须线延伸到最小值和最大值。图:Brookshire 等(2024)图 2,来源:Frontiers in Neuroscience,许可:CC BY(据论文版权声明)。
结论边界与复现条件
Joshi 对结论的边界写得很克制。身份可预测并不能证明任务分类的落差全部来自身份;分析也无法判断这种个体信号来自稳定的生理差异、电极放置、记录时段特征、残余伪迹,还是几者叠加。两种主协议的重抽样结构不同(10 次随机划分对 6 折分组),两者之差只是描述性比较,不是对泄漏效应的正式因果估计。研究只用了一个 36 人的公开数据集和一套手工谱特征,换成深度网络、连接性特征、原始波形模型、其他任务或更大的数据集,落差可能不同;“静息对心算”的标签也不宜当作认知负荷的通用真值。个体信息集中在哪些通道或频段,他没有分析,列为后续工作。
这也不意味着所有窗口级基准都无效。Joshi 指出,如果研究问题明确是“已见过的被试的新片段”,按窗口划分可以是合适的,比如只服务于已采集过数据的同一批用户的个体化模型。关键规则是让划分与泛化声明一致:要声称模型对新的人有效,这个人的任何数据都不能进入训练;凡是从数据中学习的预处理、特征选择、降维和超参数调优,也要守住同一条被试边界,调参时需在训练被试内部再按人分组。
复现条件方面,Joshi 说明分析用 Python 实现,依赖 MNE、NumPy、pandas、SciPy、matplotlib 和 scikit-learn,重抽样与平衡抽样固定了随机种子,完整脚本“随稿件包提供”。但截至 2026 年 10 月 19 日,TDS 文章页没有给出公开代码链接,本文也未检索到对应仓库,读者暂时无法独立复跑这些数字。Brookshire 等人则在论文补充材料中提供了复现两种网络所需的代码;EEGMAT 数据可在 PhysioNet 公开下载。