
分位数回归由 Koenker 与 Bassett 于 1978 年提出。它分别估计因变量的中位数、第 10 或第 90 百分位等条件分位数如何随自变量变化,而不只估计条件均值。当自变量对分布两端的作用不同,或误差的离散程度随自变量改变时,它能补上普通最小二乘(OLS)看不到的信息。本文介绍其损失函数、系数解读、推断方法与常见误用,并附 Python 算例。
分位数回归的提出者之一 Roger W. Koenker,摄于 2012 年。图:Ivonne Vetter / 奥伯沃尔法赫数学研究所(MFO),来自 Wikimedia Commons,CC BY-SA 2.0 de 许可。

只看条件均值的局限
普通最小二乘(OLS)回归估计的是条件均值:给定自变量取值时,因变量平均是多少。均值只是分布的一个概括。如果自变量不仅移动分布的位置,还改变它的离散程度或偏斜方向,一条均值线就会把这些变化压平。
Koenker 与 Hallock(2001)在《Journal of Economic Perspectives》的综述中,用 1857 年比利时 235 户工人家庭的 Engel 数据说明了这一点:食品支出随收入上升,但收入越高,家庭之间的食品支出差距也越大。statsmodels 官方示例复现这项分析时指出,最小二乘直线对低收入家庭拟合较差,从多数低收入家庭的数据点上方穿过。分位数回归的做法是分别估计中位数、第 10 百分位、第 90 百分位等条件分位数随收入变化的直线,用一组模型描述整个条件分布。
有些问题本来就关心分布的尾部。研究婴儿出生体重时,健康风险集中在低体重一端,需要知道下尾如何随母亲特征变化;研究高管薪酬或收入差距时,关心的常常是上尾。Koenker 与 Hallock 的综述正是以 CEO 薪酬、食品支出和婴儿出生体重为例。另外,中位数回归对因变量方向上的极端值不像均值回归那样敏感,但它对自变量方向上的高杠杆点并不稳健。
检验函数与系数含义
对随机变量 ,第 分位数()是使累积分布函数 的最小 ,记作 ; 就是中位数。线性分位数回归假定条件分位数是自变量的线性函数:
系数通过最小化检验函数(check function)之和来估计:
残差为正(观测点在拟合线上方)时,每单位残差计 ;残差为负时计 。 时两侧权重相等,目标函数等于绝对残差之和的一半,得到中位数回归,也就是最小绝对偏差(LAD)回归。
可以把检验函数想成一套不对称的罚款。取 τ = 0.9:拟合线每把一个观测低估 1 个单位罚 0.9,高估 1 个单位只罚 0.1。为了少交罚款,拟合线会被往上推,直到大约 90% 的观测落在线下、10% 落在线上,这正是第 90 百分位的含义。Koenker 与 Bassett(1978)把样本分位数的这种最小化定义推广到线性模型,称其解为“回归分位数”(regression quantiles)。这个问题没有 OLS 那样的闭式解,通常用线性规划求解。
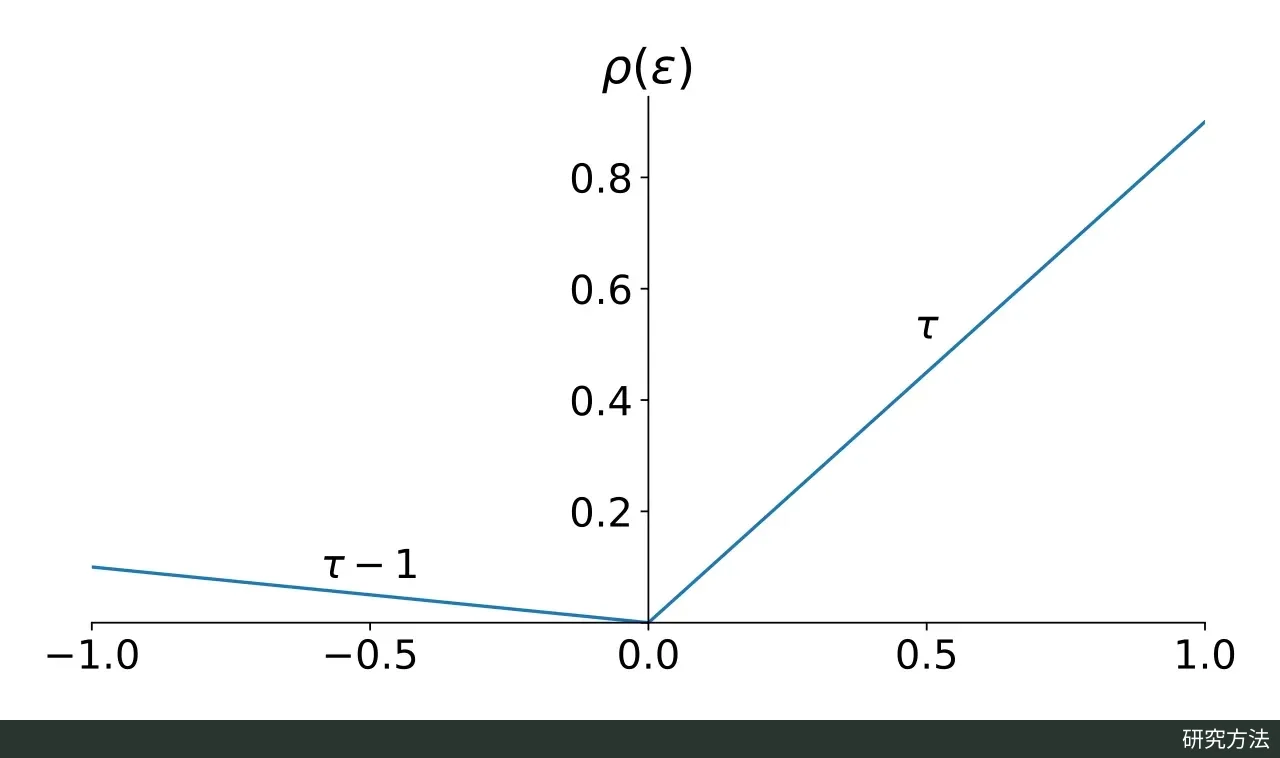
分位数回归所用的 pinball 损失,即正文中的检验函数:零点两侧斜率不同,τ 越大,正残差每单位的代价越高。图:Alexander Elvers,来自 Wikimedia Commons,CC BY-SA 4.0 许可。

系数 的含义是:其他自变量不变时, 增加一个单位, 的条件第 分位数变化多少。读一组分位数回归,重点看斜率怎样随 变化:
- 各个 的斜率几乎相同:自变量只是把整个条件分布平移,分位数回归线大致平行,OLS 斜率已能概括主要信息。
- 高分位数的斜率明显大于低分位数:自变量增大时条件分布被拉宽,即存在异方差。
- 两端斜率偏离中位数的幅度不对称:分布的偏斜方向也随自变量改变。
分位数还有一个均值没有的性质:对单调递增变换保持等变。若 单调递增,则 。因此对 做中位数回归后取指数,得到的就是 的条件中位数;而对 的条件均值取指数,一般并不等于 的条件均值。
Engel 数据算例与 OLS 对比
下面用 Python 的 statsmodels 复现 Koenker 与 Hallock(2001)的 Engel 数据分析。这份数据随 statsmodels 和 R 包 quantreg 一起分发,含 235 户家庭的年收入(income)与年食品支出(foodexp),单位为比利时法郎。代码对 τ = 0.05, 0.15, …, 0.95 共 10 个分位数分别拟合,另拟合中位数回归和 OLS 作对比,并把各条回归线画在同一张散点图上。
import numpy as np
import matplotlib.pyplot as plt
import statsmodels.api as sm
import statsmodels.formula.api as smf

data = sm.datasets.engel.load_pandas().data  # 235 households: income, foodexp

mod = smf.quantreg("foodexp ~ income", data)
taus = np.round(np.arange(0.05, 0.96, 0.10), 2)
fits = {tau: mod.fit(q=tau) for tau in taus}
median = mod.fit(q=0.5)
ols = smf.ols("foodexp ~ income", data).fit()

print(median.summary())
for tau, res in fits.items():
    lo, hi = res.conf_int().loc["income"]
    print(f"tau={tau:.2f}  slope={res.params['income']:.3f}  95% CI=[{lo:.3f}, {hi:.3f}]")
lo, hi = ols.conf_int().loc["income"]
print(f"OLS       slope={ols.params['income']:.3f}  95% CI=[{lo:.3f}, {hi:.3f}]")

x = np.linspace(data.income.min(), data.income.max(), 200)
fig, ax = plt.subplots(figsize=(8, 6))
ax.scatter(data.income, data.foodexp, s=14, alpha=0.3, label="Households")
for tau, res in fits.items():
    ax.plot(x, res.params["Intercept"] + res.params["income"] * x,
            color="grey", linestyle="dotted", linewidth=1)
ax.plot([], [], color="grey", linestyle="dotted", label="tau = 0.05, 0.15, ..., 0.95")
ax.plot(x, median.params["Intercept"] + median.params["income"] * x,
        color="black", linewidth=2, label="Median (tau = 0.5)")
ax.plot(x, ols.params["Intercept"] + ols.params["income"] * x,
        color="red", linewidth=2, label="OLS (conditional mean)")
ax.set_xlim(240, 3000)
ax.set_ylim(240, 2000)
ax.set_xlabel("Household income (Belgian francs)")
ax.set_ylabel("Food expenditure (Belgian francs)")
ax.legend()
fig.savefig("engel_quantile_lines.png", dpi=200, bbox_inches="tight")
用 R 的 quantreg 可以得到同类结果。quantreg 默认用单纯形法(br)求解,statsmodels 用迭代加权最小二乘,个别分位数的点估计可能有细微差别:
library(quantreg)
data(engel)
fit <- rq(foodexp ~ income, tau = seq(0.05, 0.95, by = 0.1), data = engel)
set.seed(2026)
summary(fit, se = "boot", bsmethod = "xy", R = 1000)
plot(summary(fit))
下表摘自 statsmodels 0.15.0 官方示例页面的输出(不是本文另行运行的结果;不同版本或求解算法可能在末位略有差别)。置信区间来自 statsmodels 默认的核估计标准误。
| 模型 | 收入斜率 | 95% 置信区间 |
|---|---|---|
| τ = 0.05 | 0.343 | 0.269–0.418 |
| τ = 0.25 | 0.474 | 0.440–0.508 |
| τ = 0.50(中位数) | 0.560 | 0.534–0.586 |
| τ = 0.75 | 0.644 | 0.622–0.666 |
| τ = 0.95 | 0.709 | 0.688–0.730 |
| OLS(均值) | 0.485 | 0.457–0.513 |
这些斜率的读法是:在收入相同的家庭中,食品支出的条件第 95 百分位随收入每多 1 法郎上升约 0.71 法郎,条件第 5 百分位只上升约 0.34 法郎。斜率随 τ 增大,说明收入越高,家庭之间食品支出的差距越大,这与散点图中向右张开的扇形一致。OLS 的 0.485 落在中间,单独报告它会掩盖这种差异;statsmodels 示例也指出,多数分位数的点估计落在 OLS 的置信区间之外。中位数回归的截距约为 81.5,对应收入为 0 的家庭,远在数据范围之外,不宜单独解读。
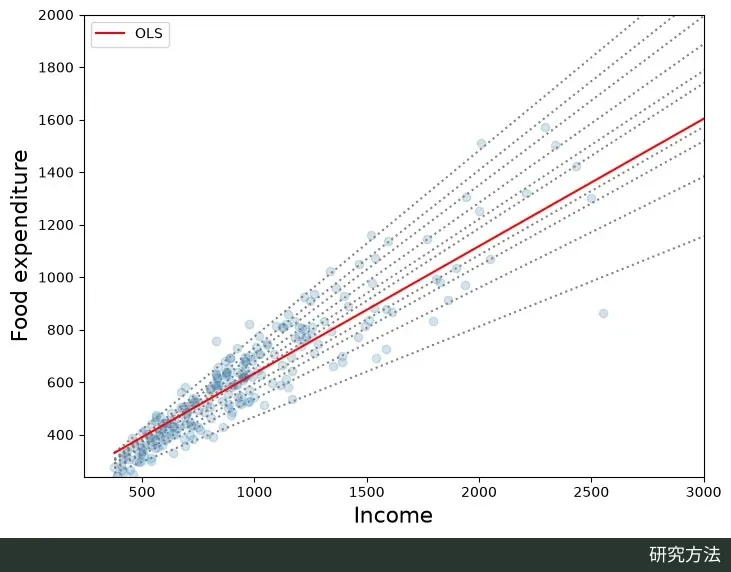
Engel 数据(235 户比利时工人家庭)上的分位数回归:灰色虚线为 τ = 0.05, 0.15, …, 0.95 的拟合线,红线为 OLS。此图取自 statsmodels 官方示例,未单独画中位数线;运行正文代码会另外画出黑色中位数线。图:statsmodels developers,来自 statsmodels 文档,BSD-3-Clause 许可。
标准误、推断与常见误用
分位数回归系数的渐近方差取决于因变量在该分位数处的条件密度,而这个密度本身需要估计,所以标准误没有 OLS 那样简单的公式。R 包 quantreg 的 summary.rq 提供多种方法:iid 假定误差独立同分布,沿用 Koenker 与 Bassett(1978)的渐近协方差;nid 允许误差分布随自变量变化,用局部密度估计构造 Huber 三明治协方差;ker 使用 Powell(1991)的核估计;rank 通过反转秩检验构造置信区间(Koenker 1994),区间可以不对称;boot 提供多种自助法。不指定方法时,样本量小于 1001 默认用 rank,否则用 nid。statsmodels 的 QuantReg 则按 Greene(2008)的做法,用核估计计算渐近协方差。
自助法在分位数回归中很常用,因为它绕开了密度估计。quantreg 的 boot.rq 支持 xy 配对重抽样(按整行有放回抽样)、Parzen–Wei–Ying 法、马尔可夫链边际自助法(mcmb)、指数权重的广义自助法(wxy)和野自助法(wild);提供 cluster 参数时改用 Hagemann(2017)的聚类稳健自助法。实务上,怀疑存在异方差时不要用 iid;数据有学校、医院等聚类结构时,应在聚类层面重抽样。如果要检验“高分位与低分位的斜率是否相同”,需要对多个 τ 做联合推断,不能只看两条置信区间是否重叠。summary.rqs 对多个 τ 使用同一批重抽样,其返回的自助法估计矩阵可用来构造跨分位数的联合协方差。
常见误用之一,是把条件分位数的变化当成个体效应。在 Engel 例子里,τ = 0.95 的斜率约 0.71,说的是“第 95 百分位这个位置”随收入怎样移动,而不是“原本处在第 95 百分位的那户家庭”会怎样变化。打个比方:一个补习项目让全班成绩的第 90 百分位提高了 10 分,可能是原来的尖子生都进步了,也可能是中等生大幅进步、挤进前列,而原来的尖子生原地不动。两种情形下分位数的变化完全一样,个人层面的效应却截然不同。要把分位数差异解释为个体效应,需要额外假设每个人在分布中的排序不因处理而改变(秩不变性),而这在横截面数据中通常无法检验。还要注意,条件分位数不等于总体的无条件分位数:放入的控制变量不同,“第 90 百分位”所比较的人群也不同。
常见误用之二,是忽视分位数交叉。各个 τ 的回归线分别估计,在有限样本中可能在某些自变量取值处相交,例如预测的第 90 百分位低于第 80 百分位,这在逻辑上不可能。交叉多出现在数据稀少的自变量边缘,也可能提示线性设定不当。quantreg 文档提示,相邻分位数面交叉会让 nid 方法的密度估计出现负值,此时宜改用自助法,或考虑加入二次项等非线性项。处理办法包括:只在数据充分覆盖的区间内解读和预测;改进模型设定;或采用 Chernozhukov、Fernández-Val 与 Galichon(2010)提出的单调重排(rearrangement),把每个自变量取值处估计出的分位数按大小重新排序。他们证明,重排后的曲线在有限样本中比原曲线更接近真实的分位数曲线。
第三个容易出错的地方是极端分位数。样本只有几百个时,τ = 0.99 以上的拟合线只由极少数观测决定,常规标准误并不可靠。quantreg 的 summary.rq 为此提供 extreme 选项,采用 Chernozhukov、Fernández-Val 与 Kaji(2018)针对极端分位数的子抽样推断;更稳妥的做法是先确认尾部有足够观测,再决定报告到哪个分位数。