
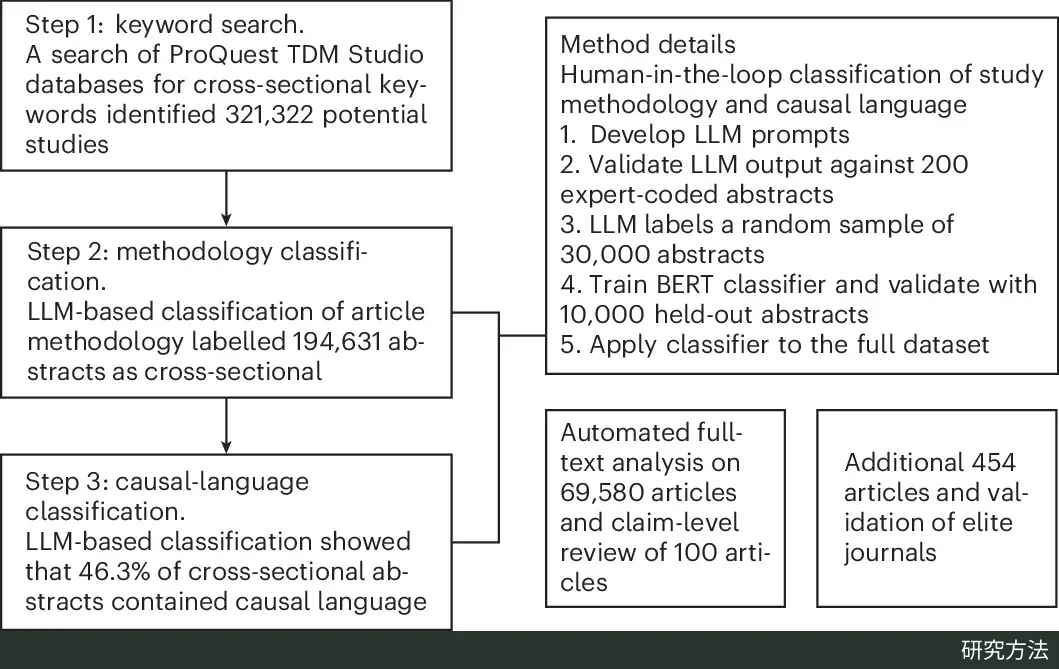
研究流程:检索横断面研究并识别标题与摘要中的因果措辞。图源:Isch et al. (2026), Nature Human Behaviour, Fig. 1,CC BY 4.0。
横断面研究只在一个时间点测量变量,能揭示相关,却难以单独支撑因果结论。宾夕法尼亚大学 Calvin Isch 等人 2026 年 8 月在《自然·人类行为》(Nature Human Behaviour)发表研究,用大语言模型筛查 194,631 篇社会科学横断面论文,发现 46.3% 在标题或摘要里使用了因果措辞,年度比例从 2000 年前后的约 20% 升至 2024 年的六成以上。
论文来源与判定标准
这条线索来自 LSE Impact Blog 2026 年 10 月 20 日的文章《Causal overclaiming is common, rising over time, and difficult to avoid》,作者是论文第一作者 Calvin Isch,属于作者本人对研究的介绍和评论。原始论文为 Isch、Timothy Dörr、Neil Fasching、Grace Jennings 和 Duncan J. Watts 合著的《Quantifying the prevalence and impact of overreaching causal claims in social science》,2025 年 8 月 26 日投稿,2026 年 7 月 16 日接收,2026 年 8 月 24 日在线发表,开放获取;五位作者均来自宾夕法尼亚大学。下文数字均出自论文,博客里的观点和建议会单独注明。
样本来自 ProQuest 文本挖掘平台 TDM Studio 中的五个社科数据库:ABI/INFORM Global、Worldwide Political Science Abstracts、International Bibliography of the Social Sciences、PAIS Index 和 Sociological Abstracts。作者在摘要中检索 cross-sectional、survey、questionnaire、observational study 等关键词,得到 672,944 篇;只保留标注为学术期刊的文章并去掉重复标题后剩 321,322 篇。随后用分类器判定研究设计,只保留单一时间点、没有纵向成分、没有实验或准实验设计的研究。工具变量、断点回归这类有明确识别策略的方法也被排除。最终样本为 194,631 篇,发表时间跨度为 1980–2024 年。
判定逻辑并不复杂:横断面设计无法确定变量的先后顺序,又没有随机分配,容易受混杂和反向因果影响,所以只要标题或摘要就本文的新实证结果作出因果主张,就记为“越界”(overreaching)。引用前人研究、交代背景时的因果说法不算;把相关结果表述为“与某一因果理论一致”也不算。因果措辞分三类:直接主张,例如“我们表明社交媒体导致青少年抑郁症状增加”;隐含主张,例如声称研究的是社交媒体“在塑造抑郁结局中的作用”,或不加限定地据结果建议干预;条件式主张,例如“社交媒体可能促成抑郁症状”。条件式措辞本身说得过去,但作者认为它同样可能让读者过度推断因果,所以主分析只看摘要中是否出现任意一类。
分类分三步。专家编码人先给样本打标签,“有无因果措辞”这一二分类的编码一致性为 Krippendorff's α = 0.86。随后让 GPT-4o 按同一标准判断,在约 200 篇的人工验证集上 F1 为 0.81,精确率 0.91,召回率 0.74。再用 GPT-4o 标注的 30,000 篇训练 BERT 分类器,在留出的 6,027 篇横断面文章上 F1 为 0.83,最后部署到全部文章。作者指出,召回率低于精确率意味着模型更容易漏掉因果措辞,因此比例估计偏保守;用关键词检索和另一个已有的因果语言模型复核,得到的比例更高。
比例、趋势与期刊差异
在 1980–2024 年的全部样本中,46.3% 的标题或摘要被判为含因果主张。年度比例在 1980–2000 年大致稳定在 20%,此后快速上升,2024 年超过 60%。近年论文数量多,合并比例因此更受近年拉动。五个学科都在上升,2024 年商科最高(84%),社会学最低(46%),经济学、心理学和政治学分别为 67%、55% 和 53%。补充材料还拿一批实验和准实验研究作对照:它们使用因果措辞的比例更高,但与横断面研究的差距在逐年缩小。
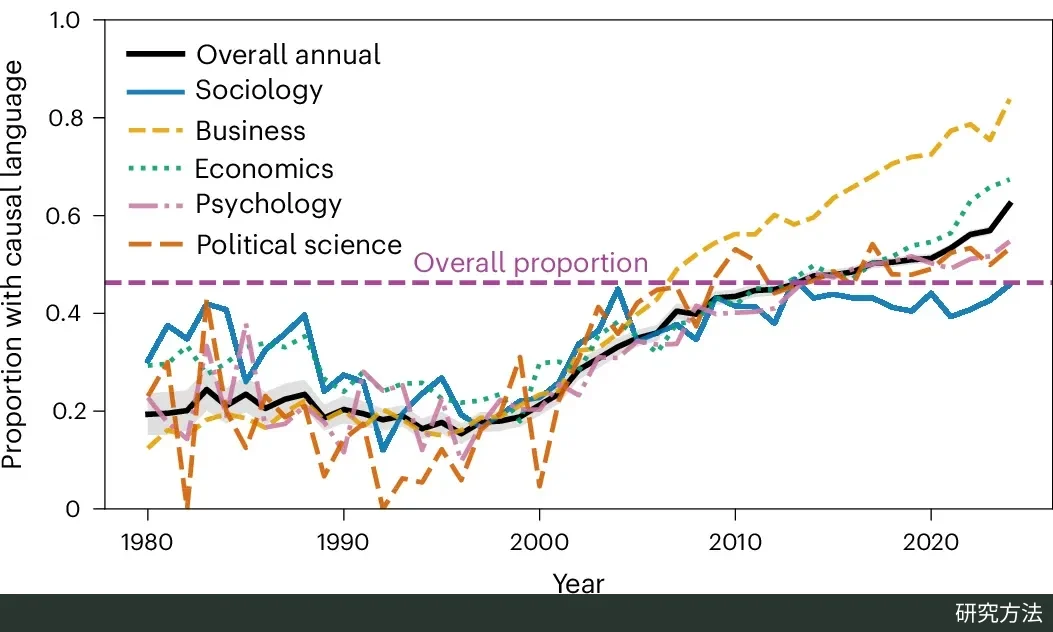
横断面文章中含因果措辞的年度比例,黑线为总体,彩色线为各学科,虚线为 46.3% 的合并比例。图源:Isch et al. (2026), Nature Human Behaviour, Fig. 2,CC BY 4.0。
期刊档次越高,措辞并没有越克制。在能匹配 SCImago 期刊指标的 127,598 篇中,影响因子越高的期刊因果措辞越常见(期刊层面 Pearson r = 0.22):影响因子在中位数 3.03 以上的期刊为 54.4%,以下为 43.3%。按类型拆分,增加的主要是直接和隐含主张,而不是更谨慎的条件式表述。作者另选经济学、政治学、社会学和综合科学各 5 本顶刊,经人工核验后比例为 43.2%,略低于总体,但仍接近一半。明确不鼓励因果表述的《Journal of Quantitative Description: Digital Media》为 12.9%,明显较低,但并非为零。
摘要克制,不代表正文克制。在 69,580 篇能取得全文的文章中,81.8% 至少有一个因果片段(已排除带文献引用的片段)。作者又从四类摘要中各抽 25 篇,把全文里与摘要结论对应的句子逐一匹配:其中 73.0% 是相关或描述性表述,但即使摘要只做描述,仍有 44% 的文章在正文里至少出现一次不加限定的因果陈述,主要集中在引言和讨论部分,方法部分很少出现。
措辞对读者和大模型的影响
为检验措辞的影响,作者做了一项预注册实验(AsPredicted #238174)。1,105 名至少有学士学位的美国成年人经 Prolific 招募,随机阅读 28 篇顶刊横断面摘要中的一篇,分为四种条件:原文(含因果措辞);只把因果措辞改成相关措辞的改写版;原文加一条方法说明,指出研究为横断面设计、本身不能确立因果;方法说明再加“AI 反馈”高亮。这些反馈实际由研究者统一手写,只是告知被试为 AI 生成。另设一个不读摘要的对照组。
三种干预都降低了被试对“该研究提供了因果证据”的认同:方法说明的标准化系数为 β = −0.4(95% CI −0.56 至 −0.19),改写为 β = −0.3(95% CI −0.43 至 −0.07)。但各组被试仍普遍读出因果。让他们用自己的话总结时,含因果措辞的比例在原文组为 71.3%,改写组 49.6%,方法说明组 64.2%,AI 反馈组 59.4%。换成间接问题,即询问“假如改变自变量会怎样”时,各条件之间没有显著差异。
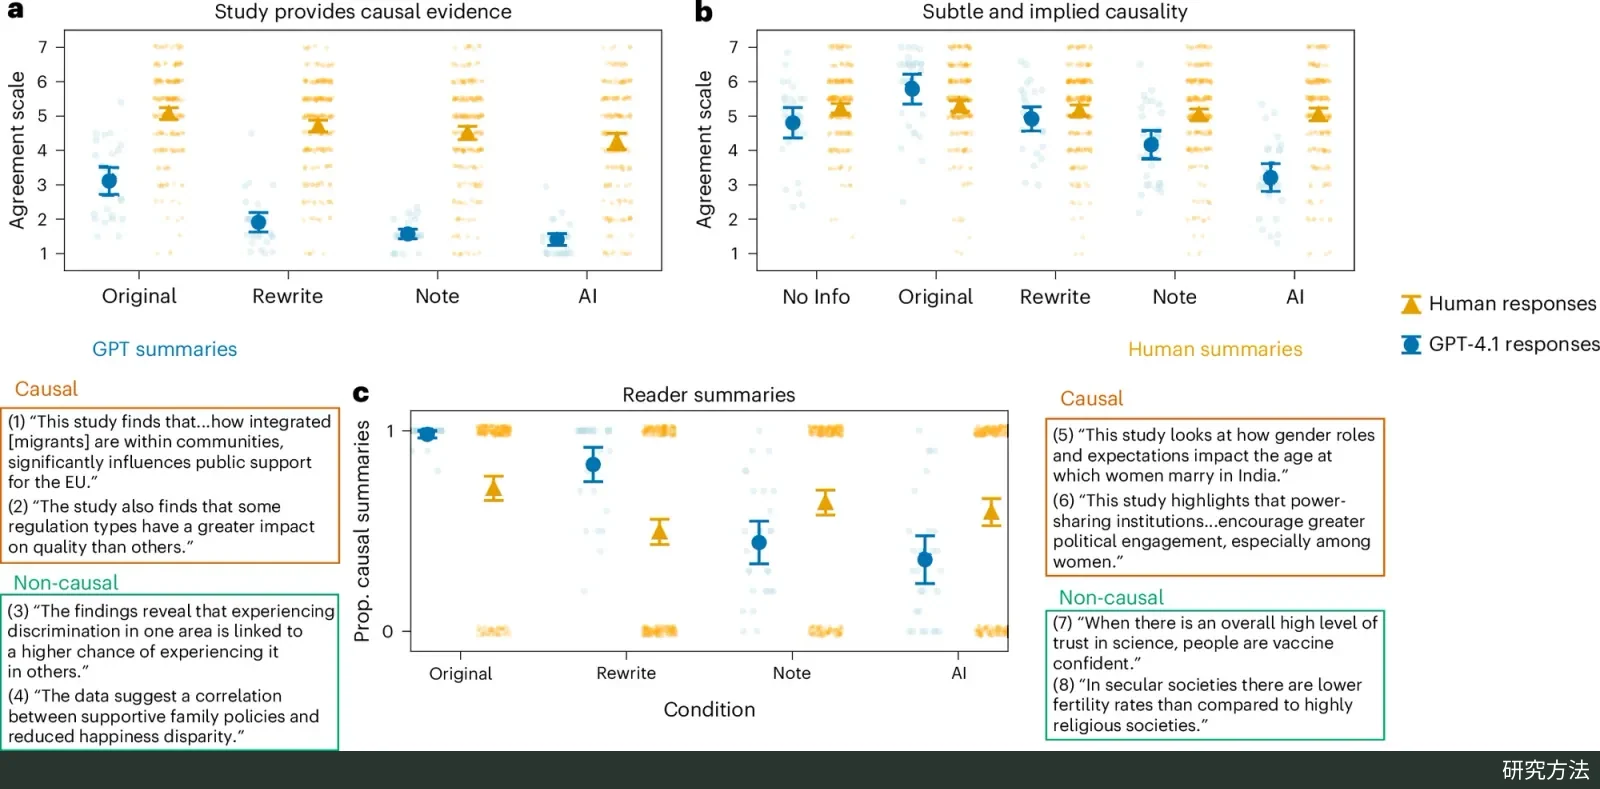
原文、改写、方法说明和 AI 反馈四种条件下,人类被试(橙色)与 GPT-4.1(蓝色)的因果判断和摘要措辞。图源:Isch et al. (2026), Nature Human Behaviour, Fig. 5,CC BY 4.0。
大模型同样会放大因果。同样的材料交给 GPT-4.1,基于原文写出的总结有 99.3% 含因果措辞;改写、方法说明、AI 反馈三种条件下分别降至 89.8%、41.7% 和 30.3%。第二项实验让 GPT-4.1、GPT-5.1、GPT-5.4、DeepSeek Chat-V3.2 和 Claude Sonnet 4.6 各总结 100 篇文章,并比较四种提示词。要求“用通俗的话”或“强调实际意义”时,所有模型的总结都比原摘要更常出现不加限定的因果表述。要求“谨慎、关注方法局限”时,除 GPT-4.1 外的模型都比原摘要更克制。这些实验没有预注册,只覆盖少数模型和提示词;作者也注意到,在基本提示下 GPT-5.4 已不再出现 GPT-4.1 那样的放大。
原因推测、局限与写作建议
论文明确说没有检验原因,只提出几种可能相互强化的推测:招聘和晋升看重发表数量与期刊等级;高选择性期刊偏好“新颖”“重要”的发现;资助方越来越强调“影响力”;可疑研究实践在社科中仍然普遍;人们本来就倾向于从相关推断因果,研究者也不例外。高影响因子期刊因果措辞更多,与这些推测相符,但不能当作证据。作者还特意指出,JQD 因果措辞较少,这一发现本身也是相关性的,可能只是因为谨慎的作者和编辑更愿意选择这本期刊。
研究的局限同样清楚。第一,它只覆盖横断面设计,19 万篇只是社科文献的一小部分,不能据此推断整个社科领域的情况。第二,它把横断面研究中所有针对新结果的因果主张都算作越界,而有些相关确实反映因果;作者举了 Ronald Fisher 怀疑吸烟与肺癌关联的例子,提醒过度怀疑同样有代价。第三,实验被试是受过大学教育的普通读者,而不是职业研究者,而且只读了标题和摘要。第四,分类器以 GPT-4o 的标签为训练目标,人工验证集约 200 篇。
在 10 月 20 日的博客里,Isch 用 1995 年匹兹堡银行劫匪以为脸上抹柠檬汁就能躲过监控的故事开头,提出“叙事许可”(narrative license)一词,指故事和实践建议超出证据所能支持的范围。他认为这不是学术不端,而是人们对简单故事的偏好与追求影响力的激励相互叠加的结果。博客中的建议比论文更具体:期刊应写明哪些设计可以支持因果主张、哪些词带有因果含义,例如横断面研究避免使用 affects、leads to、improves;为每篇研究附上说明设计和局限的简短方法注释;在投稿环节用自动分类器标记越界表述,提醒作者和审稿人复查。论文中的对应表述更为概括:期刊给出措辞规范并切实执行,同时可借助大语言模型工具标记越界表述。
根据论文的分类标准,写作者和读者可以对照以下几点检查。写作时,先确定研究设计能支持多强的结论;横断面结果用“与……相关”“存在关联”描述,避免“影响”“导致”“提升”;“探讨某因素的作用”、未加限定的干预建议同样隐含因果。论文发现,摘要谨慎、引言和讨论放开的情况很常见,因此全文措辞要保持一致;如果确实认为因果解释合理,应写明依赖的假设和其他证据。阅读时,先看设计:数据是否来自单一时间点,有没有随机分配或明确的识别策略,再看动词。用大模型总结文献时,要求它写明研究设计和局限,少用“说得通俗些”这类提示,因为论文显示后者会增加因果表述。