
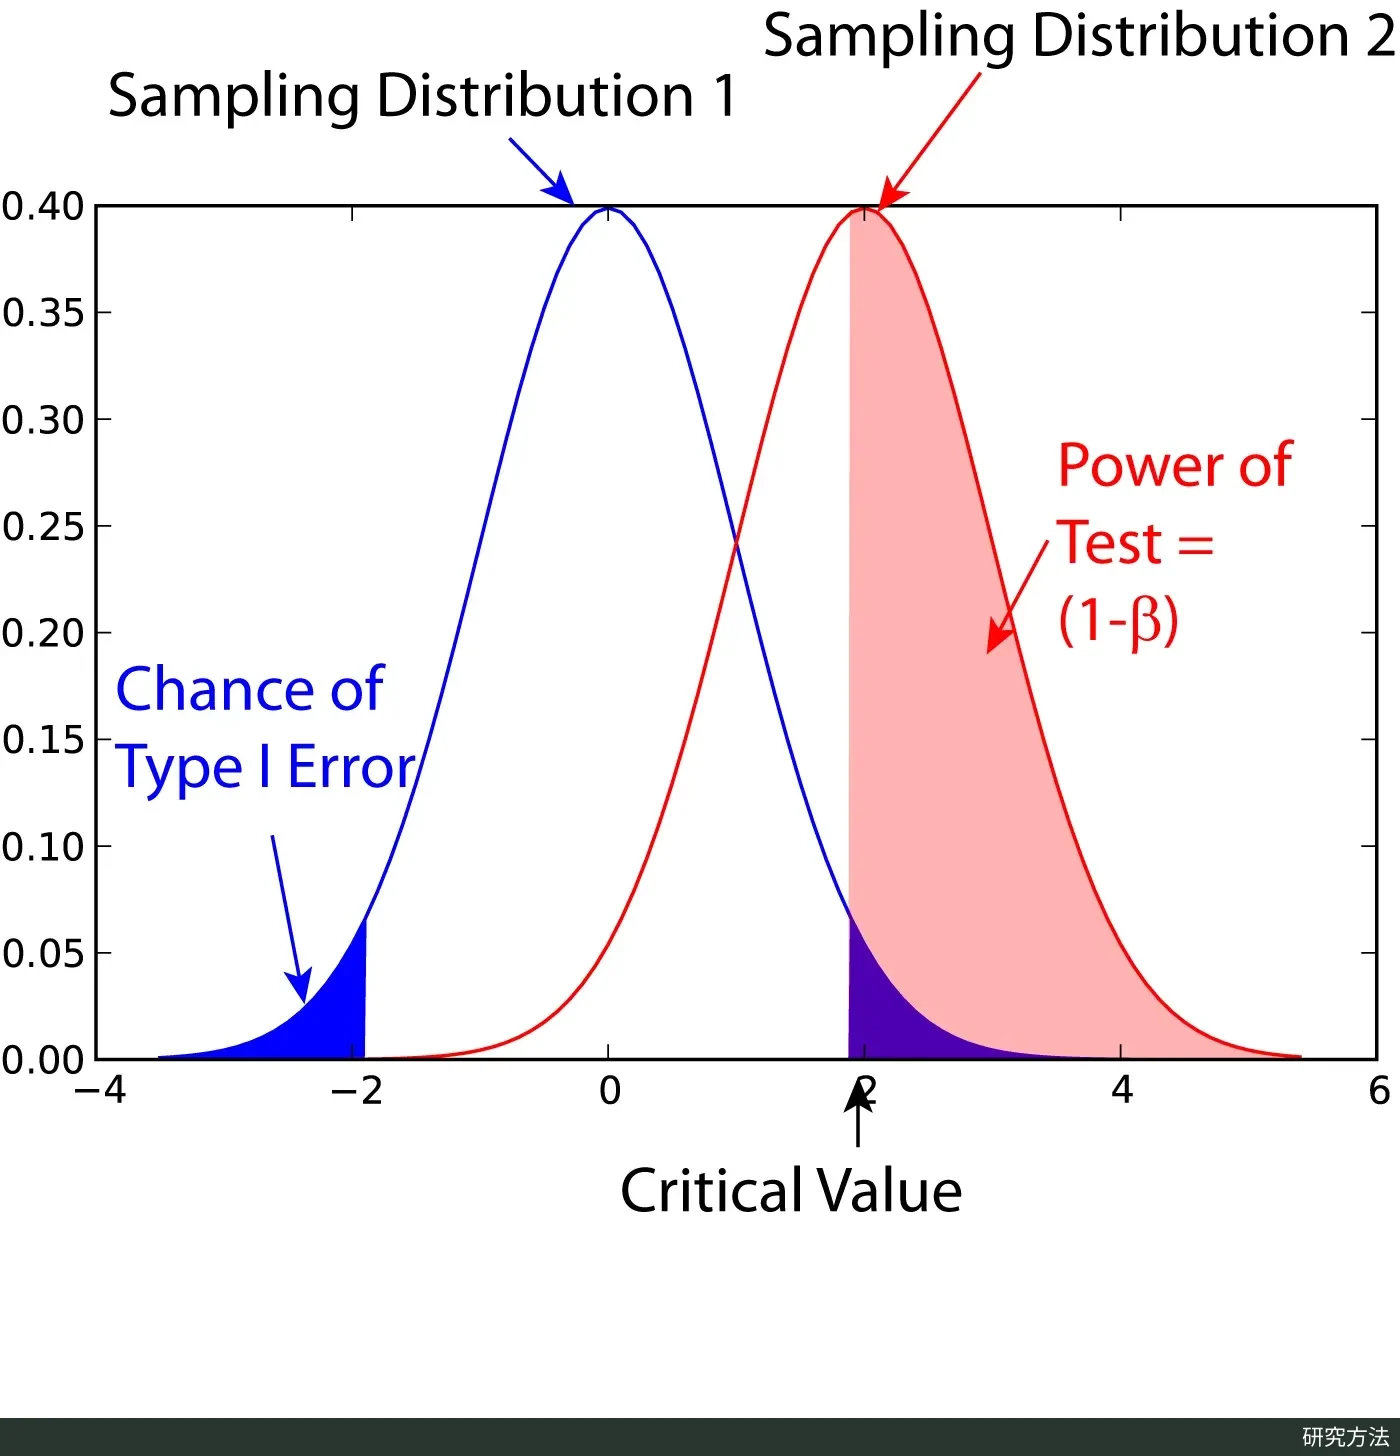
假设检验中一类错误与功效的示意:零假设与备择假设下的两条分布部分重叠,阴影分别表示一类错误概率(显著性水平 α)和检验功效。作者:user3000877(Cross Validated),来源:Wikimedia Commons,许可:CC BY-SA 4.0。

统计功效是效应真实存在时,检验能把它判为显著的概率。功效、显著性水平、效应量和样本量相互牵制,固定其中三个就能求出第四个,样本量计算由此而来。本文说明两类错误怎样权衡、效应量怎样进入公式、power.t.test 与 G*Power 怎样使用,附一个每组 64 人的可复算算例,并说明事后功效为何不宜用来解读不显著的结果。
功效与两类错误的权衡
假设检验先设定零假设 H₀(例如两组均值相同)和备择假设 H₁(两组确有差异)。H₀ 为真却拒绝了它,是一类错误,概率记为 α,也就是事先选定的显著性水平;效应真实存在却没能拒绝 H₀,是二类错误,概率记为 β。功效定义为 1 − β,即效应确实存在时检验报出“显著”的概率(Cohen, 1992)。可以把检验想成烟雾报警器:没着火却响是一类错误,真着火却不响是二类错误,功效就是真着火时它会响的概率。功效总是针对某个假定的真实效应而言:同一项研究对大效应功效高,对小效应功效低,所以说“这项研究功效为 80%”时,必须同时说明针对的是多大的效应。
Cohen(1992)把样本量、显著性水平 α、总体效应量与功效称为统计推断中相互关联的四个量:对给定的检验,任何一个都由另外三个决定。样本量和效应量固定时,两类错误此消彼长。以两组各 64 人、标准化效应量 d = 0.5 的双侧 t 检验为例,α = 0.05 时功效约为 0.80;把 α 收紧到 0.01,按正态近似功效降到约 0.60,要回到 0.80 就需要每组约 95 人,与 Cohen 表 2 的数值一致。Lakens(2022)给出了反方向的例子:每组最多只能收集 50 人、预期 d = 0.5 时,α = 0.05 只有 70% 的功效;若认为两类错误同样严重,可把 α 设为 0.149,使功效达到 0.851,这种做法称为折中功效分析。
80% 功效是约定,而不是定理。Cohen(1992)建议把 0.80 作为通用约定:明显更低会让二类错误风险过大,明显更高则所需样本往往超出研究者的资源;配合常用的 α = 0.05,二类错误与一类错误的风险之比为 0.20 : 0.05,即 4 : 1。临床试验指南 ICH E9(1998 年 2 月 5 日定稿)写明,一类错误概率通常设为 5% 或更低,二类错误概率通常设为 10%–20%;尤其对难以或无法重复的试验,把二类错误压得尽量低符合申办方自身利益;在某些情况下,采用其他取值也可以接受,甚至更可取。
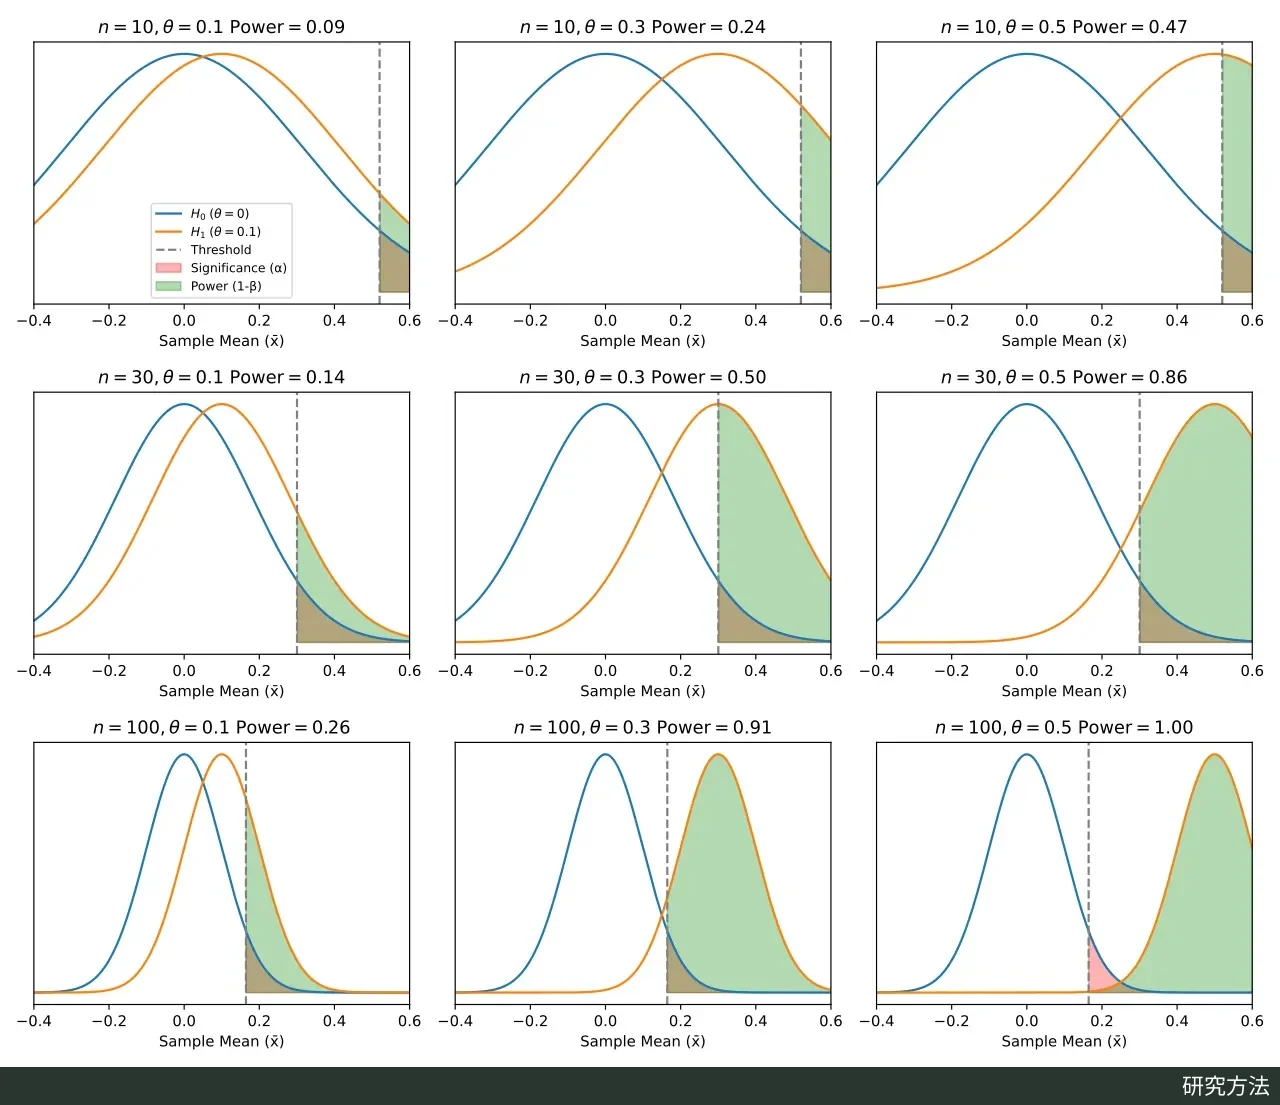
样本量与效应量共同决定功效:九个小图的行对应样本量 n = 10、30、100,列对应效应 θ = 0.1、0.3、0.5,每格画出零假设(θ = 0)与备择假设下样本均值的分布。红色阴影是固定为 0.05 的一类错误 α,绿色阴影是功效 1 − β:样本量越大,分布越窄;效应越大,两条分布相距越远,功效都随之上升。原图按单侧临界值绘制。作者:Cosmia Nebula,来源:Wikimedia Commons,许可:CC BY-SA 4.0。

效应量在样本量公式中的作用
比较两个独立组的均值、两组人数相等且标准差同为 σ 时,双侧检验每组所需样本量的正态近似公式为(Julious, 2004):
n = 2σ²(z₁₋α/₂ + z₁₋β)² / Δ²
其中 Δ 是希望检出的组间均值差,z₁₋α/₂ 与 z₁₋β 是标准正态分布的分位数(α = 0.05 双侧时为 1.960,功效 0.80 时为 0.842)。令标准化效应量 d = Δ/σ,公式化简为 n = 2(z₁₋α/₂ + z₁₋β)² / d²。
效应量以平方形式出现在分母上,这是样本量计算中最重要的一条规律:想检出的效应缩小一半,所需样本量变为四倍。Cohen 表 2 中,α = 0.05、功效 0.80 时,d = 0.5 需要每组 64 人,d = 0.2 则需要每组 393 人,两者之比约 6.1,接近 (0.5/0.2)² = 6.25。σ 也以平方进入公式:若把 σ 低估为真实值的一半,算出的样本量只有实际所需的四分之一。
上式假定方差已知。实际分析时用样本方差,检验统计量服从 t 分布,精确功效要用非中心 t 分布迭代求解。Julious(2004)指出,正态近似公式的结果通常只比精确解少一到两人,并介绍了 Guenther 的修正:在正态近似结果上加 z²₁₋α/₂ / 4(α = 0.05 双侧时约为 0.96)。常用软件给出的一般是基于非中心 t 分布的精确结果。
公式里最难确定的是 Δ 和 σ。ICH E9 要求试验方案写明样本量的计算方法、所用数值(方差、均值、应答率、待检出差值等)及其依据,并考察这些假设偏离时样本量如何变化;确证性试验的假设通常应基于已发表数据或早期试验的结果;待检出差值可以取有临床意义的最小效应,预期效应更大时也可以取预期效应。Lakens(2022)认为,最有力的样本量论证来自事先明确“最小关注效应量”;直接沿用单项研究或受发表偏倚影响的文献效应量往往会高估效应,可以改用偏倚校正方法,或按效应量 60% 双侧置信区间的下限来计算(称为 safeguard power)。Cohen 的 d = 0.2、0.5、0.8 是他为行为科学给出的“小、中、大”效应的操作化约定,不能代替对具体领域效应大小的判断。
可复算算例与软件用法
设想一项两组平行随机试验,比较新旧两种降压方案的收缩压下降幅度。以下数值都是演示用的假设:希望检出的组间差 Δ = 5 mmHg,标准差 σ = 10 mmHg,双侧 α = 0.05,功效 0.80,两组 1 : 1 分配。
- 标准化效应量:d = 5 / 10 = 0.5。
- 分位数:z₀.₉₇₅ = 1.960,z₀.₈₀ = 0.842,两者之和为 2.802,平方得 7.849。
- 正态近似:n = 2 × 7.849 / 0.5² = 62.8,向上取整为每组 63 人。
- Guenther 修正:62.8 + 1.960² / 4 = 62.8 + 0.96 = 63.75,取整为每组 64 人。
- 非中心 t 精确解:R 的
power.t.test给出 n ≈ 63.77,取整为每组 64 人、共 128 人,与 Cohen 表 2 中 d = 0.5 对应的 64 人一致。 - 预计 10% 的受试者脱落时,按 64 / (1 − 0.10) = 71.1 再取整,每组招募 72 人、共 144 人。ICH E9 要求方案写明如何处理退出和违背方案的受试者;若主分析采用全分析集,还可能需要把预期效应量调小。
# Solve for per-group n (two-sample, two-sided t test)
power.t.test(delta = 5, sd = 10, sig.level = 0.05, power = 0.80)

# The same design on the standardized scale gives the same n
power.t.test(delta = 0.5, sd = 1, sig.level = 0.05, power = 0.80)

# Power with 64 per group if the true difference is only 4 mmHg
power.t.test(n = 64, delta = 4, sd = 10, sig.level = 0.05)
前两行都解出 n ≈ 63.77;第三行给出的功效约为 0.61。
power.t.test 属于 R 自带的 stats 包。它的规则是:n、delta、power、sd、sig.level 五个参数中恰好留一个为 NULL,函数就解出这一个;n 指每组人数;type 可选 two.sample、one.sample 或 paired,alternative 可选双侧或单侧。sd 与 sig.level 带有默认值(1 和 0.05),要反求它们必须显式写 NULL。双侧检验默认只计入与真实效应同方向的拒绝概率,设 strict = TRUE 才把反方向的拒绝也计入。GPower 是免费的独立程序,第 3 版覆盖 t、F、χ² 检验族,以及 z 检验和部分精确检验(Faul 等, 2007)。本例在 GPower 中选择 t tests、Means: Difference between two independent means (two groups) 和 A priori,输入双侧、d = 0.5、α = 0.05、功效 0.80、分配比 1,同样得到每组 64 人。除事前分析外,G*Power 还能做敏感性分析和折中分析(Lakens, 2022)。
下表固定每组 64 人,看真实效应偏离假设时功效怎样变化。表中按正态近似计算,功效 ≈ Φ(d·√(n/2) − z₁₋α/₂),用任何标准正态分布表都能复算;power.t.test 基于 t 分布,结果略低,相差不超过 0.01。
| 真实组间差 | d | α = 0.05 时的功效 |
|---|---|---|
| 4 mmHg | 0.4 | 0.62 |
| 5 mmHg | 0.5 | 0.81 |
| 6 mmHg | 0.6 | 0.92 |
真实差值只要从 5 mmHg 降到 4 mmHg,功效就从约八成跌到约六成;若想对 4 mmHg 也保持 0.80 的功效,每组需要约 100 人。ICH E9 要求考察样本量对假设偏离的敏感性,原因就在这里。
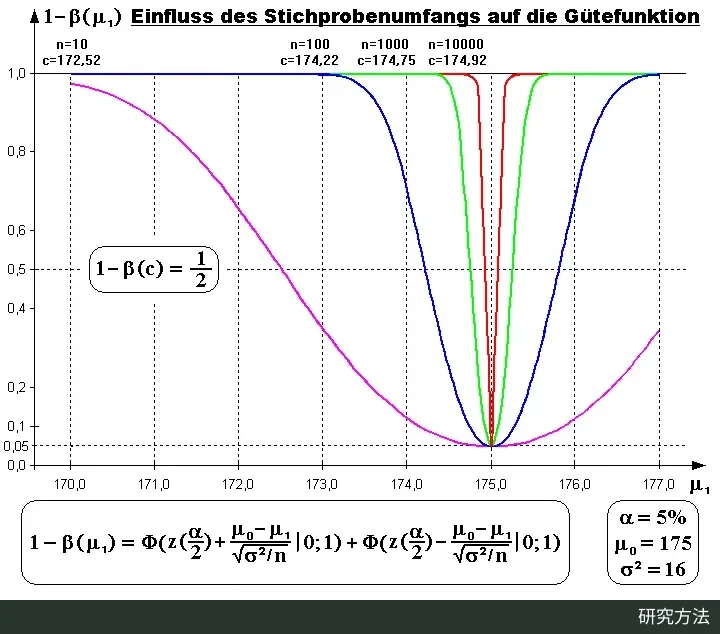
样本量对双侧检验功效函数的影响:各条曲线给出不同样本量下,拒绝零假设的概率如何随参数真值变化;样本量越大,参数偏离零假设时功效上升越快。原图为德文标注,参数与本文算例不直接对应。作者:Qniemiec,来源:Wikimedia Commons,许可:CC BY-SA 3.0。

事后功效的问题与替代做法
事后功效(也称观察功效、回顾性功效)是指研究结束后,把样本中观察到的效应量当作真实效应代入功效公式。常见用法是:结果不显著时,若算出的功效高,就说“功效充足却没发现差异,所以 H₀ 可能为真”;若功效低,就说“只是样本不够”。Hoenig 与 Heisey(2001)在 The American Statistician 上整理了 19 种应用学科期刊中推荐这种做法的方法学建议,其中至少两家期刊把它作为政策要求;他们指出,这种做法在逻辑上有根本缺陷。缺陷在于,观察功效是 p 值的一一对应函数,不提供任何新信息:以单侧 z 检验为例,p 恰好等于 α 时观察功效正好为 0.5,双侧检验时略高于 0.5,p 越大观察功效越低,所以不显著的结果总会对应较低的观察功效。“功效高所以支持 H₀”的推理还会自相矛盾:两项都不显著的研究中,观察功效较高的那项检验统计量更大、p 值更小,按通常标准反而是反对 H₀ 的证据更强。这就像考完试后用自己的分数去推算“这张卷子能不能测出我的水平”,推算结果完全由分数决定,不能为分数增加任何解释。
下表按双侧 z 检验、α = 0.05 计算,观察功效 = Φ(z − 1.96) + Φ(−z − 1.96),其中 z 是由 p 值反推的观察统计量。
| 观察到的 p 值 | 观察统计量 z | 观察功效 |
|---|---|---|
| 0.05 | 1.96 | 0.50 |
| 0.20 | 1.28 | 0.25 |
| 0.50 | 0.67 | 0.10 |
研究结束后更有用的工具有四类。第一,报告效应估计及其置信区间:Hoenig 与 Heisey 指出,有了置信区间之后,再算功效不会带来额外信息。第二,若想说明“不存在值得关注的差异”,应事先设定等效界值并做等效性检验(两次单侧检验);ICH E9 也写明,仅凭无差异零假设的检验不显著就得出等效或非劣效结论是不恰当的。第三,敏感性功效分析:固定已有样本量、α 和期望功效,求出研究能检出的最小效应。Lakens(2022)举例说,每组 15 人、α = 5%、功效 90% 时,研究只能检出 d ≥ 1.23 的效应,这个值应与最小关注效应量比较。第四,Gelman 与 Carlin(2014)提出的设计分析:根据外部信息而不是本研究的点估计设定可信的真实效应,计算功效、符号错误率(Type S,显著估计值方向与真实效应相反的概率)和夸大比(Type M,显著估计值的绝对值平均是真实效应的多少倍),并提供了 R 函数 retrodesign()。
低功效的代价不只是漏检。Button 等(2013)估计,神经科学研究的功效中位数大约在 8% 到 31% 之间;他们指出,低功效还会降低显著结果反映真实效应的可能性,导致效应量被高估、结果难以重复。功效分析应放在研究开始之前,用有依据的效应量来规划样本,而不是在结果出来之后用观察到的效应量为结论辩护。