
双重差分法(difference-in-differences,DiD)借用一组未受政策影响的对照单位,推算处理组“如果没有政策会怎样”,再用两组前后变化之差估计政策效应。它成立的关键是平行趋势假设:没有处理时,两组结果会同步变化。事件研究图把处理前后逐期的组间差异画出来,是检查这一假设最常用、也最容易被误读的工具。
核心思路与最低工资实例
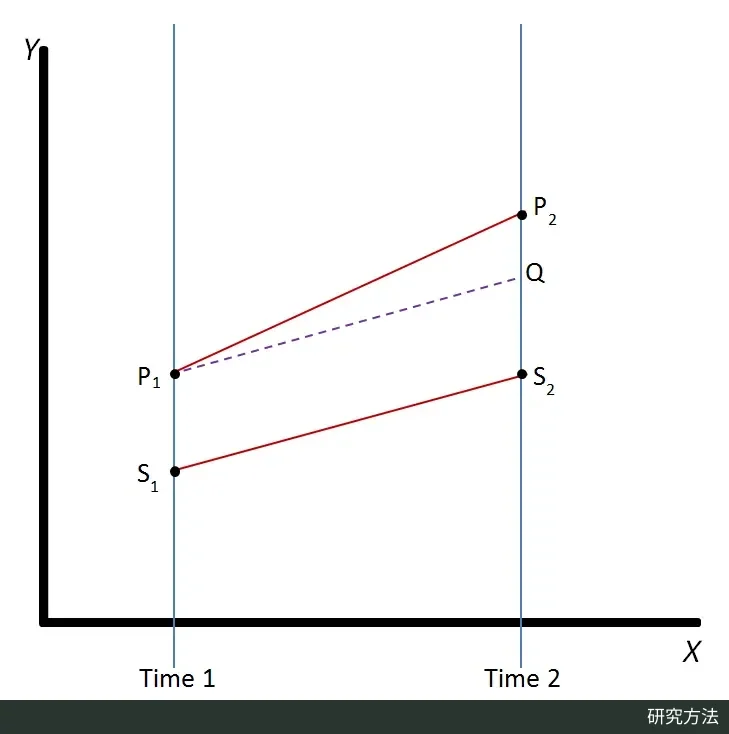
观察数据里的政策很少是随机分配的。只比较政策实施后的处理组和对照组,会把两组原本就有的差别算进效应;只比较处理组政策前后的变化,又会把同期的经济周期、季节波动等共同冲击算进去。DiD 把两种比较叠在一起:先算处理组前后的变化,再减去对照组同期的变化。第一次差分消掉不随时间变化的组间差异,第二次差分消掉两组共同经历的时间冲击。
用回归写,最简单的两组两期模型是:
交互项系数 就是 DiD 估计。用潜在结果框架拆开,它等于处理组的平均处理效应(ATT)加上一项“非平行趋势偏差”:处理组在没有处理时的变化,减去对照组的实际变化。只有这项偏差为零, 才是因果效应(Cunningham,Mixtape 第 9 章)。
经典实例来自 Card 和 Krueger(1994)。1992 年 4 月 1 日,新泽西州最低工资由每小时 4.25 美元提高到 5.05 美元,相邻的宾夕法尼亚州保持 4.25 美元不变。两人在调整前(1992 年 2 月 15 日至 3 月 4 日)和调整后(1992 年 11 月 5 日至 12 月 31 日)两次电话调查新泽西州和宾州东部的 410 家快餐店,结果变量是每店全职当量就业(FTE,全职员工含经理人数加上 0.5 倍兼职人数)。
| 每店 FTE 均值 | 宾州(对照组) | 新泽西(处理组) | 新泽西 − 宾州 |
|---|---|---|---|
| 调整前(1992 年 2–3 月) | 23.33 | 20.44 | −2.89 |
| 调整后(1992 年 11–12 月) | 21.17 | 21.03 | −0.14 |
| 前后变化 | −2.16 | +0.59 | +2.76(标准误 1.36) |
数据来源:Card & Krueger(1994)表 3,使用全部可得观测。
这张表可以这样读:同期宾州门店平均少了 2.16 个 FTE,作者推测与 1992 年中大西洋各州经济持续走弱有关。假如新泽西没有提高最低工资、也按宾州的幅度下降,它调整后应在 20.44 − 2.16 = 18.28 左右;实际是 21.03,两者之差 2.76 就是 DiD 估计,工作论文摘要将其概括为就业相对增加约 13%。两州起点相差 2.89 并不影响估计,DiD 只要求变化同步,不要求水平相同。这项研究只有前后两期,无法观察政策前的走势,作者因此另用新泽西州内起薪已在 5 美元及以上、基本不受新规影响的门店作第二对照组,得到相近结果。它的结论在劳动经济学界争议很大,但大大推动了 DiD 在经济学中的普及。
使用前提
第一个前提是平行趋势:如果处理组没有受到处理,它的结果变化会与对照组相同。这句话说的是一个不存在的反事实,政策实施后处理组“未受处理”的结果永远观察不到,所以平行趋势本身无法用数据直接检验,只能靠制度背景、对照组的选择理由和各种间接证据来论证。
第二个前提是无预期:处理组在政策生效前不会因为预期而提前改变行为。若政策提前公布、企业在基期就开始调整,基期实际上已被“处理”,DiD 只能识别生效后效应与基期已有效应之差;效应在两期大小相同时,估计会接近零。常见补救是把基期挪到政策宣布之前,但这同时改变了平行趋势所依赖的基期和效应的含义。
第三,对照组本身在研究期间不能受到处理。用已经接受处理的单位当对照,即使平行趋势成立,估计也会被扣掉对照组处理效应在前后两期之间的变化。最后是统计推断:DiD 数据通常是多期面板,同一单位的误差前后相关;Roth 等(2023)综述给出的经验法则是按处理被独立分配的层级聚类标准误,例如政策按州实施就按州聚类。
事件研究图的设定与读法
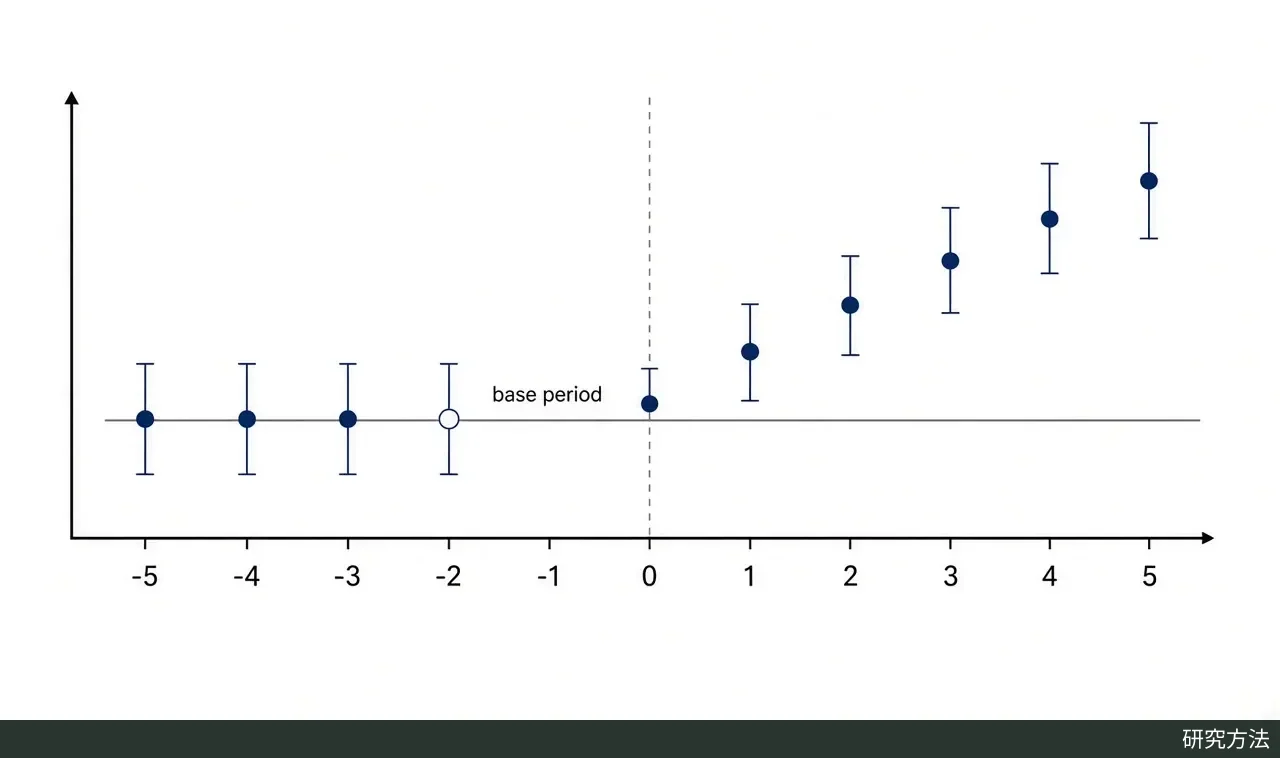
有多期数据时,可以把“处理组 × 处理后”这一个交互项拆成处理组与每一期的交互,并省略处理前最后一期()作为基期:
其中 是相对处理时点的期数。每个系数都相当于一个“该期相对基期”的两组两期 DiD。把这些系数及其 95% 置信区间按 排开画出来,就是事件研究图。
读图时分两段看。处理前的系数(leads,)衡量两组在处理前、相对基期的趋势差异,这些量全部可观测;它们接近零,说明两组过去走得相近,但这不等于平行趋势已经成立,因为平行趋势说的是处理后的反事实。处理后的系数(lags,)是各期 ATT 的估计,前提是从基期到该期平行趋势成立、没有预期效应、对照组从未或尚未接受处理。基期 处系数按设定为零且没有置信区间,这不代表那里估计特别精确,而是根本没有估计(Cunningham,Mixtape 第 9 章)。
常见误用
误用之一,是把“处理前系数不显著”当成平行趋势的证明。Roth(2022)指出,常规的预趋势检验往往功效很低;Roth 等(2023)的综述引用其模拟结果:在按顶级经济学期刊论文校准的设定中,常规检验只有 50% 概率能发现的线性趋势偏离,造成的偏差常常与估计出的处理效应一样大甚至更大。只在“通过预检验”时才报告结果,还会放大偏差、使置信区间覆盖率不足。综述建议在事件研究图旁同时报告敏感性分析,例如 Rambachan 和 Roth 的方法:假设处理后的趋势偏离不超过处理前最大偏离的 倍,报告结论在多大的 下开始失效。
误用之二,是在各单位先后接受处理(交错处理)时直接套用双向固定效应(TWFE)回归。Goodman-Bacon(2021)证明,这时的 TWFE 估计是数据中所有两组两期 DiD 的加权平均,其中包括把较早处理的单位当作较晚处理单位对照的比较;处理效应随时间变化时,估计会有偏。Roth 等(2023)的综述进一步指出,某些权重可能为负,极端情况下所有个体效应都为正而系数却为负;动态 TWFE 的处理前系数在效应异质时,即使平行趋势成立也不一定为零,拿它判断预趋势会被误导。综述介绍的替代做法(如 Callaway 和 Sant'Anna、Sun 和 Abraham 的估计量)只用从未处理或尚未处理的单位作对照,再按明确的权重汇总。
误用之三,是忽视序列相关、低估标准误。Bertrand、Duflo 和 Mullainathan(2004)在美国当前人口调查(CPS)的州层面女性工资数据上随机生成并不存在的“安慰剂法律”,用常规 OLS 标准误做 DiD:在约 20 年的数据中,最多有 45% 的安慰剂法律在 5% 水平上“显著”。他们给出的补救包括把数据合并为处理前、处理后两段,使用允许时期之间任意相关的标准误,以及基于安慰剂效应分布的随机化推断。