
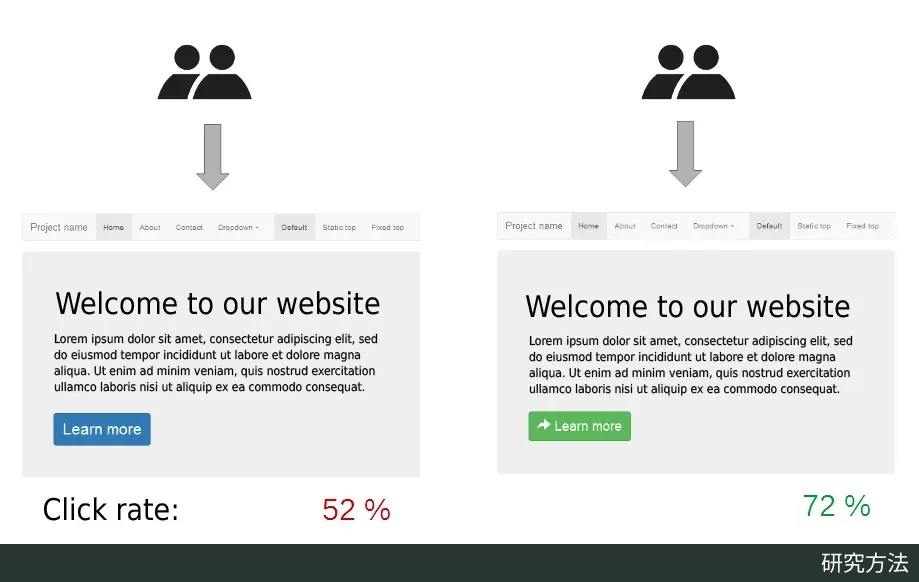
网站 A/B 测试的常见示意:两组访客分别看到只在“Learn more”按钮样式上不同的页面,图中 52% 与 72% 的点击率为示例数字,并非真实实验结果。作者:Maxime Lorant,来源:Wikimedia Commons,许可:CC BY-SA 4.0(已转换格式)。

2026 年 10 月 23 日,Andrew Gelman 在博客转述了实验工具开发者 Andrea Bronzini 的观察:A/B 测试的胜出方案上线后,提升常常缩水。Bronzini 认为,很多用户先见过旧版才被分组,实验测到的多是对“变化”的反应。Gelman 认可这一问题,并把它归为更一般的情形:处理效应会随时间变化,并取决于整段处理历史。
Gelman 博文的判断与建议
这篇博文篇幅很短,核心是一封读者来信加 Gelman 的回复。Bronzini 在信中说,他在开发实验工具时反复看到一种失败模式:A/B 测试中“赢了”的方案,推广到全部用户后提升随之流失。他的解释是,常见的实验设置把“新奇反应”和“稳态效应”混在了一起,因为分组发生在用户第一次接触被测内容之后,而结果指标本身又随时间变化。
Gelman 的回复有三层意思。第一,他认为 Bronzini 指出的是真实问题。第二,这个问题是更一般现象的特例:处理效应可以随时间变化,也可以取决于用户经历过的整段处理历史,而通常的组间比较忽略了这一点。第三,他推测(原文用的是“I guess”)最终更好的办法是把这些变异来源纳入模型。博文没有给出具体模型、数据或案例,只附上他的演讲《It’s About Time》作为延伸阅读,并说明该演讲尚未写成论文。
这场演讲的摘要于 2024 年 1 月 3 日发在同一博客上,主张把时间作为统计分析中的一个因素,列举的场景包括因果推断中的不平衡、即使组间平衡时 A/B 测试结论的推广、序贯分析、处理前测量的调整和民调汇总等。也就是说,“上线后提升消失”在 Gelman 看来只是时间维度被忽略的一种表现。
首次曝光污染与首次曝光随机化
Bronzini 所指的文章是他 2025 年 12 月 15 日首发、12 月 17 日更新的《The First-Exposure Contamination Problem》,作者自称“方法论随笔”,发布在其公司网站上,文中未见同行评审信息。文章区分了两个量:稳态处理效应(SSTE),指用户适应新版之后的长期差异,也是决策者真正想知道的;新奇反应效应(NRE),指已经熟悉旧版的用户遇到改动时的反应。作者强调,NRE 的方向和大小因场景而异,可能加速转化,也可能推迟或压低转化。
问题出在顺序上。多数实验在用户到达某个页面或触发某个组件时才分组,但不少用户在此之前已多次见过对照版。打个比方:一家餐厅换了新菜单,老顾客的第一反应可能是好奇,也可能是找不到常点的菜,这和新顾客第一次就看到新菜单时的反应并不相同(比喻为本文所加)。实验若在老顾客进门后才分组,比较的其实是“作为改动出现的 B”和“已经习惯的 A”,而不是两个版本各自的首次体验。
作者还从“转化所需时间”的角度解释为什么早期结果更容易被新奇反应主导:老用户已经在决策路径上走了一段,离转化更近,因此在实验早期的转化里占比偏高,这与他们在流量中的占比无关。文中给了一个示意性算例:销售周期平均 8 周、标准差约 2 周,转化率 2%,每周 1 万访客,实验跑 4 周,共约 4 万访客、800 次转化。按近似正态分布,从首次访问到转化不超过 4 周的转化不到约 3%,绝大多数转化来自实验开始前就已来访的用户。4 周恰好比均值低 2 个标准差,对应的比例约为 2.3%。
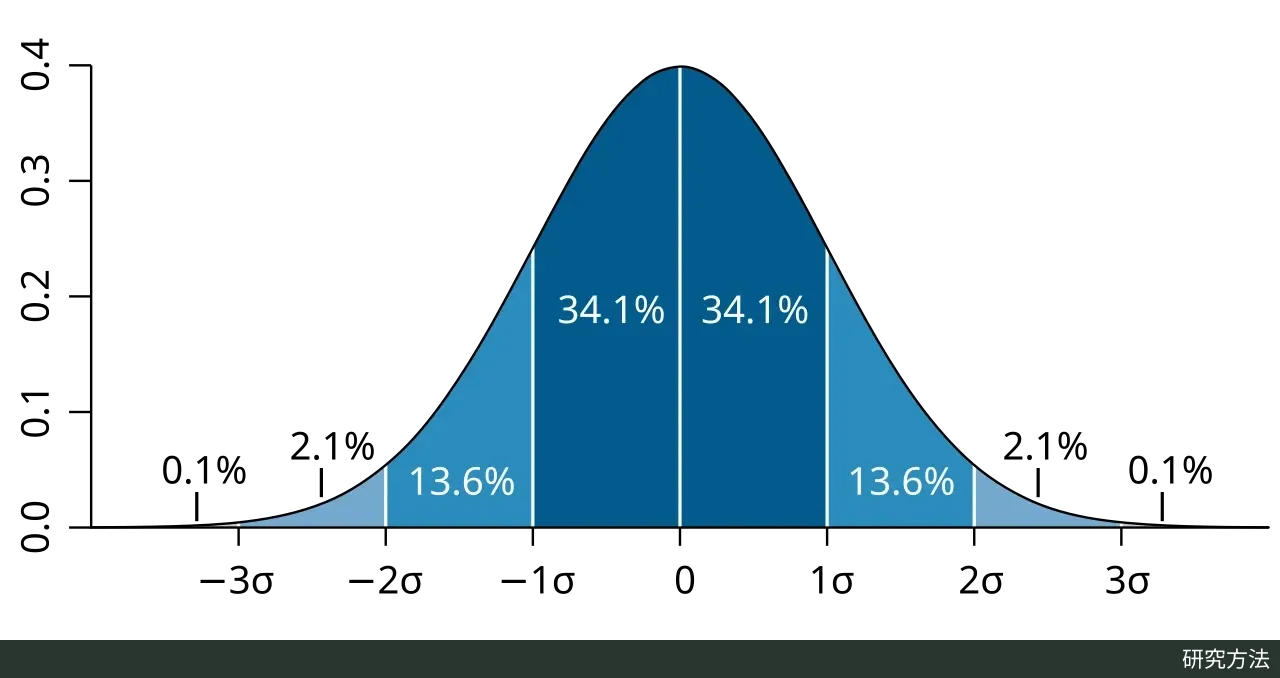
正态分布按标准差分段的面积比例。套用白皮书的示意参数(首次访问到转化平均 8 周、标准差 2 周),横轴的 −2σ 对应 4 周,其左侧两段合计约 2.2%(图中数字经四舍五入,精确值约 2.3%),即首访到转化不超过 4 周的转化份额;参数为假设,非实测数据。作者:M. W. Toews,来源:Wikimedia Commons,许可:CC BY 2.5(已转换为位图)。

据此,白皮书认为上线后提升消失常被误诊为“回归均值”:实验期间的估计可能既精确又稳定,变化的不是抽样误差,而是要估计的对象本身。作者提出“首次曝光随机化原则”:只纳入首次进站时间晚于实验开始时刻的用户,实现上只需一个首访时间戳,通常存放在 cookie 里;对销售周期长的业务,再配合队列入组,即设定入组窗口,向这批用户持续投放超过典型销售周期的时间,窗口之后进来的用户不再纳入。作者也承认,清除 cookie、多设备访问会把老用户误判成新用户,但认为这种误差大体在两组之间对称。
与常规功效计算的冲突
Gelman 的博文没有讨论功效计算,以下是本文结合两份材料的整理。常规的功效计算先设定基线转化率、最小可检测效应、显著性水平和目标功效,算出所需样本量,再按日流量折算运行天数。这套算法隐含一个前提:要估计的效应是一个固定的数,误差只来自抽样噪声,样本越多估计越准。
如果效应随时间和曝光历史变化,这个前提就不成立。白皮书明确写道,在首次曝光污染下,增加样本量并不能找回正确的效应;上线后提升消失也不是统计功效不足造成的。样本量能压低方差,却纠正不了估计对象的错位。好比用一台很精准的秤去称一个装错了货的箱子,秤再准,读数也不是你要的那个重量。
放回 8 周算例里看,冲突更直观:一次功效计算可能认为 4 周、800 次转化已经足够,但其中能反映稳态效应的只有几十次。若按白皮书的建议只用“干净”队列,又必须把实验拉长到超过销售周期,同时可用样本大幅缩小。设计时需要在运行时长、有效样本和估计对象之间重新取舍,而只针对一个固定效应的功效公式并不处理这一层。
两位作者指向的出路也不同。Bronzini 走设计路线,靠限定入组人群直接识别稳态效应;他在结论中承认,延长运行或使用动态模型在附加假设下也可能逼近稳态效应,但认为首次曝光随机化是不依赖习惯化假设的最低设计条件。Gelman 则倾向建模路线,把时间和处理历史作为变异来源写进模型。
证据范围与待解问题
阅读时需要区分几层说法。Gelman 的认可是概括性的,他说的是 Bronzini“指出了真实问题”,并没有逐条背书白皮书中“传统实验大多测到的是新奇反应”之类的判断。白皮书的算例和示意图使用的是作者设定的参数,不是真实实验的数据,文中也没有公开数据集;新奇反应在具体业务中有多大,作者自己也说需要逐案量化。
另一个问题与人群差异有关(本段为本文分析)。只纳入新用户,识别的是“新用户一开始就看到 B”时的效应。白皮书认为这批用户的曝光顺序与全面上线后的人群一致,但老用户适应 B 之后的长期反应是否与新用户相同,仍需要额外假设;如果两类用户本身就不一样,干净队列的结论推广到全体用户时仍可能有偏差。这正是需要把用户类型和曝光历史一起建模的地方。此外,以首访时间为门槛,前提是实验开始时刻确实是切换点、之后不再延迟投放旧版,作者在文中也注明了这一点。