
同一个总体,抽 25 个数得到的平均值,和抽 400 个数得到的平均值,究竟能差多少?与其只背标准误的公式,不如把抽样重复一万次。本次用 Python 3.14.6 运行模拟,让每种样本量都产生一万次独立抽样的均值,再比较这些均值的分散程度。
模拟设定与步骤
模拟总体设为正态分布,均值 72、标准差 12。每个数都是程序生成的连续数值,72 和 12 是模型参数。样本量依次设为 25、100、400;每种设置重复 10,000 次。这里 n 是每次计算均值使用的观测数,10,000 是重复整项抽样的次数。增加前者可以使一次均值估计更稳定,增加后者使我们更准确地观察这种波动。
先取 n=25:生成 25 个数,求出一个均值,保存下来;重新生成 25 个数,再求均值。重复完后,手里有 10,000 个均值。对这 10,000 个均值计算样本标准差,便得到对均值标准误的模拟估计。n=100 与 n=400 使用相同操作。
模拟结果与理论值
| 每次抽样 n | 重复次数 | 均值的平均值 | 模拟标准误 | 理论标准误 |
|---|---|---|---|---|
| 25 | 10,000 | 72.031 | 2.385 | 2.400 |
| 100 | 10,000 | 71.992 | 1.190 | 1.200 |
| 400 | 10,000 | 71.993 | 0.605 | 0.600 |
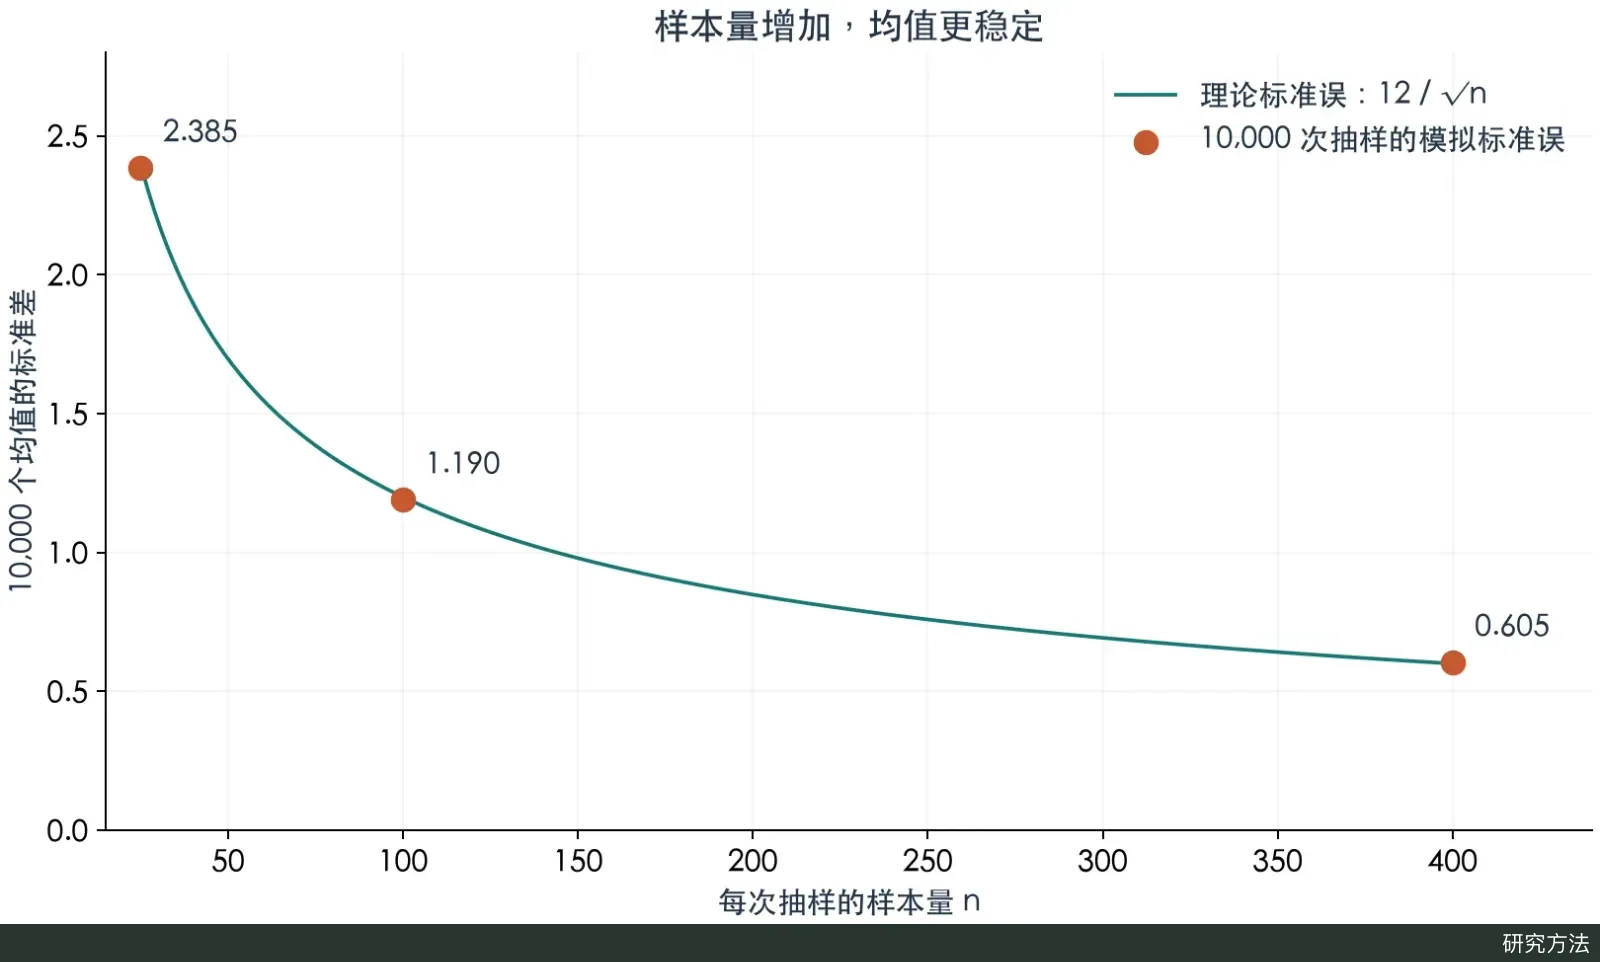
图:曲线为 σ/√n 的理论值,圆点为本次 10,000 次重复得到的模拟标准误。数据与图均由本文代码计算;总体 σ 固定为 12。
表中三行的模拟标准误依次为 2.385、1.190 和 0.605,对应的理论值 12/√n 为 2.4、1.2 和 0.6。n 从 25 增到 100,再从 100 增到 400,每次都扩大四倍,√n 随之翻倍,标准误各降到约一半。要让均值的波动减半,每次抽样需要四倍的观测。模拟值与理论值最多相差约 0.015,这是只重复 10,000 次带来的随机波动;换一个种子,小数点后第二、三位会略有变化。
复算代码
"""Original simulated examples for the second statistics article."""
import json, math, random, statistics, sys
from pathlib import Path
rng=random.Random(20261016)
rows=[]
for n in (25,100,400):
    means=[statistics.fmean(rng.gauss(72,12) for _ in range(n)) for _ in range(10000)]
    empirical=statistics.stdev(means)
    rows.append(dict(n=n,repetitions=10000,mean_of_means=statistics.fmean(means),empirical_se=empirical,theoretical_se=12/math.sqrt(n)))
result=dict(seed=20261016,python=sys.version,population=dict(distribution='Normal',mean=72,sd=12),results=rows)
print(json.dumps(result,indent=2))
把代码保存为 standard_error.py,运行 python3 standard_error.py。它只使用 Python 标准库,固定随机种子 20261016。输出中的 empirical_se 对应表里的模拟标准误,theoretical_se 对应 σ/√n。图以结果 JSON 中的三个圆点和理论曲线绘制;复算数字不需要安装绘图库。
总体标准差与独立性
在这次模型中,n=400 时均值的波动已经较小,但单个观测仍来自标准差为 12 的总体。我们获得了更稳定的均值估计,并没有把个体差异压缩到 0.6。若把数据生成器改成每组共享一个随机偏移,观测之间就会相关,此时这条独立抽样公式不再直接适用。
读完图,可以做一个小改动:把总体标准差从 12 改为 24,保留三种 n 和种子,再运行一次。由于这次生成的每个值相对72的偏移都恰好加倍,三个模拟标准误也会加倍。这把样本量的作用与测量分散的作用分开了。前篇样本量与标准误给出公式关系,本篇提供可以直接改参数的运行方法。
公式背景:NIST 均值区间说明。本文模拟于2026年10月16日实际运行,随机种子、软件版本与结果均保留。