
样本只有 20 个、真实成功率为 5% 时,一个标着“95%”的比例区间,能多经常包含这个真实比例?我们按前篇的实验方案实际运行了六组条件。最小样本、低比例这一组,Wald 覆盖率只有 64.66%,Wilson 为 92.41%。这两个数来自已运行的模拟,下面给出设置、结果和独立核对。
实验设置与区间公式
每次生成 n 个独立伯努利观测,成功记1,失败记0。n 取20、100、500,真实比例 p 取0.05、0.50,两因素组合成六种条件;每种重复10,000次。两种区间使用同一次抽样产生的成功数 k,因此比较没有混入两批不同数据。随机种子20261015,Python 3.14.6,共完成60,000次重复。
每次计算样本比例 q=k/n。Wald 区间为 q±z√[q(1−q)/n],z=1.959963984540054。Wilson 区间的中心为(q+z²/2n)/(1+z²/n),半宽为 z√[q(1−q)/n+z²/(4n²)]/(1+z²/n)。每次检查上下界是否包含设定的 p,并记录上界减下界;覆盖次数除以10,000得到模拟覆盖率。Wald 使用未经截断的原公式。
六组模拟结果
| n | 真比例 p | Wald 模拟覆盖率 | Wilson 模拟覆盖率 | Wald 平均宽度 | Wilson 平均宽度 |
|---|---|---|---|---|---|
| 20 | 0.05 | 64.66% | 92.41% | 0.1475 | 0.2193 |
| 20 | 0.50 | 96.04% | 96.04% | 0.4269 | 0.3927 |
| 100 | 0.05 | 87.47% | 96.57% | 0.0827 | 0.0883 |
| 100 | 0.50 | 94.15% | 94.15% | 0.1950 | 0.1914 |
| 500 | 0.05 | 93.04% | 94.77% | 0.0380 | 0.0385 |
| 500 | 0.50 | 94.26% | 94.26% | 0.0876 | 0.0872 |
这一组的失败主要来自 k=0。n=20、p=0.05 时,20 次全部失败的概率为 0.95^20≈0.358486。此时 q=0,Wald 半宽 z√[q(1−q)/n] 等于0,区间退化为[0,0],无法包含0.05,仅这一种结果就让覆盖率少了约35.85个百分点。Wilson 的半宽里多出 z²/(4n²) 一项,k=0 时区间约为[0,0.161],仍包含真值。Wilson 也没有达到95%:k=3 时它的下界约0.0524,刚好高于0.05,而 k≥3 的概率约7.55%。
当 p=0.5 时,两种方法在本次三种 n 下的覆盖次数相同,平均宽度仍不同。例如 n=20 时,Wilson 平均宽度约0.3927,Wald约0.4269。因此只看命中次数还不够:覆盖率说明区间包含真值的频率,宽度说明为此留下了多大的范围。
二项枚举核对
随机模拟之外,还可以把 k=0,1,…,n 的全部可能取值列出来。每个 k 的概率为 C(n,k)p^k(1−p)^(n−k);把“区间包含p”的那些概率相加,就得到该设定下的精确覆盖率。这里的“精确”指对二项分布全部取值求和,不是把 Wald 或 Wilson 改成另一种精确区间。六组概率总和均在1的10⁻¹²以内。
| n | p | Wald 枚举覆盖率 | Wilson 枚举覆盖率 |
|---|---|---|---|
| 20 | 0.05 | 63.89% | 92.45% |
| 20 | 0.50 | 95.86% | 95.86% |
| 100 | 0.05 | 87.75% | 96.59% |
| 100 | 0.50 | 94.31% | 94.31% |
| 500 | 0.05 | 93.17% | 94.99% |
| 500 | 0.50 | 94.56% | 94.56% |
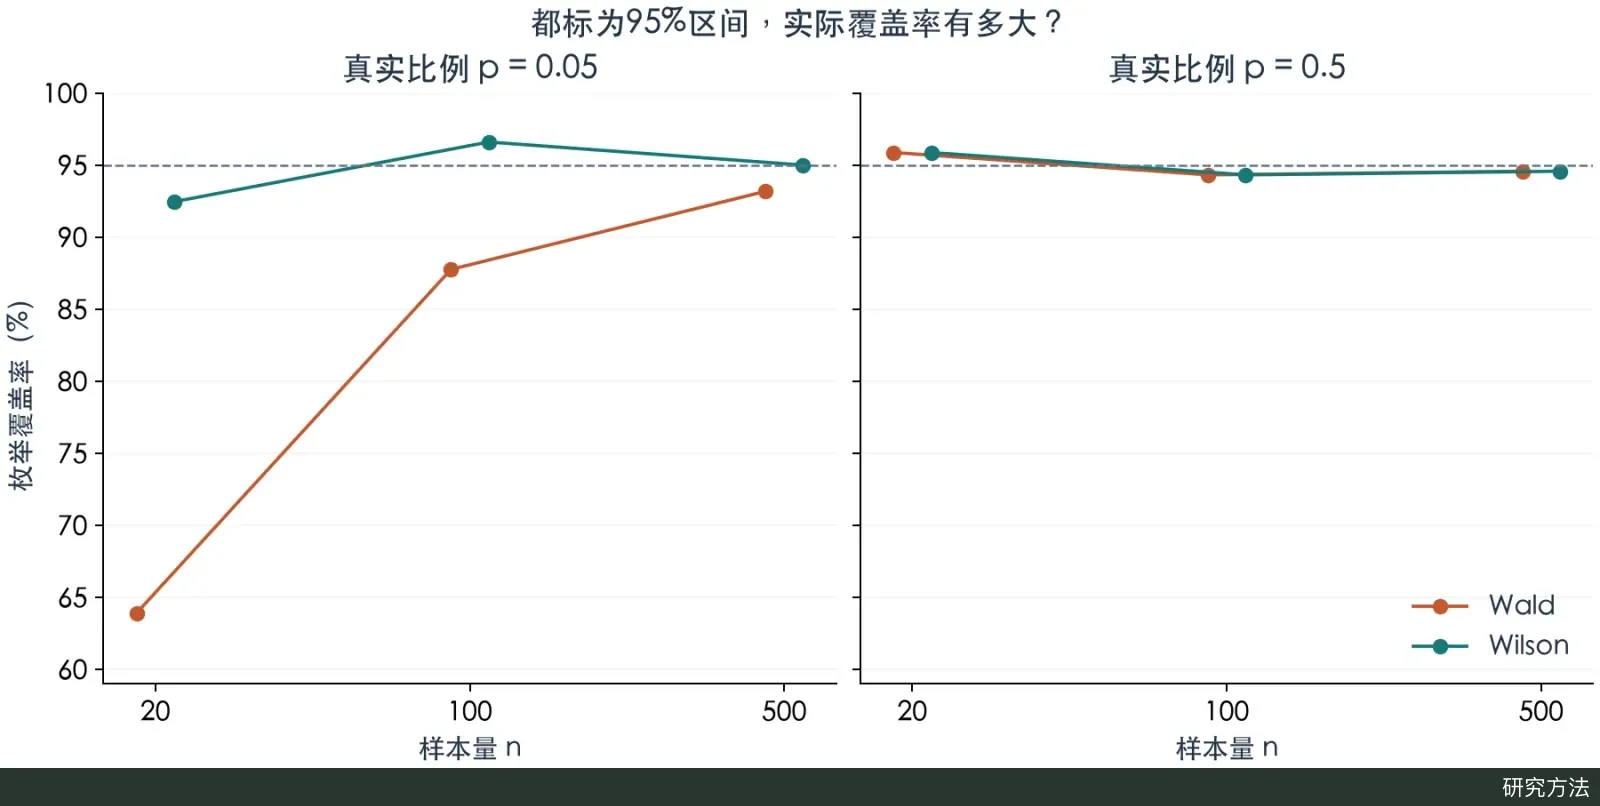
图:二项分布逐项枚举得到的覆盖率,虚线为95%。本图使用枚举结果;上表第一张表使用Monte Carlo结果,二者分别标注。
例如 n=20、p=0.05 时,枚举得到 Wald 63.89%、Wilson 92.45%,与模拟的64.66%、92.41%接近。10,000次重复的覆盖率估计,其Monte Carlo标准误为√[c(1−c)/10000];c接近0.64时约0.0048,也就是0.48个百分点。模拟与枚举间约0.77个百分点的差异处于合理的抽样波动尺度。
这次实验支持一个具体选择:当成功事件稀少、样本较小时,直接使用正态近似的 Wald 区间可能大幅低于名义覆盖率,Wilson 在这里改善明显。把 n 增至500、p保持0.05,枚举覆盖率仍分别为93.17%与94.99%。选区间方法时应同时看样本量、比例所在位置和允许的宽度。
复算代码
"""Reproducible editorial experiment. Simulated Bernoulli data, not observations."""
import random, math, json, sys
from pathlib import Path
seed = 20261015
rng = random.Random(seed)
z = 1.959963984540054
rows = []
for n in (20, 100, 500):
    for p in (0.05, 0.5):
        trials, wald_hits, wilson_hits, widths, wald_widths = 10000, 0, 0, [], []
        for _ in range(trials):
            k = sum(rng.random() < p for _ in range(n))
            phat = k / n
            half = z * math.sqrt(phat * (1-phat) / n)
            wald_hits += phat-half <= p <= phat+half
            wald_widths.append(2*half)
            den = 1 + z*z/n
            center = (phat + z*z/(2*n))/den
            whalf = z * math.sqrt(phat*(1-phat)/n + z*z/(4*n*n))/den
            wilson_hits += center-whalf <= p <= center+whalf
            widths.append(2*whalf)
        rows.append(dict(n=n,p=p,repetitions=trials,wald_coverage=wald_hits/trials,wilson_coverage=wilson_hits/trials,wald_mean_width=sum(wald_widths)/trials,wilson_mean_width=sum(widths)/trials))
out={'seed':seed,'python':sys.version,'method':'Bernoulli Monte Carlo, two-sided 95% normal Wald and Wilson score intervals','results':rows}
print(json.dumps(out,indent=2))
把代码保存为 intervals.py,运行 python3 intervals.py 即可复算第一张表。若要独立核对,把每轮随机抽样替换成 for k in range(n+1),用 math.comb(n,k)*p**k*(1-p)**(n-k) 作为该次结果的权重,分别累加覆盖真值时的权重。抽样模拟与有限枚举使用不同路径得到结果,可以帮助发现抽样循环或分母写错。
公式资料:NIST 比例置信区间。本文的六组模拟、枚举和图表为2026年10月16日实际计算;生成数据用于检验区间方法。