
1881 年,天文学家西蒙·纽科姆注意到,对数表的前几页比后几页磨损得快;1938 年,通用电气公司的物理学家弗兰克·本福特用两万多个数字验证了同一现象:在许多真实数据里,首位数字是 1 的约占三成,是 9 的不到 5%。这条规律后来被用于查账和选举核查,但它只能提示哪些数据值得复查,不能单独证明造假。
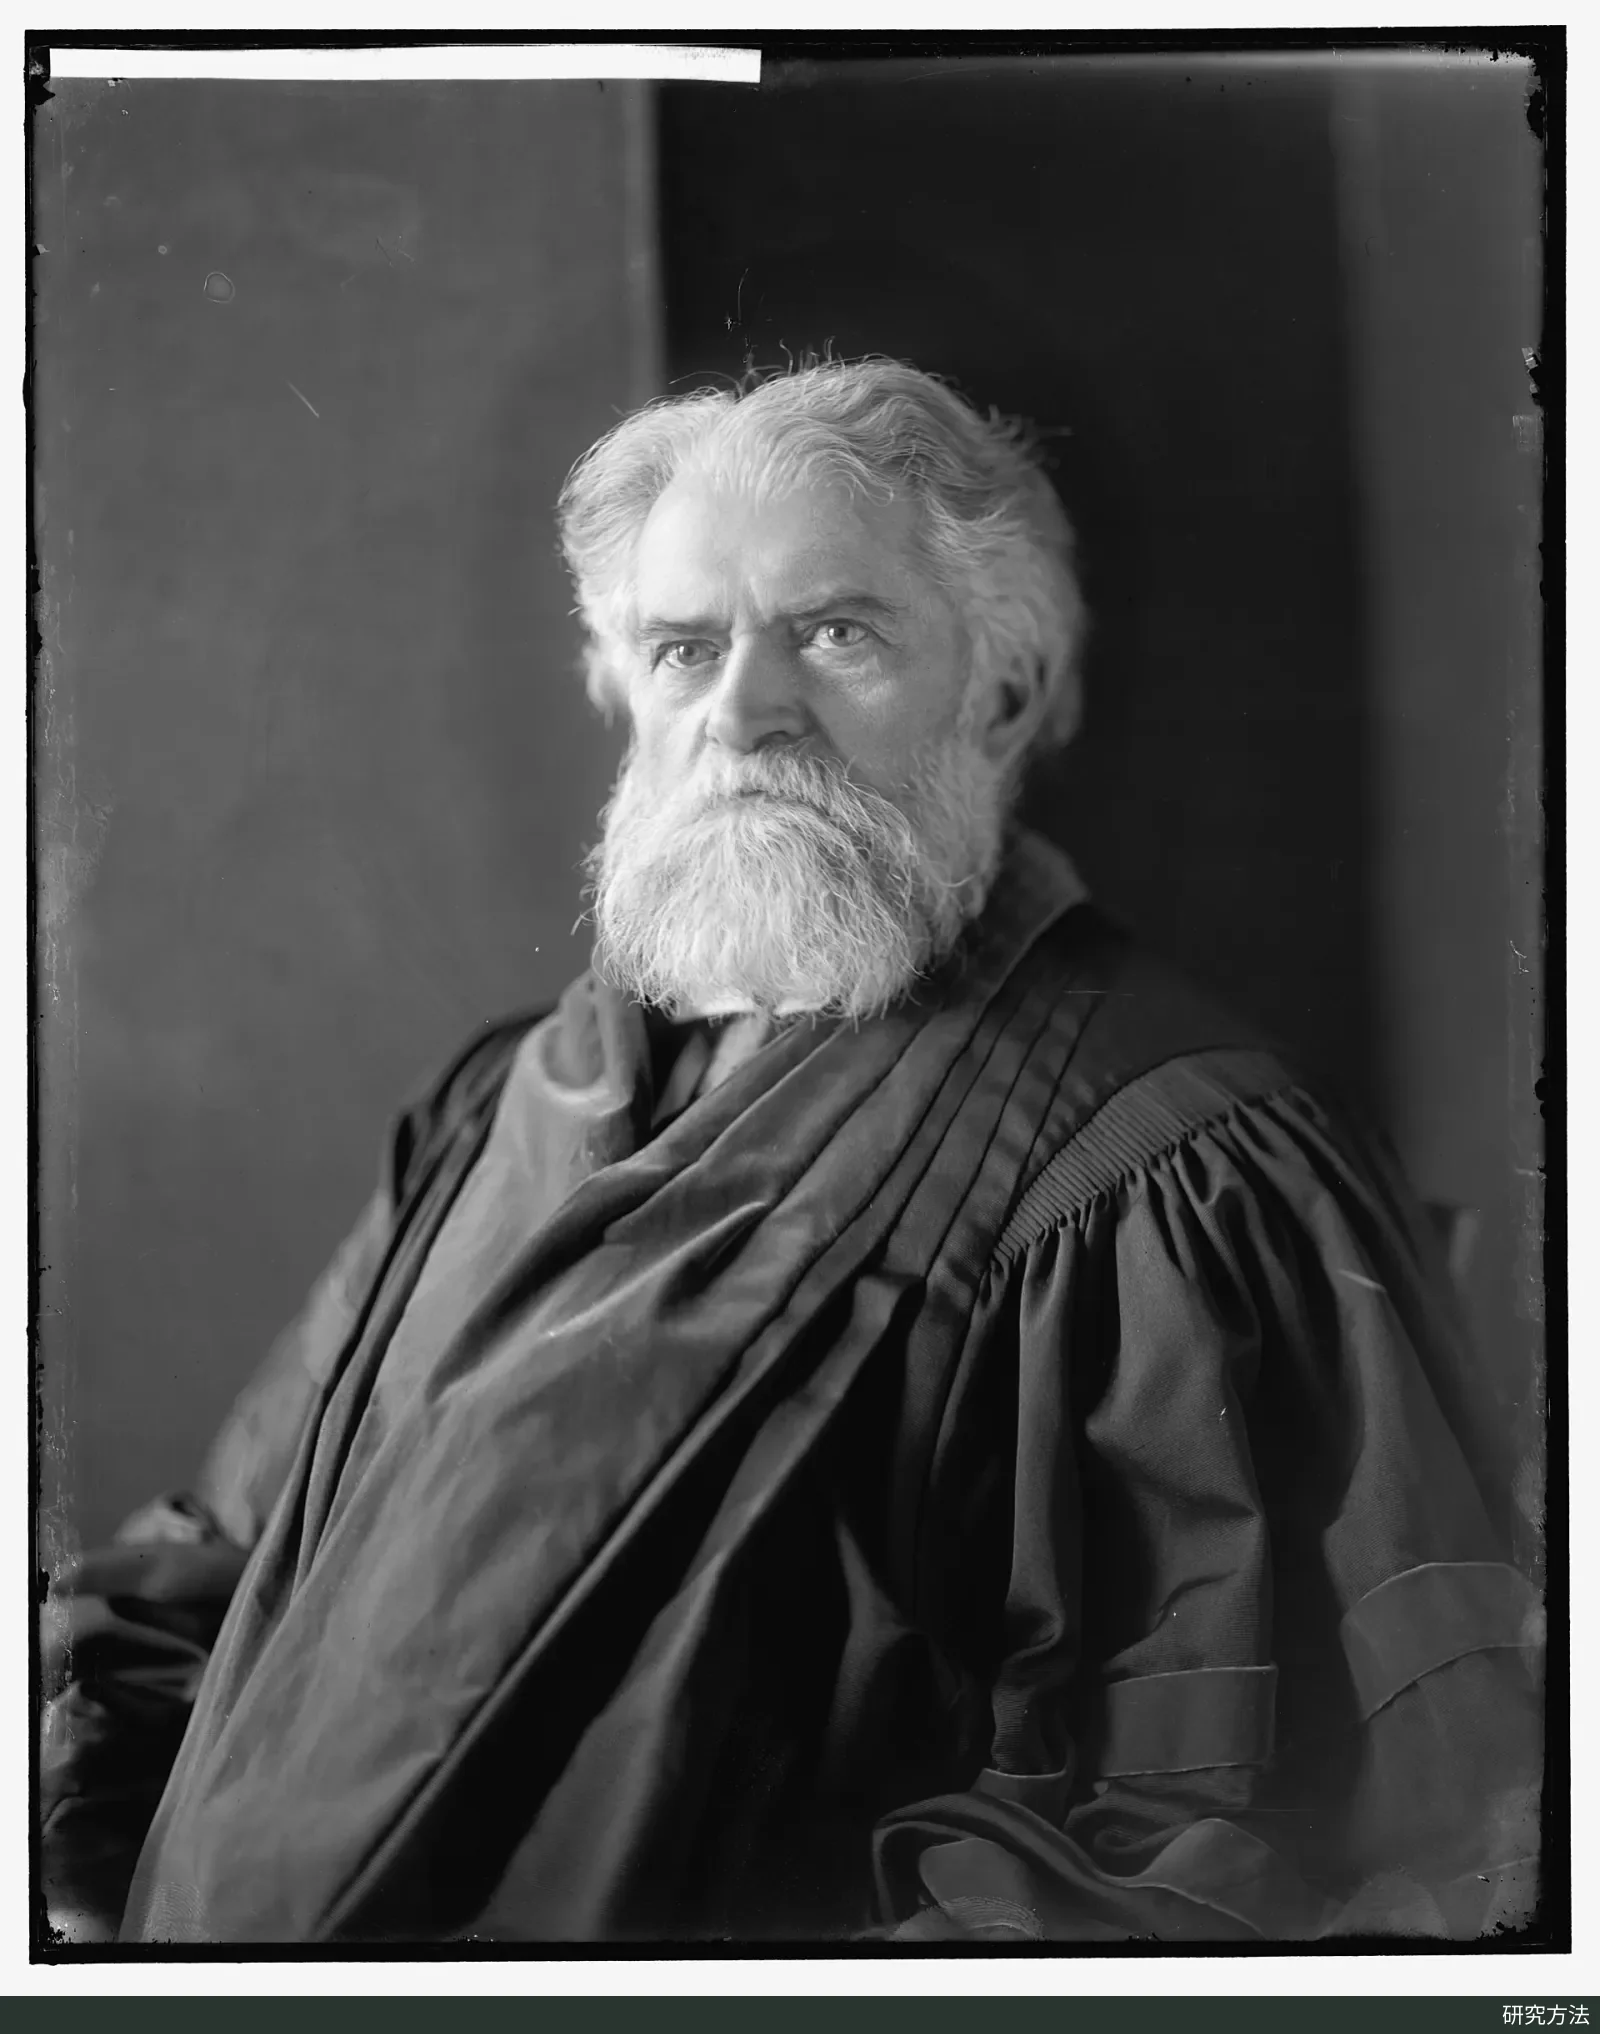
西蒙·纽科姆肖像,约摄于 1905 至 1909 年间。摄影:Harris & Ewing;来源:美国国会图书馆藏品(经 Wikimedia Commons);许可:公有领域。

纽科姆与本福特的观察
西蒙·纽科姆(Simon Newcomb)是美国天文学家和数学家。1881 年,他在《美国数学杂志》第 4 卷发表了一篇只有两页的短文《论自然数中不同数字的使用频率》。文章开头写道:经常使用对数表的人会发现,前面几页比后面几页磨损得快得多。在计算器出现之前,做乘除运算要先查对数表,而表中的数按大小排列,以 1 开头的数在最前面。前几页磨损更快,说明人们要查的数以 1 开头的更多。
纽科姆据此判断:首位有效数字是 1 的情况多于其他数字,频率从 1 到 9 依次递减。他的论证是,自然界中出现的数可以看作量与量的比值,经过反复相除,这些数取对数后的小数部分(尾数)会趋于均匀。由此他得出结论:“所有对数尾数等可能出现。”他还据此算出了前两位数字的概率。按他的表,第二位数字已经接近均匀,0 约为 11.97%,9 约为 8.50%;到了第三位,各数字的概率几乎相同。
半个多世纪后,通用电气公司研究实验室的物理学家弗兰克·本福特(Frank Benford)做了一次大规模统计。他的论文《反常数字定律》于 1937 年 4 月 22 日在美国哲学学会宣读,1938 年 3 月发表于《美国哲学学会会刊》第 78 卷。本福特收集了 20 组数据,共 20,229 个观察值,来源包括河流面积、美国人口、物理常数、报纸上出现的数字、比热、分子量、1936 年美国联盟的棒球统计、《美国科学名人录》中的街道地址和死亡率。20 组的平均结果中,首位是 1 的占 30.6%,是 9 的只占 4.7%。
本福特也发现,单独一组数据不一定贴合这条规律。原子量一组首位为 1 的比例高达 47.2%,物理常数一组为 41.3%。反倒是把彼此无关的数字放在一起,例如从报纸上摘出的各类数字,与对数分布吻合得更好。他把这种“单个数字之间毫无联系、成批出现时却服从同一分布”的现象称为“反常数字”,这条规律后来以他的名字命名。
尺度不变性与混合分布的解释
本福特定律通常写成:首位数字为 d 的概率 P(d) = log₁₀(1 + 1/d),d 取 1 到 9。代入计算,1 约占 30.1%,2 约占 17.6%,3 约占 12.5%,依次递减到 9 约占 4.6%。这与纽科姆的说法等价:把一个数写成科学记数法,取以 10 为底的对数,小数部分在 0 到 1 之间均匀分布。首位为 1 的数,对应的小数部分落在 0 到 log₁₀2(约 0.301)之间,这段区间最长,所以 1 出现得最多。
可以用一个按比例增长的量来理解。假设某城市人口每年增长 10%,从 100 万增长到 200 万需要约 7.3 年,这段时间人口数一直以 1 开头;从 900 万增长到 1000 万只需约 1.1 年,以 9 开头的阶段一闪而过。如果在随机的时间点去看这类数据,看到首位是 1 的机会自然更大。
1961 年,罗杰·平卡姆(Roger Pinkham)在《数理统计年刊》上证明:如果存在一种不随计量单位改变的首位数字分布,也就是无论用美元还是欧元、米还是英尺记录,比例都一样,那么它只能是 log₁₀(1 + 1/d)。“九个数字等可能”的分布经不起换单位:把所有数乘以 2,原来以 5 到 9 开头的数都会变成以 1 开头。
尺度不变性说明了“如果有这样一条规律,它应当是什么形状”,却没有说明真实数据为什么会这样。1995 年,西奥多·希尔(Theodore Hill)在《统计科学》上给出了一个统计学解释:如果先以不偏向任何尺度的方式随机选出许多不同的分布,再从每个分布中抽样,把样本合并起来,首位数字的频率就会收敛到本福特分布。这个结论并不要求每个单独的分布都服从本福特定律,正好对应本福特的观察:单张表格常常不贴合,多种来源合在一起反而贴合。
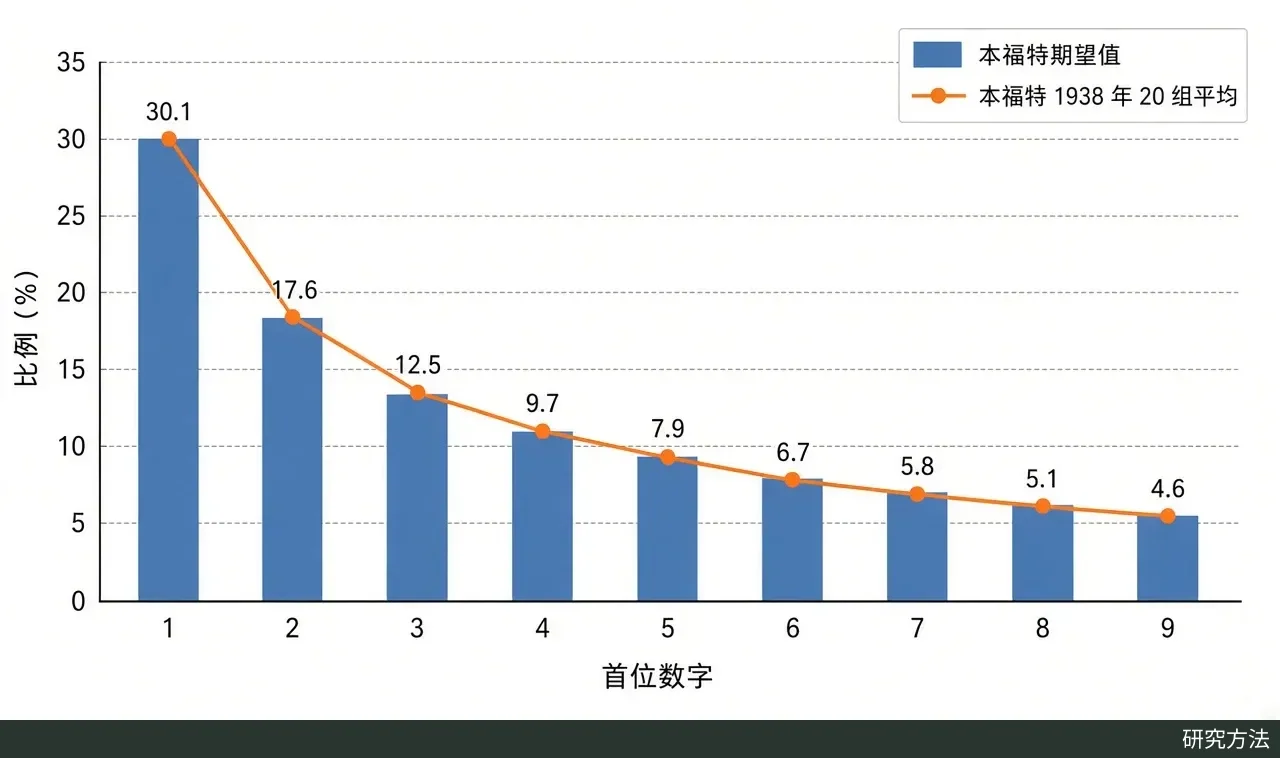
首位数字的期望比例(柱形,按 log₁₀(1 + 1/d) 计算)与本福特 1938 年论文表 I 中 20 组数据的平均值(圆点)。数据来源:Benford(1938);本文用 Python 代码绘制。
财务与选举数据中的应用
把这条规律当作检查工具,思路出现在 1970 年代。据希尔 1995 年的回顾,经济学家哈尔·范里安(Hal Varian)在 1972 年提出,可以用数据与对数分布的拟合程度来检验模型输出是否合理。会计学者马克·尼格里尼(Mark Nigrini)则把它系统地用到了税务数据上。他 1996 年发表于《美国税务协会杂志》的研究区分了两种逃税:报税时临时编造数字的“无计划逃税”,以及事先掩盖审计线索的“有计划逃税”。他的前提是,如实申报的数字和经过精心安排的数字都应符合本福特分布,临时编造的数字则会留下偏差。分析美国国税局的个人税务样本文件后,他得出结论:低收入纳税人临时编造数字的程度高于高收入纳税人。
这类检验很快进入实务。希尔在 1995 年的论文中转述了《华尔街日报》同年 7 月的报道:纽约布鲁克林地区检察官办公室使用尼格里尼的本福特拟合检验,查出并起诉了涉及 7 家纽约公司的舞弊团伙。Durtschi 等人 2004 年为审计人员撰写的指南认为,大多数会计数据适合做这种检查,因为应收账款、应付账款和多数收入、费用科目都由“数量乘以单价”这类运算组合而成。他们还建议分析整个账户而不是抽样,因为数据越多,结果越可靠。
选举数据是另一个应用场景,争议也更大。政治学者沃尔特·米巴恩(Walter Mebane)从 2006 年起提出检验选区计票数的第二位数字,常称“2BL 检验”。他当时就说明,这种检验不能发现所有类型的舞弊,没有舞弊的计票数也可能得到显著结果。他主张不看首位数字,理由之一来自布雷迪(Henry Brady)2005 年举的例子:如果两名候选人势均力敌,各选区规模在 100 到 1000 人之间,每名候选人得票数最常见的首位数字是 4、5 或 6,而不是 1 或 2。
2011 年,德克特(Joseph Deckert)、米亚格科夫(Mikhail Myagkov)和奥德舒克(Peter Ordeshook)在《政治分析》上发表文章,用模拟的公平与舞弊选举,以及经其他调查确认存在或基本不存在舞弊的真实选举做检验。他们的结论是:数据是否符合本福特定律,与选举是否舞弊之间看不出规律,判断的“成功率”大致相当于抛硬币。米巴恩在同期评论中批评了他们的模拟设计和数据汇总层级,但也同意,第二位数字的均值显著偏离 4.187 本身不能作为舞弊的证据;这类检验是否有用仍是开放问题,需要结合真实选举的特点来设定期望。
不适用的数据与检验的边界
本福特分布适合跨越多个数量级、由多种因素组合产生的数据。Durtschi 等人列出了几类通常不符合的数据。第一类是分配的号码,例如支票号、发票号和邮政编码,它们按顺序或规则发放,首位数字更接近均匀分布。第二类是受人为设定影响的数字,例如定在 1.99 美元这类心理价位下的价格,或 ATM 取款这类预设的整数金额。第三类是带有内置下限或上限的截断数据,例如只有超过重要性门槛才入账的资产清单。前面布雷迪的选区例子也属于这一类:选区规模把票数限制在不到一个数量级的范围内,首位数字自然集中在中间几个。他们还提到一个粗略的判断方法:若一组数据的均值大于中位数且呈正偏态,它更可能符合本福特分布。下图用模拟数据对比了三种情形。
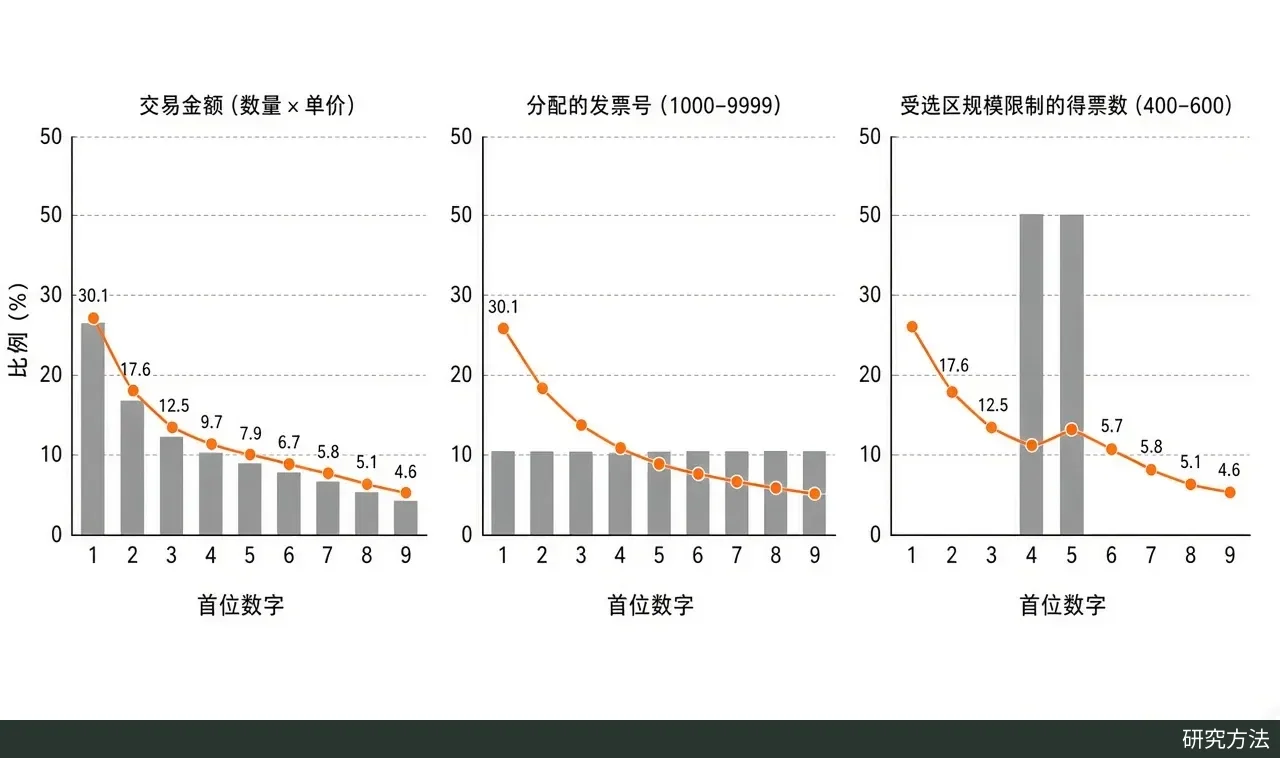
三种模拟数据的首位数字分布,橙线为本福特期望比例。左:数量乘以单价得到的交易金额;中:在 1000–9999 中均匀分配的发票号;右:被选区规模限制在 400–600 的得票数。模拟数据,本文用 Python 代码绘制。
即使数据类型合适,偏离本福特分布也不能单独证明造假。偏离可能来自正常的业务规则、四舍五入、入账门槛和定价习惯;反过来,符合分布也不说明数据干净。尼格里尼的研究本身就假定,精心安排的“有计划逃税”数字仍会符合本福特分布。Durtschi 等人也指出,盗窃、回扣、串通投标这类根本没有入账的舞弊,数字分析无从发现;设定“偏离多少才算可疑”时,还要同时权衡误报和漏报的代价。选举领域的争论则说明,连“没有舞弊的计票数应当长什么样”都还没有公认的模型。
因此,本福特检验更适合当作筛查工具:先判断这类数据是否应当服从该分布,再看偏差集中在哪些数字、哪些账户或选区,最后用凭证核对、现场调查等独立证据确认。米巴恩在 2006 年的文章中说过,对一个只能拿计票数本身做文章的检验,或许不应期望太多。
本文两幅统计图可用下面的 Python 代码复现,需要 NumPy 和 Matplotlib;本福特 1938 年的平均值取自其论文表 I 的末行。
import numpy as np
import matplotlib.pyplot as plt

plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC", "Microsoft YaHei", "SimHei", "DejaVu Sans"]
plt.rcParams["axes.unicode_minus"] = False

digits = np.arange(1, 10)
benford = np.log10(1 + 1 / digits)
# Average row of Table I in Benford (1938), in percent
benford_1938 = np.array([30.6, 18.5, 12.4, 9.4, 8.0, 6.4, 5.1, 4.9, 4.7])


def first_digit(x):
    x = np.asarray(x, dtype=float)
    x = x[x > 0]
    # Small offset guards against log10(1000) evaluating to 2.999...
    scaled = x / 10 ** np.floor(np.log10(x) + 1e-12)
    return np.clip(scaled.astype(int), 1, 9)


def digit_share(x):
    d = first_digit(x)
    return np.array([(d == k).mean() for k in digits])


# Figure 1: expected shares vs. Benford's 1938 average
fig, ax = plt.subplots(figsize=(7, 4))
bars = ax.bar(digits, benford * 100, color="#4C72B0", label="本福特期望值")
ax.bar_label(bars, fmt="%.1f")
ax.plot(digits, benford_1938, "o-", color="#DD8452", label="本福特 1938 年 20 组平均")
ax.set_xticks(digits)
ax.set_xlabel("首位数字")
ax.set_ylabel("比例(%)")
ax.legend()
fig.tight_layout()
fig.savefig("benford_expected.png", dpi=200)

# Figure 2: three simulated datasets
rng = np.random.default_rng(1938)
n = 10_000
amounts = rng.integers(1, 51, n) * rng.lognormal(mean=3, sigma=1.2, size=n)
invoices = rng.integers(1000, 10000, n)
votes = np.round(1000 * rng.uniform(0.40, 0.60, n))
panels = [
    ("交易金额(数量×单价)", amounts),
    ("分配的发票号(1000–9999)", invoices),
    ("受选区规模限制的得票数(400–600)", votes),
]

fig, axes = plt.subplots(1, 3, figsize=(12, 3.8), sharey=True)
for ax, (title, data) in zip(axes, panels):
    ax.bar(digits, digit_share(data) * 100, color="#8C8C8C")
    ax.plot(digits, benford * 100, "o-", color="#DD8452")
    ax.set_title(title)
    ax.set_xticks(digits)
    ax.set_xlabel("首位数字")
axes[0].set_ylabel("比例(%)")
fig.tight_layout()
fig.savefig("benford_compare.png", dpi=200)